Note de cercetare MuscleTiger · Nr. 5
Căutarea alimentelor în orice limbă: traducerea interogărilor, îmbinarea bazelor de date și rezultatele măsurătorilor
Scrii „Spiegelei mit Speck” sau „борщ з м’ясом” într-un jurnal alimentar și te aștepți să vezi un produs cu calorii și macronutrienți. Cele mai mari baze de date deschise cu alimente sunt scrise în mare parte în engleză și franceză, în timp ce oamenii caută în limba lor, cu nume de mărci, terminații de cuvinte și greșeli de tastare. Această notă descrie cum am construit căutarea alimentelor în MuscleTiger, ce am încercat, ce s-a dovedit inutil și ce am măsurat.
Pe scurt
Căutarea noastră de alimente găsește alimentul căutat pentru 92% dintre interogări în nouă limbi (secțiunea 3). Căutăm în patru liste deodată (baza noastră de alimente în engleză și în limba utilizatorului, și Open Food Facts în limba utilizatorului și în engleză) și combinăm clasamentele prin reciprocal rank fusion. O interogare într-o altă limbă este mai întâi tradusă în engleză. Am folosit mai întâi un traducător neuronal care rulează pe dispozitiv, apoi l-am înlocuit cu un dicționar mic, învățat din numele paralele ale alimentelor din baza noastră, cu un aliniator de cuvinte din familia IBM Model 2 cu un prior bayesian, și din taxonomiile Open Food Facts. Pe interogările noastre de test, dicționarul reproduce traducerea de referință în engleză cu un F1 al rădăcinilor cuvintelor de 0.94 (germană) și 0.96 (ucraineană); aceasta măsoară traducerea interogărilor scurte și simple. Cu traduceri corecte, adăugarea listei în engleză ridică ponderea interogărilor în ucraineană cu produsul corect în primele cinci cu 61 de puncte, iar celelalte limbi adaugă puțin. Ponderile celor patru liste, care depind de cât de mare este limba în Open Food Facts, au îmbunătățit rezultatele pentru germană și nu le-au schimbat pentru ucraineană. Un mecanism de rezervă pentru greșelile de tastare din traducător recuperează aproximativ jumătate din cele 15 puncte pe care le costă o greșeală.
Explicăm abordarea și familiile de metode pe care le-am luat în considerare.
1. Problema: o interogare într-o limbă, date în mai multe
Căutarea alimentelor trebuie să facă trei lucruri bine, deodată. Trebuie să înțeleagă o interogare scurtă și neordonată („chicken breast 200g”, „coca cola zero”, „мигдальне молоко”). Trebuie să găsească un produs cu valori nutriționale complete și plauzibile. Și trebuie să funcționeze în limba persoanei, pe telefon, rapid și, idealmente, offline.
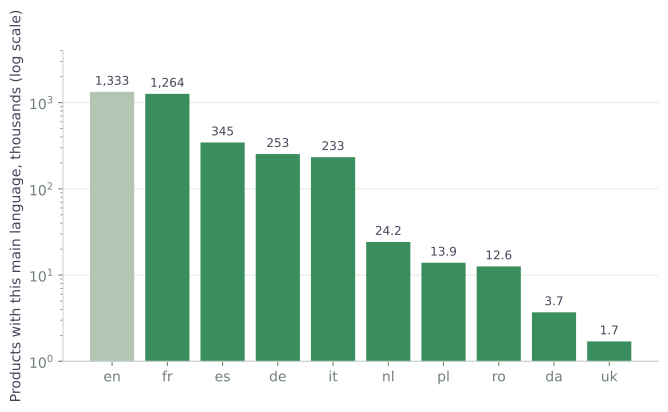
Datele pe care le putem folosi sunt neuniforme. Open Food Facts (OFF) [6], baza deschisă de produse ambalate, cuprinde milioane de produse, dar limba unui produs urmează țara în care se vinde și obiceiurile contribuitorilor săi. Numărând produsele după limba principală (OFF, 15 noiembrie 2026), engleza și franceza conduc cu aproximativ 1.3 milioane de produse fiecare, spaniola, germana și italiana urmează cu 230 până la 350 de mii, iar limbile mai mici pe care le susținem au între 1.7 și 25 de mii (Figura 1). O interogare în ucraineană poate fi deci răspunsă în ucraineană de foarte puține produse, pe când o interogare în franceză întâlnește o bază de date care, de la început, este în mare parte franceză.
Baza noastră
A doua sursă este baza noastră de alimente cu energie și macronutrienți complete. Este o îmbinare a mai multor tabele naționale de compoziție a alimentelor, alese pentru că sunt deschise, măsurate în laboratoare și complete în macronutrienți. Multe dintre alimentele ei au porții casnice, precum „1 felie”. Un aliment este omis atunci când în bază există deja unul cu același nume, iar rândurile noi se adaugă întotdeauna după cele vechi, astfel încât numărul unui produs și traducerile lui nu se schimbă niciodată când se adaugă un tabel.
Când am adăugat ulterior trei tabele, ponderea interogărilor de test cu produsul corect în primele cinci a crescut cu 3 puncte, iar pe primul loc cu 2 puncte; niciuna dintre schimbări nu este semnificativă. Câștigul a venit mai ales din preparate comune pe care tabelele noi le descriu în engleză simplă, precum lasagna, cappuccino sau Greek yoghurt. Am lăsat deoparte un tabel candidat, pentru că licența lui conține o condiție de distribuire sub aceleași condiții, care s-ar putea extinde asupra bazei noastre îmbinate.
Tabelele sunt scrise în engleză sau în limba țării lor, așa că numele în celelalte limbi au trebuit făcute. Numele în engleză sunt cele originale; numele în celelalte limbi au fost produse prin traducere automată și, în parte, refăcute ulterior de agenți bazați pe modele de limbaj, cu verificări automate (un validator respinge un răspuns care schimbă cifrele, unitățile sau structura numelui). Cifrele din nume folosesc punct zecimal în toate limbile, atât în bază, cât și în interogare, pentru ca o interogare cu un procent de grăsime să poată prefera produsul cu acel procent.
2. Patru liste și un singur clasament
Modelul pe care îl folosim este simplu de descris. Fiecare interogare este căutată în patru locuri:
- A: baza noastră locală, cu interogarea tradusă în engleză;
- B: baza noastră locală, cu interogarea așa cum o scrie utilizatorul în limba lui;
- C: Open Food Facts, căutat în limba utilizatorului;
- D: Open Food Facts, căutat cu traducerea în engleză.
Fiecare listă își returnează propriul clasament, iar clasamentele sunt combinate prin reciprocal rank fusion (RRF) [3]. Un produs care apare aproape de vârf în mai multe liste câștigă în fața unui produs care este primul doar într-o singură listă:
unde este poziția produsului în lista , este ponderea listei, iar este o constantă mică, ce împiedică primul loc să domine. Metoda nu are nevoie de scorurile listelor, doar de ordinea lor, ceea ce contează pentru că listele vin din sisteme diferite cu scoruri incomparabile. Am ales-o tocmai din acest motiv; Cormack et al. raportează că ea este competitivă cu metode mai elaborate de învățare a clasamentelor, în experimentele lor [3].
RRF este o metodă publicată, iar contribuția noastră este măsurătoarea: ce liste să includem, cum să traducem interogarea și cât de mult să avem încredere în fiecare listă în fiecare limbă.
3. Cum am măsurat
Protocolul:
- Am scris seturi de interogări din mai multe tipuri: marcă plus produs, preparat, aliment de zi cu zi, băutură, și informale sau cu greșeli. Un set are 959 de interogări, dintre care 200 au fost judecate în detaliu; al doilea set are 200 de interogări, 100 în germană și 100 în ucraineană, cu câte 20 din fiecare tip. Un set separat de preparate din bucătării străine (de exemplu un preparat japonez cerut în germană) testează dacă limba interogării trebuie să urmeze preparatul.
- Pentru fiecare interogare am adunat rezultatele de sus ale fiecărei configurații, iar un model de limbaj a judecat fiecare candidat ca relevant sau nu, văzând interogarea și traducerea în engleză, dar nu și configurația care a returnat candidatul. Evaluatorul nu putea deci să favorizeze o metodă.
- Raportăm top-1 (produsul corect este primul), top-5 (este printre primele cinci) și MRR, media lui pentru primul rezultat relevant. Pentru comparațiile între configurații asociem rezultatele pe interogare și folosim teste de semn și intervale bootstrap.
Acuratețea întregii căutări
Cifra din rezumat provine dintr-un test al căutării exact așa cum funcționează în aplicație. Am scris câte zece interogări în fiecare dintre cele nouă limbi pe care aplicația le acceptă în afară de engleză, câte două din fiecare tip, 90 de interogări în total. Fiecare interogare a trecut prin aceiași pași ca pe un telefon: traducerea cu dicționarul, baza noastră în engleză și în limba interogării, Open Food Facts în ambele limbi, cu produsele vândute în țara acelei limbi aduse în față, și fuziunea cu ponderile aplicației. Am citit întreaga listă combinată a fiecărei interogări, în medie cam șaizeci de rezultate, și am marcat de mână primul rezultat pe care un utilizator l-ar accepta drept alimentul căutat, după aceleași reguli ca evaluatorul orb.
| Alimentul căutat este găsit | Toate interogările (90) | Produse simple (65) | Feluri de mâncare (25) |
|---|---|---|---|
| oriunde în listă | 92.2% | 93.8% | 88.0% |
| printre primele zece | 90.0% | 90.8% | 88.0% |
| printre primele cinci | 85.6% | 86.2% | 84.0% |
| pe primul loc | 66.7% | 67.7% | 64.0% |
Acuratețea întregii căutări. Câte zece interogări în fiecare dintre cele nouă limbi, căutate ca în aplicație. Produsele simple sunt alimente, produse ambalate și băuturi; felurile de mâncare includ și mese compuse, precum un sandviș cu brânză sau fulgi de ovăz cu lapte.
Alimentul căutat se află undeva în listă pentru 92% dintre interogări, printre primele zece rezultate pentru 90%, printre primele cinci pentru 86% și pe primul loc pentru 67%. Produsele simple sunt găsite ceva mai des decât felurile de mâncare (94% față de 88% oriunde în listă). Ratările sunt mai ales produse de marcă pe care nu le conține nicio listă și gustări făcute din mai multe alimente, pentru care listele oferă ingredientele, dar nu gustarea însăși. Zece interogări pe limbă sunt o bază mică: o singură interogare mută rezultatul unei limbi cu zece puncte, așa că cifrele descriu căutarea în ansamblu și spun puțin despre o limbă anume. Secțiunile următoare desfac căutarea în părți și măsoară fiecare pas pe seturi mai mari de interogări în germană și ucraineană.
4. Ce face o traducere corectă pentru căutare
Înainte să descriem încercările noastre de a construi un traducător bun, am măsurat cât valorează o traducere bună. Am scris 100 de interogări de alimente în ucraineană (câte 20 din fiecare: alimente de zi cu zi, preparate, băuturi, mărci și interogări informale) și le-am tradus manual în celelalte nouă limbi, astfel încât traducerea este corectă prin construcție. Pentru fiecare limbă am căutat în Open Food Facts cu interogarea în acea limbă și am combinat listele prin reciprocal rank fusion (ecuația 1, ponderi egale). Prima configurație este doar ucraineana, a doua adaugă engleza, apoi am adăugat franceza, spaniola, germana, italiana, neerlandeza, poloneza, româna și daneza, în ordinea numărului de produse ale fiecărei limbi în OFF (Figura 2). Relevanța a fost judecată orbește de un model de limbaj, cu regulile din secțiunea 3, pe primele cinci rezultate adunate din fiecare configurație.
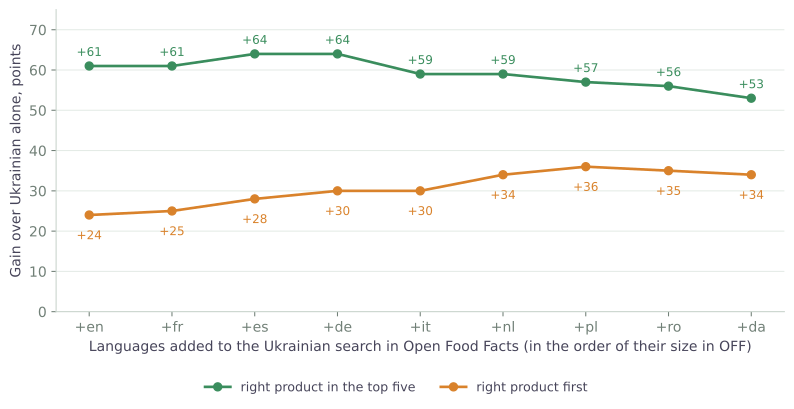
Primul pas este de departe cel mai mare. Căutarea în OFF doar în ucraineană adesea nu găsește nimic: OFF are puține produse în limba ucraineană (Figura 1), iar pentru 47 din cele 100 de interogări lista în ucraineană a fost goală. Adăugarea traducerii în engleză ridică ponderea interogărilor cu produsul corect în primele cinci cu 61 de puncte și pe primul loc cu 24 de puncte, cu 61 de interogări câștigate și niciuna pierdută.
Limbile următoare schimbă puțin. Franceza nu schimbă primele cinci (5 interogări câștigate, 5 pierdute). Spaniola și germana adaugă încă 3 puncte, în limitele zgomotului. După aceea primele cinci scad, cu 11 puncte sub vârful atins, la toate cele zece limbi, în timp ce primul loc crește încă cu 10 până la 12 puncte. Scăderea de la patru la zece limbi în primele cinci este semnificativă pe aceste interogări (2 câștigate, 13 pierdute, test de semn p = 0.007); creșterea primului loc de la două la zece limbi nu este (20 câștigate, 10 pierdute, p = 0.10). Mărcile se comportă altfel decât alimentele de zi cu zi: cu mai multe liste, o interogare despre o marcă este găsită mai des (cu 15 puncte mai mult în primele cinci cu spaniola adăugată decât doar cu engleza), în timp ce alimentele de zi cu zi sunt găsite mai rar (cu 25 de puncte mai puțin cu zece limbi decât cu engleza). Douăzeci de interogări pe tip este o bază mică, deci aceste împărțiri sunt orientative.
O traducere corectă în engleză poartă efectul. Fiecare limbă în plus este o nouă cerere către OFF și, după primele câteva, diluează clasamentul.
Preparate dintr-o altă bucătărie
Pasul către engleză contează cel mai mult când preparatul vine dintr-o altă bucătărie. Un set separat de 100 de interogări, câte zece în fiecare dintre cele zece limbi, a numit un preparat străin cunoscut așa cum l-ar scrie un utilizator: Borschtsch pentru un utilizator german, paella, pierogi, tiramisu, stroopwafel, sarmale. Acesta este un experiment mai vechi, iar interogările au fost traduse de traducătorul neuronal pe care îl folosea atunci aplicația (secțiunea 5). Pentru cele 90 de interogări non-engleze, traducerea interogării în engleză a ridicat ponderea celor cu preparatul în primele cinci cu 34 de puncte, față de căutarea în Open Food Facts în propria limbă a utilizatorului (47 de interogări câștigate, niciuna pierdută, p < 0.001). Adăugarea altor limbi după engleză nu a schimbat nimic în primele cinci, chiar și atunci când am ales dinainte limba țării de unde provine preparatul.
Baza noastră locală a ajutat aici: fără lista ei în engleză, primul loc a scăzut cu 8 puncte pentru aceste interogări (7 pierdute, niciuna câștigată, p = 0.016), pentru că baza cunoaște paella, ratatouille sau lasagna și le așază pe primul loc. Pentru alimentele de zi cu zi nu a arătat un asemenea beneficiu, dar înlăturarea ei nu a făcut căutarea mai bună nici ea (secțiunea 10), așa că o păstrăm. Greșelile rămase sunt preparate pe care nicio listă OFF nu le are sub niciun nume, precum sarmale. Setul are doar vreo douăzeci de preparate distincte, așa că descrie bine preparatele cunoscute și spune puțin despre cele rare.
Potrivirea a contat mai mult decât limbile
Cea mai mare îmbunătățire singulară din tot studiul a venit din potrivirea cuvintelor în baza locală, fără nicio traducere implicată. Baza locală este căutată cu propria ei potrivire, iar cuvintele funcționale, terminațiile de caz și virgulele zecimale o stricau: „soup with mushrooms” în ucraineană nu returna nimic, pentru că potrivirea cerea ca fiecare cuvânt al interogării să fie găsit exact așa cum fusese scris. Ponderarea cuvintelor interogării după cât de rare sunt (IDF), un stemmer Snowball pentru limbile care îl au și un singur format de numere au îmbunătățit top-5 pe setul standard cu aproximativ 9% de la începutul studiului (test de semn p = 0.008), iar pe interogările cu prepoziții și forme de cuvinte cu aproximativ 12%.
5. De ce am înlocuit traducătorul
Am scos ML Kit pentru că traduce slab numele alimentelor. Este un traducător universal, construit pentru propoziții, iar un nume de aliment este câteva cuvinte fără context: o marcă, o stare a produsului, un preparat numit după un loc. Baza noastră a fost tradusă mai întâi cu el, iar acestea sunt intrări reale (traducerile în ucraineană și franceză, cu o explicație pentru cititorii care nu vorbesc limba):
| Numele în engleză | Rezultatul ML Kit | Ce a mers prost |
|---|---|---|
| plain, refrigerated | рівнина, холодильна (ucraineană) | „plain” aici înseamnă nearomat, ca în plain yoghurt, dar a fost tradus ca „plain” în sensul de câmpie; „refrigerated” a devenit un adjectiv care înseamnă „al unui frigider” |
| boneless | безкімнатний (ucraineană) | înseamnă „fără camere”; sensul dorit este „fără os” |
| Pad Thai | Подушка тайська (ucraineană) | numele preparatului a fost citit ca cuvinte: „pernă thailandeză” |
| Rice flour, brown | Рисова борошно, коричневий (ucraineană) | adjectivele nu se acordă cu substantivul „flour”, ceea ce este agramatical în ucraineană |
| Meringue with chocolate; Ham salad spread | lăsat parțial sau complet netradus (ucraineană) | cuvintele engleze rămân în nume |
| bun | chignon (franceză) | un coc de păr (coafura), unde se voia chifla de pâine |
| sauerkraut | chouchoune (franceză) | un alt cuvânt; cuvântul francez pentru varză murată este choucroute |
Aceeași slăbiciune apare la interogări, unde un cuvânt greșit înseamnă un produs lipsă, iar ea nu poate fi reparată local: nu poți corecta un cuvânt dintr-un model neuronal. Au existat două motive mai mici: modelele ocupă aproximativ 40 MB pe limbă, iar SDK-ul este o componentă a unui terț.
Datele pe care le deținem indică un instrument mai bun. Baza noastră are perechi de un nume în engleză și numele lui în fiecare limbă, un corpus paralel exact în domeniul de care avem nevoie. Un dicționar poate fi învățat dintr-un asemenea corpus.
6. Un dicționar învățat prin aliniere de cuvinte
Învățarea unui dicționar din text paralel este vechea problemă a alinierii de cuvinte: a decide ce cuvânt dintr-o propoziție corespunde cărui cuvânt din cealaltă. Familia clasică este cea a modelelor IBM din traducerea automată statistică [1]. Modelul 1, cel mai simplu și punctul nostru de plecare, tratează un nume dintr-o limbă ca generat din cuvintele celeilalte, fără a ține seama de ordine. Pentru un nume în engleză și un nume într-o altă limbă (cu un cuvânt vid adăugat), probabilitatea perechii este
iar tabelul probabilităților de traducere a cuvintelor , adică dicționarul, se estimează prin expectare–maximizare: în fiecare rundă, fiecare pereche de cuvinte dintr-o pereche de nume primește o parte din numărare proporțională cu probabilitatea curentă, iar părțile sunt normalizate în probabilități noi. Pentru un nume scurt de aliment aceasta se potrivește bine, pentru că există puțină ordine a cuvintelor de modelat. Slăbiciunea cunoscută a fost descrisă de Moore [2]: un cuvânt rar poate lua orice probabilitate care se potrivește cu propoziția lui unică, astfel că cuvintele rare devin „colectori de gunoi” care se aliniază cu prea multe cuvinte. Moore a propus netezirea numărărilor și o inițializare mai bună; un prior bayesian asupra probabilităților de traducere, aplicat prin inferență variațională, este un alt remediu [7].
Ce am luat în considerare și am măsurat
Am comparat aliniatorul nostru cu variantele sale fără o componentă, cu implementările de referință ale două aliniatoare publicate și cu o metodă care nu are deloc model de aliniere. Fiecare metodă a primit aceleași perechi de nume, aceleași 5% de date rezervate și același mod de a transforma alinierile în dicționar (o pereche de cuvinte contează dacă este legată de cel puțin două ori; fiecare cuvânt primește cea mai frecventă traducere a lui). Calitatea este F1-ul rădăcinilor cuvintelor între traducerea din dicționar a unui nume rezervat, cuvânt cu cuvânt, și numele lui în engleză, mediat pe nouă limbi (Tabelul 1). Diferențele sunt mici, așa că raportăm și în câte dintre cele nouă limbi o diferență este clară (intervalul bootstrap de 95% al diferenței asociate nu include zero).
| Metodă | Ce este | F1 mediu | Față de ale noastre |
|---|---|---|---|
| Dice coefficient | fără model de aliniere, fiecare cuvânt se leagă de cuvântul cu care co-apare cel mai des | 0.812 | mai slab în 7 din 9 |
| IBM Model 1 [1], EM | probabilități de traducere a cuvintelor, fără ordinea cuvintelor | 0.817 | mai slab în 6 din 9 |
| Model 1 cu un prior Dirichlet [7] | variational Bayes asupra probabilităților de traducere | 0.822 | mai slab în 4 din 9 |
| Prior de aliniere diagonală, EM | Modelul 2 în parametrizarea fast_align [5], fără priorul bayesian | 0.822 | mai slab în 6 din 9 |
| Ale noastre | prior diagonal și prior Dirichlet, două direcții, intersecție | 0.825 | – |
| Ale noastre, grow-diag-final-and | același lucru, legăturile ambelor direcții combinate prin euristica standard | 0.828 | mai bun în 5 din 9, mai slab în 1 |
| fast_align [5] | implementarea autorilor, intersecție / grow-diag-final-and | 0.826 / 0.831 | 3 mai bune, 2 mai slabe / 7 mai bune |
| eflomal [8] | HMM cu fertilitate, bayesian, eșantionare MCMC; intersecție / grow-diag-final-and | 0.825 / 0.828 | 2 mai bune, 2 mai slabe / 7 mai bune |
| SimAlign [10] | încorporări BERT multilingve, fără antrenare pe numele noastre; trei metode de potrivire (cea mai bună / iterativă / intersecție) | 0.824 / 0.822 / 0.812 | 2 mai bune, 2 mai slabe / 1 mai bună, 3 mai slabe / mai slab în 8 |
Tabelul 1. Aliniatoare comparate pe numele rezervate din baza noastră, nouă limbi. Ultima coloană numără limbile în care diferența față de ale noastre este clară. fast_align și eflomal sunt implementările autorilor.
Coeficientul Dice simplu rămâne doar cu 0.013 în urma noastră, iar SimAlign, care nu are nevoie de antrenare pe numele noastre, este egal cu al nostru la cea mai bună setare. Pe nume scurte, aproape paralele, alegerea aliniatorului contează puțin, iar cea mai mare parte a calității vine din numele înseși. Fiecare ingredient al nostru adaugă puțin, iar fast_align real cu aceeași intersecție dă același rezultat (0.826 față de 0.825), ceea ce ne așteptam de la o metodă cu aceeași construcție. Combinarea celor două direcții cu euristica standard grow-diag-final-and, în locul intersecției, ajută aproximativ tot atât cât alegerea modelului: între un sfert și jumătate de punct de F1 pentru toate cele trei. Este un câștig mic, clar în majoritatea limbilor, și plănuim să-l folosim data viitoare când dicționarele vor fi reconstruite.
Reducerea cuvintelor la rădăcini Snowball înainte de aliniere scade F1 (0.818, mai slab în 6 din 9 limbi), iar păstrarea doar primelor patru litere ale fiecărui cuvânt, pe care Östling și Tiedemann o raportează ca o rădăcinare aproximativă utilă pentru traducerea automată [8], o scade și mai mult (0.743). Sarcina explică diferența: Östling și Tiedemann măsoară sisteme de traducere construite pe alinieri, iar noi căutăm cuvinte singulare dintr-un nume de aliment într-un dicționar, unde unirea formelor de cuvinte unește alimente diferite.
Nu am rulat eșantionatorul Gibbs al lui Mermer și Saraçlar [9] (un Model 1 complet bayesian), nici modelele IBM 3–5, nici interogările structurate probabilistice ale lui Darwish și Oard [4], care păstrează mai multe traduceri pentru fiecare cuvânt. Ultima este un posibil pas următor, deoarece dicționarul nostru păstrează doar cel mai bun candidat.
Ce este aliniatorul nostru
Aliniatorul nostru este propria noastră implementare a unui IBM Model 2 în parametrizarea fast_align [5]: probabilitatea ca un cuvânt să fie aliniat la o poziție dată scade odată cu distanța față de diagonală (în Modelul 1 este uniformă), pentru că numele de alimente tind să-și păstreze ordinea cuvintelor între limbi. Peste aceasta, probabilitățile de traducere a cuvintelor primesc un prior Dirichlet rar, cu inferență variațională [7], ca în fast_align, care împiedică cuvintele rare să absoarbă probabilitate. Constantele fixe (probabilitatea de a alinia un cuvânt cu nimic, puterea priorului și panta inițială a diagonalei) sunt cele raportate de Dyer et al.; fast_align reestimează și panta în timpul antrenării, iar noi nu. Este antrenat în ambele direcții, iar sunt păstrate doar legăturile în care cele două direcții sunt de acord (intersecție), ceea ce crește precizia cu un cost al acoperirii. Cuvintele sunt aliniate în forma lor exactă, fără rădăcinare: reducerea cuvintelor la rădăcini, obișnuită pentru limbile cu terminații bogate, a scăzut acuratețea în primele noastre încercări, așa că cuvintele compuse și cele cu cratimă sunt tratate prin expresii.
Rezultatul este un dicționar în trei straturi, pe care traducătorul îl aplică de la cea mai lungă potrivire de până la trei cuvinte: intrări din taxonomie, expresii aliniate în baza noastră și cuvinte singulare aliniate în baza noastră. Un cuvânt care nu este în dicționar, precum o marcă sau o greșeală de scriere, trece neschimbat, pentru că OFF îl cunoaște adesea. Fiecare limbă este un fișier de câteva sute de kilobytes, față de aproximativ 40 MB pe limbă pentru modelele neuronale. Funcționează offline, iar fiecare traducere poate fi urmărită până la o linie din dicționar și corectată.
Cât de bună este traducerea
Măsurăm traducătorul în două feluri. Pe 5% din perechile de nume scoase din antrenare, traducând numele străin cuvânt cu cuvânt și comparând rezultatul cu numele în engleză prin rădăcinile cuvintelor, se obține un F1 între 0.78 și 0.90 pe cele nouă limbi. Pe interogările de evaluare, pentru care am scris o traducere de referință în engleză împreună cu fiecare interogare, F1 al rădăcinilor cuvintelor este 0.94 pentru germană (88 din 100 de interogări identice în rădăcini) și 0.96 pentru ucraineană (89 din 100).
Aceste cifre descriu traducerea interogărilor scurte și frecvente în engleză. Calitatea căutării în sine este mai mică și este măsurată separat (secțiunile 3 și 9). Nu am rulat vechiul traducător neuronal pe aceleași interogări, deci nu afirmăm că dicționarul este mai bun decât ML Kit; el este suficient de precis pentru aceste interogări, mic, offline și poate fi corectat.
7. Taxonomiile Open Food Facts: ce oferă și ce costă
OFF întreține taxonomii publice de ingrediente și de categorii: liste ierarhice în care fiecare intrare are un nume în engleză și nume și sinonime în multe limbi, scrise de voluntari. Au mii de intrări cu un nume în engleză și sunt atractive din trei motive: traducerile sunt făcute de oameni și în domeniul alimentelor, conțin cuvinte pe care numele noastre nu le folosesc niciodată (ingrediente rare) și sunt independente de traducerea automată care a produs numele noastre.
Dificultățile:
- Acoperire neuniformă. Ponderea intrărilor cu un nume într-o limbă dată variază de la 1.6% (categoriile în ucraineană) la 84.6% (categoriile în franceză), deci taxonomia nu poate fi singura sursă. O aplicăm întâi acolo unde există o intrare și lăsăm dicționarul din baza noastră să completeze restul.
- Nume în stil de categorie și multe sinonime. O intrare are un nume în engleză și multe sinonime într-o limbă. Fiecare sinonim este asociat cu numele principal în engleză, iar numele în engleză foarte lungi sunt omise.
- Expresii, nu doar cuvinte. Numele din taxonomie sunt expresii, așa că traducătorul caută cea mai lungă expresie din fiecare poziție înaintea cuvintelor singulare.
- Zgomot. Când taxonomia este folosită și ca date de antrenare, expresiile ei în stil de categorie concurează cu expresiile idiomatice din baza noastră. A trebuit măsurată o pondere pentru perechile din taxonomie. O pondere prea mare a pierdut acuratețe la cuvintele comune, iar intervalul care funcționează este îngust.
Antrenarea pe taxonomie: un test care nu putea vedea efectul
Primul nostru test al adăugării perechilor din taxonomie la antrenarea alinierii nu a arătat nimic. L-am măsurat pe perechi de nume rezervate din baza noastră și pe interogările noastre, iar calitatea traducerii s-a mișcat cel mult cu câteva miimi. Aproape am concluzionat că taxonomia este utilă doar ca tabel de căutare. Testul acela nu putea vedea efectul: ambele seturi conțin cuvinte pe care baza noastră le știe deja, în timp ce rostul taxonomiei este să adauge cuvinte pe care ea nu le are.
Testul corect elimină o zecime din intrările taxonomiei din stratul de căutare și din antrenare, construiește dicționarul cu și fără antrenarea pe taxonomie și traduce numele intrărilor eliminate. Pentru limbile cu o taxonomie mare, antrenarea adaugă două până la patru puncte de F1 pe toate numele rezervate și patru până la cinci puncte pe numele cu un cuvânt pe care baza noastră nu-l are, fără pierderi la numele formate din cuvinte cunoscute (Figura 3). Pentru limbile cu o taxonomie mică, precum ucraineana și româna, nimic nu se schimbă. Am inversat recomandarea noastră timpurie, iar dicționarele din aplicație sunt construite cu antrenare pe taxonomie.
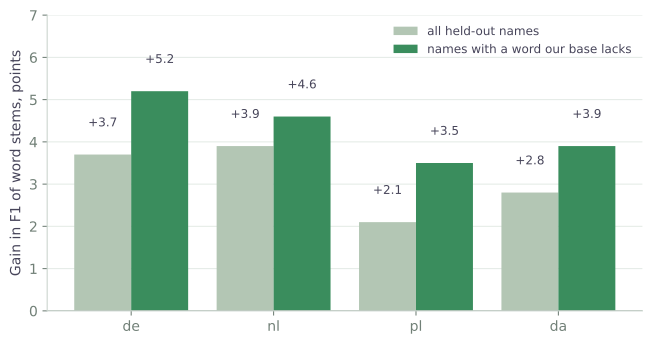
Unde poate face rău. Numele din taxonomie au stil de categorie, iar sinonimele lor pot înlocui o expresie idiomatică învățată din baza noastră („home fries” pentru un preparat din cartofi prăjiți). Pe interogările în germană, aceasta a costat aproximativ un punct de F1 și nimic pentru ucraineană, un preț pe care l-am acceptat pentru câștigul la cuvintele rare.
8. Ponderile celor patru liste pe limbă
În ecuația (1) fiecare listă are o pondere. Primele noastre ponderi erau aceleași pentru toate limbile, reglate pe un singur set de interogări. Dar calitatea listelor diferă între limbi. Lista nativă OFF C este bogată în franceză sau germană și slabă în ucraineană, unde lista în engleză D poartă mai multă greutate. A oferi fiecărei limbi propriile ponderi este o idee firească, iar întrebarea este de unde le luăm pentru zece limbi, când avem interogări de test pentru două.
Am luat în considerare două măsuri. Prima a fost ponderea intrărilor din taxonomie care au un nume în limbă. Este ușor de calculat, dar măsoară cât de bine au tradus voluntarii vocabularul, ceea ce influențează dicționarul, și spune puțin despre câte produse au un nume în acea limbă; cele două coloane ale ei chiar se contrazic (italiana: 75% din ingrediente și 28% din categorii). Nu am folosit-o. A doua a fost numărul de produse OFF pe limbă, raportat la engleză, disponibil din serviciul de căutare (Figura 1). Este un indicator, pentru că limba principală a unui produs poate diferi de limba unui câmp de nume, și totuși urmărește ceea ce ne trebuie: cât de probabil este ca lista nativă să cunoască produsul. Din el derivăm o pondere pentru fiecare limbă cu o formulă netedă, dând mai multă pondere listei native pe măsură ce limba crește, și fixăm valorile într-un mic tabel de consultare din aplicație.
Pe cele 200 de interogări judecate în germană și ucraineană, efectul este clar pentru germană și absent pentru ucraineană (Figura 4). MRR pentru germană crește cu .062 (intervalul bootstrap de 95% al diferenței +.030 până la +.099), iar primul loc cu 7 puncte, în timp ce primele cinci câștigă 3 puncte, ceea ce este în limitele zgomotului. MRR pentru ucraineană scade cu .002, pentru că noile ei ponderi sunt apropiate de cele vechi, comune. Câștigul pentru germană se păstrează în ambele jumătăți ale interogărilor, când sunt împărțite în cele impare și cele pare.
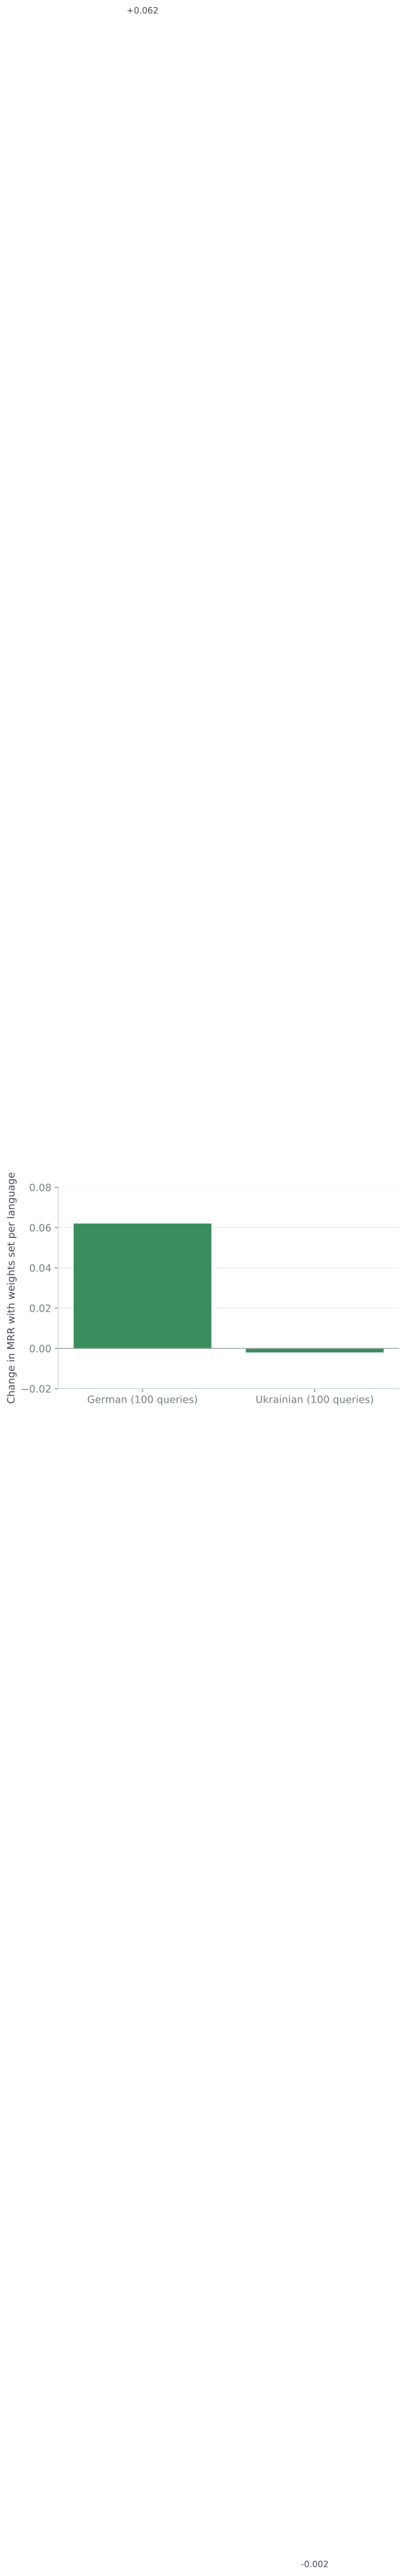
Constantele formulei au fost stabilite pe aceleași interogări, iar ponderile celorlalte limbi decurg din formulă și nu au fost măsurate.
9. Greșeli de tastare și forme de cuvinte
Dicționarul cunoaște formele exacte ale cuvintelor. Un cuvânt cu o greșeală de tastare, sau o formă de caz pe care nu a văzut-o, trece neschimbat și ajunge în listele în engleză ca un cuvânt care nu înseamnă nimic acolo. Căutarea în baza noastră locală repară deja greșelile cu un index SymSpell, un index al distanței de editare în care numărul de modificări permise crește odată cu lungimea cuvântului. Întrebarea deschisă era pasul de traducere, așa că am măsurat ce costă greșelile și ce oferă un mecanism de rezervă.
Pasul 1: greșeli și forme de cuvinte, cuvânt cu cuvânt
Am reconstruit dicționarele celor nouă limbi din numele noastre și am luat, din numele rezervate, cuvintele cu o traducere cunoscută. Fiecare a primit o modificare aleatorie (o literă ștearsă, inserată, înlocuită sau două litere vecine inversate). O căutare în limita de distanță permisă a returnat traducerea cuvântului original pentru 92.5% dintre cuvintele deteriorate, față de 0.3% pentru căutarea exactă. Dacă prima literă trebuia să se potrivească, așa cum poate cere căutarea în baza locală, rezultatul scădea la 77%, pentru că greșelile la prima literă sunt atunci ratate.
Pentru formele de cuvinte am luat cuvintele rezervate pe care dicționarul nu le cunoaște, dar a căror rădăcină Snowball este egală cu rădăcina unui cuvânt cunoscut (în mare parte alt caz sau alt număr al unui cuvânt cunoscut). Distanța de editare a dat o traducere corectă pentru 55% dintre ele, un început comun al cuvântului pentru 63%, și aceeași rădăcină pentru 69%. Terminațiile de caz se schimbă adesea în mai multe litere, ceea ce limita de editare nu permite. Cuvintele necunoscute rămase (mărci, cuvinte rare, numere) sunt un risc: distanța de editare răspunde pentru un sfert dintre ele și are dreptate în o treime din răspunsuri. Folosim rădăcinile doar la căutare; în timpul antrenării au scăzut calitatea (secțiunea 6).
Pasul 2: mecanismul de rezervă pe dicționarele reale
Dicționarele din aplicație lasă afară cuvintele care sunt scrise la fel în ambele limbi, deci un astfel de cuvânt este „necunoscut” pentru mecanismul de rezervă. Un mecanism de rezervă simplu a schimbat, prin urmare, cuvinte care erau corecte: pizza a devenit nicoise, pils a devenit mushroom, cuvântul de marcă Krönung a devenit curd. Pe interogările scrise așa cum sunt, F1 pe cuvinte al traducerii a scăzut cu 3 puncte. Trei gărzi elimină cea mai mare parte a daunei: un cuvânt care este el însuși un cuvânt din dicționarul englez este lăsat în pace, cuvintele foarte scurte sunt lăsate în pace, iar distanța de editare permisă rămâne mică. Ordinea este: căutare exactă, aceeași rădăcină, o modificare. Cu gărzile, pierderea pe interogările scrise așa cum sunt scade la 1.5 puncte, iar pe interogările cu o greșeală F1 crește cu 30 de puncte.
Pasul 3: căutarea completă
F1 al cuvintelor compară o traducere cu o referință, iar o căutare are alte liste care pot absorbi o traducere proastă. Așa că am rulat căutarea completă, ca în secțiunea 3, pe 200 de interogări (100 în germană și 100 în ucraineană): așa cum sunt scrise și cu o greșeală de tastare aleatorie într-un cuvânt din fiecare interogare (195 de interogări modificate). Fiecare interogare a fost tradusă în patru feluri: traducerea corectă (o limită superioară), dicționarul așa cum era, dicționarul cu mecanismul de rezervă simplu și dicționarul cu gărzi. Cele patru liste clasate au fost combinate cu ponderile aplicației, iar un model de limbaj a judecat orbește rezultatele de sus adunate.
| Traducere | Interogări scrise așa cum sunt primul / primele cinci, puncte | O greșeală pe interogare primul / primele cinci, puncte |
|---|---|---|
| Corectă (limită superioară) | +0.5 / −1.0 | +15.0 / +11.5 |
| Dicționar, mecanism simplu de rezervă | +1.5 / +1.0 | +8.5 / +4.5 |
| Dicționar, mecanism de rezervă cu gărzi | +2.0 / +0.5 | +7.5 / +4.0 |
Tabelul 2. Schimbarea față de dicționarul așa cum era, în puncte din ponderea interogărilor cu produsul corect pe primul loc și în primele cinci.
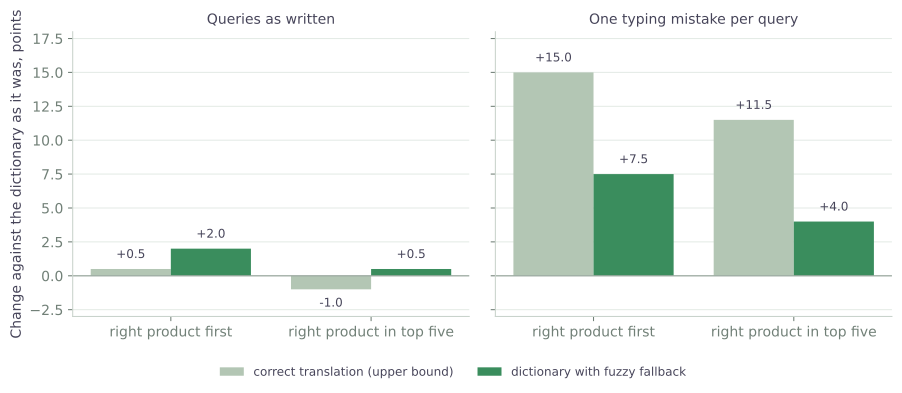
Pe interogările scrise așa cum sunt, dicționarul este la fel de bun ca traducerea corectă (cu o jumătate de punct în urmă pe primul loc, cu un punct înainte în primele cinci), iar mecanismul de rezervă nu schimbă nimic din ce putem detecta (4 interogări câștigate și niciuna pierdută pe primul loc, p = 0.13). Cu o greșeală de tastare, dicționarul așa cum era pierde 15 puncte pe primul loc; mecanismul de rezervă cu gărzi recuperează 7.5 dintre ele (30 de interogări câștigate, 15 pierdute, p = 0.04) și 4 din cele 11.5 puncte din primele cinci (11 câștigate, 3 pierdute, p = 0.06). Căutarea care folosește doar lista în engleză din Open Food Facts câștigă mult mai mult, cu 22 de puncte pe primul loc, pentru că nu are o listă nativă de unde să recupereze. Mecanismul simplu de rezervă și cel cu gărzi nu pot fi deosebite în căutarea completă; păstrăm cel cu gărzi, pentru că schimbă mai puține cuvinte corecte. Câștigul diferă între limbi: ucraineana câștigă 15 puncte pe primul loc, germana niciunul, iar nu am cercetat de ce.
Pasul 4: limitele măsurătorii
Greșelile sunt sintetice: o modificare aleatorie în aproape fiecare interogare, mult mai des decât greșesc oamenii cu adevărat și fără greșelile între taste vecine ale unei tastaturi reale. Două sute de interogări și un singur model ca judecător dau valori p în jur de 0.05, deci rezultatul pentru greșeli arată direcția, iar mărimea exactă are nevoie de interogări reale. Câștigul pe o interogare reală este câștigul de mai sus înmulțit cu ponderea interogărilor cu o greșeală, pe care nu o cunoaștem; cu costul pe interogările corecte de aproape zero, chiar și o pondere mică se justifică.
10. Ce nu a funcționat sau nu a fost necesar
- Eliminarea listei locale în engleză. Pe al doilea set de interogări, versiunea fără ea nu a fost mai bună decât cea cu patru liste (primele cinci cu 2 puncte mai jos, MRR cu .015 mai jos, în limitele zgomotului), așa că am păstrat structura.
- Rădăcinirea înainte de aliniere. Un sfat standard pentru limbile cu terminații bogate; în experimentele noastre a redus acuratețea. Formele exacte plus expresiile au funcționat mai bine.
- O pondere foarte mare pentru perechile din taxonomie. A ajutat puțin la cuvintele necunoscute în două limbi și a pierdut la cuvintele cunoscute. Intervalul utilizabil este îngust, iar noi rămânem în el.
- Acoperirea taxonomiei ca pondere a unei liste. Măsoară calitatea traducerii în acea limbă, iar numărul de produse care există în ea este o cantitate separată.
- Un test care nu putea vedea efectul. Primul nostru test pe taxonomie s-a uitat la cuvintele pe care baza le cunoștea deja și a făcut taxonomia să pară inutilă. Lecția este să întrebi ce poate vedea un test înainte de a avea încredere într-un rezultat nul.
Cum folosim asta în MuscleTiger
Căutarea alimentelor în MuscleTiger funcționează așa cum este descris: interogarea ta ajunge la baza noastră și la Open Food Facts, în limba ta și în engleză, interogarea este tradusă de un dicționar care trăiește pe telefonul tău, iar cele patru clasamente sunt combinate cu ponderi care depind de limba ta. Rezultatele sunt afișate în limba interfeței aplicației, iar produsele vândute în țara ta sunt clasate înaintea celorlalte. Dicționarul funcționează fără rețea, așa că o interogare la sală, fără semnal, tot găsește alimente din baza noastră locală.
Concluzii
- Căutarea găsește alimentul căutat pentru 92% dintre interogări. Într-un test al întregii căutări în nouă limbi, el se află printre primele zece rezultate pentru 90% și pe primul loc pentru 67%; produsele simple sunt găsite ceva mai des decât felurile de mâncare.
- Traducerea în engleză este ceea ce contează. Cu traduceri corecte, adăugarea listei în engleză a ridicat ponderea interogărilor în ucraineană cu produsul corect în primele cinci cu 61 de puncte față de Open Food Facts doar în ucraineană; alte limbi au schimbat puțin și, după patru, au scăzut primele cinci.
- Pentru interogările de alimente, un dicționar mic poate face treaba traducătorului. Alinierea cuvintelor pe numele noastre paralele dă un fișier de câteva sute de kilobytes pe limbă, funcționează offline și reproduce traducerile noastre de referință ale interogărilor scurte cu un F1 al rădăcinilor cuvintelor de la 0.94 la 0.96. Aceasta este acuratețea traducerii interogărilor simple; acuratețea căutării este măsurată separat și este mai mică.
- Taxonomiile publice ajută cel mai mult acolo unde datele noastre tac. Antrenarea dicționarului pe ele a îmbunătățit traducerea termenilor rari rezervați cu două până la cinci puncte în limbile cu o taxonomie mare, cu un cost mic la cei comuni.
- Ponderea fiecărei liste poate depinde de cât de mare este limba în OFF. Pentru germană, schimbarea a ridicat MRR cu .062 pe interogările noastre; pentru ucraineană nimic nu s-a schimbat.
- Un mecanism de rezervă pentru greșelile de tastare merită. Cu o greșeală de tastare, primul loc scade cu 15 puncte când traducătorul cunoaște doar formele exacte, iar un mecanism de rezervă cu gărzi (aceeași rădăcină, apoi o distanță de editare mică) recuperează jumătate din ele; pentru interogările scrise corect nu costă nimic măsurabil.
- Potrivirea a contat mai mult decât limbile. Ponderarea cuvintelor după raritate, rădăcinirea și un singur format de numere au dat cel mai mare câștig al studiului.
Limite. Interogările au fost scrise de noi și judecate de un model de limbaj, deci marjele sunt largi (aproximativ puncte la 200 de interogări). Cifrele sunt pentru germană și ucraineană; ponderile celorlalte limbi sunt extrapolate. Nu am comparat cu traducătorul neuronal și nici cu alte aplicații. Următorul pas este o verificare pe interogările reale ale utilizatorilor.
Date și licențe
Datele despre produse și taxonomiile provin de la Open Food Facts, puse la dispoziție sub Open Database Licence (ODbL); dicționarele descrise aici sunt derivate în parte din taxonomiile OFF și poartă aceeași atribuire. Baza noastră locală este construită din tabele naționale deschise de compoziție a alimentelor, publicate de autorități publice; sursele și licențele lor sunt enumerate în aplicație. Mulțumim contribuitorilor Open Food Facts și întreținătorilor tabelelor naționale.
Surse
- Brown PF, Della Pietra SA, Della Pietra VJ, Mercer RL. The mathematics of statistical machine translation: parameter estimation. Computational Linguistics 1993;19(2):263–311. ACL Anthology
- Moore RC. Improving IBM word-alignment Model 1. Proceedings of ACL 2004:518–525. ACL Anthology
- Cormack GV, Clarke CLA, Büttcher S. Reciprocal rank fusion outperforms Condorcet and individual rank learning methods. Proceedings of SIGIR 2009. doi:10.1145/1571941.1572114
- Darwish K, Oard DW. Probabilistic structured query methods. Proceedings of SIGIR 2003.
- Dyer C, Chahuneau V, Smith NA. A simple, fast, and effective reparameterization of IBM Model 2. Proceedings of NAACL-HLT 2013:644–648. ACL Anthology
- Open Food Facts: taxonomies of ingredients and categories and product data, world.openfoodfacts.org, under the Open Database Licence (ODbL).
- Riley D, Gildea D. Improving the IBM alignment models using variational Bayes. Proceedings of ACL (short papers) 2012:306–310. ACL Anthology
- Östling R, Tiedemann J. Efficient word alignment with Markov chain Monte Carlo. The Prague Bulletin of Mathematical Linguistics 2016;106:125–146.
- Mermer C, Saraçlar M. Bayesian word alignment for statistical machine translation. Proceedings of ACL (short papers) 2011:182–187. ACL Anthology
- Jalili Sabet M, Dufter P, Yvon F, Schütze H. SimAlign: high quality word alignments without parallel training data using static and contextualized embeddings. Findings of EMNLP 2020.