Дослідницькі нотатки MuscleTiger · № 5
Пошук їжі будь-якою мовою: переклад запитів, злиття баз і що ми виміряли
Ви вводите «Spiegelei mit Speck» або «борщ з м’ясом» у харчовий щоденник і очікуєте побачити продукт з калоріями та макронутрієнтами. Найбільші відкриті бази харчових продуктів переважно написані англійською та французькою, тоді як люди шукають рідною мовою, з назвами брендів, закінченнями слів і друкарськими помилками. У цій замітці описано, як ми побудували пошук їжі в MuscleTiger, що ми пробували, що виявилося непотрібним і що ми виміряли.
Коротко
Наш пошук їжі знаходить саме той продукт, який шукали, для 92% запитів дев’ятьма мовами (розділ 3). Ми шукаємо одночасно в чотирьох списках: у власній базі харчових продуктів англійською та мовою користувача і в Open Food Facts мовою користувача та англійською, а рейтинги зливаємо методом взаємного злиття рангів (reciprocal rank fusion). Запит іншою мовою спершу перекладається на англійську. Спочатку ми користувалися нейромережевим перекладачем на пристрої, потім замінили його невеликим словником, навченим на наших паралельних назвах продуктів за допомогою вирівнювача слів сімейства IBM Model 2 з баєсівським апріорі, а також за таксономіями Open Food Facts. На наших тестових запитах словник відтворює еталонний англійський переклад з F1 за основами слів 0.94 для німецької та 0.96 для української. Це вимірює переклад коротких простих запитів. За правильних перекладів додавання англійського списку підвищує частку українських запитів, для яких потрібний продукт у першій п’ятірці, на 61 пункт, а інші мови додають мало. Ваги чотирьох списків, які залежать від того, наскільки велика мова в Open Food Facts, покращили німецьку й не змінили українську. Запасний варіант для друкарських помилок у перекладачі повертає близько половини з 15 пунктів, які коштує помилка.
Ми пояснюємо підхід і сімейства методів, які розглядали.
1. Проблема: запит однією мовою, дані кількома
Пошук їжі має добре робити три речі одночасно. Він має розуміти короткий і недбалий запит («chicken breast 200g», «coca cola zero», «мигдальне молоко»). Він має знаходити продукт із повними й правдоподібними значеннями поживності. І він має працювати мовою людини, на телефоні, швидко й бажано без інтернету.
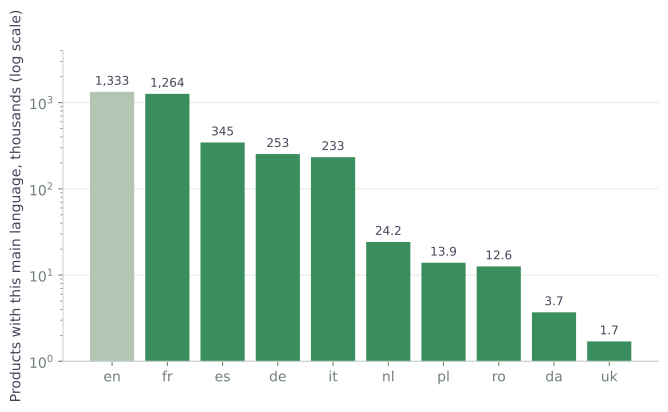
Дані, якими ми можемо скористатися, нерівномірні. Open Food Facts (OFF) [6], відкрита база упакованих продуктів, містить мільйони продуктів, але мова продукту залежить від країни продажу та звичок тих, хто додає дані. За основною мовою продуктів (OFF, 15 листопада 2026) першими є англійська та французька, приблизно по 1.3 мільйона продуктів кожна. Далі йдуть іспанська, німецька та італійська з 230–350 тисячами, а менші мови, які ми підтримуємо, мають від 1.7 до 25 тисяч (рис. 1). Тому запит українською може мати відповідь українською від дуже небагатьох продуктів, тоді як запит французькою потрапляє в базу, яка спочатку переважно французька.
Наша власна база
Друге джерело — наша власна база харчових продуктів з повною енергетичною цінністю та макронутрієнтами. Це об’єднання кількох національних таблиць складу харчових продуктів, обраних тому, що вони відкриті, виміряні в лабораторіях і повні щодо макронутрієнтів. Багато продуктів у ній мають побутові порції, як-от «1 slice». Продукт пропускається, якщо продукт з такою самою назвою вже є в базі, а нові рядки завжди додаються після старих, тож номер продукту та його переклади ніколи не змінюються, коли додається нова таблиця.
Коли пізніше ми додали ще три таблиці, частка тестових запитів, для яких потрібний продукт у першій п’ятірці, зросла на 3 пункти, а на першому місці на 2 пункти; жодна зміна не є значущою. Виграш прийшов переважно від поширених страв, які нові таблиці описують простою англійською, як-от lasagna, cappuccino або Greek yoghurt. Одну з кандидатних таблиць ми залишили поза базою, бо її ліцензія містить умову share-alike, яка могла б поширитися на нашу об’єднану базу.
Таблиці написані англійською або мовою своєї країни, тому назви іншими мовами довелося створити. Англійські назви є оригіналом; назви іншими мовами створено машинним перекладом, а частково згодом переробили мовні агенти з автоматичними перевірками (валідатор відхиляє відповідь, яка змінює числа, одиниці чи структуру назви). Числа в назвах використовують десяткову крапку в усіх мовах, і в базі, і в запиті, тож запит із відсотком жиру може віддавати перевагу продукту з цим відсотком.
2. Чотири списки і одне ранжування
Схему, яку ми використовуємо, легко описати. Кожен запит шукають у чотирьох місцях:
- A: наша локальна база, запит перекладено англійською;
- B: наша локальна база, запит у такому вигляді, у якому його ввів користувач мовою користувача;
- C: Open Food Facts, пошук мовою користувача;
- D: Open Food Facts, пошук англійським перекладом.
Кожен список повертає власне ранжування, а ранжування зливаються методом взаємного злиття рангів (reciprocal rank fusion, RRF) [3]. Продукт, який стоїть близько до верху кількох списків, перемагає продукт, який є першим лише в одному списку:
де — це позиція продукту у списку , — вага списку, а — мала стала, яка не дає першому місцю домінувати. Метод не потребує оцінок від списків, лише їхнього порядку, що важливо, бо списки походять із різних систем з несумірними оцінками. Ми обрали його саме з цієї причини. Кормак та співавт. повідомляють, що в їхніх експериментах він конкурентний із складнішими методами навчання ранжування [3].
RRF є опублікованим методом, а наш внесок — вимірювання: які списки включати, як перекладати запит і наскільки довіряти кожному списку в кожній мові.
3. Як ми вимірювали
Протокол:
- Ми склали набори запитів кількох типів: бренд і продукт, страва, повсякденна їжа, напій, а також неформальні запити та запити з помилками. Один набір має 959 запитів, з яких 200 оцінено детально; другий набір має 200 запитів, 100 німецькою та 100 українською, по 20 кожного типу. Окремий набір страв чужих кухонь (наприклад, японська страва, запитана німецькою) перевіряє, чи має мова запиту відповідати страві.
- Для кожного запиту ми зібрали найкращі результати кожної конфігурації, і мовна модель оцінювала кожного кандидата як релевантного чи ні, бачачи запит і англійський переклад, але не те, яка конфігурація повернула кандидата. Тож суддя не міг віддавати перевагу якомусь методу.
- Ми звітуємо top-1 (потрібний продукт на першому місці), top-5 (він серед перших п’яти) і MRR, середнє значення першого релевантного результату. Для порівнянь між конфігураціями ми парували результати за запитами та використовували знаковий тест і бутстреп-інтервали.
Точність усього пошуку
Число з короткого підсумку дає тест пошуку саме в тому вигляді, в якому він працює в застосунку. Ми написали по десять запитів кожною з дев’яти мов, які застосунок підтримує крім англійської, по два кожного типу, загалом 90 запитів. Кожен запит пройшов ті самі кроки, що й на телефоні: переклад словником, наша база англійською та мовою запиту, Open Food Facts обома мовами, де товари, що продаються в країні цієї мови, стоять першими, і злиття з вагами застосунку. Ми переглянули весь злитий список кожного запиту, в середньому близько шістдесяти результатів, і вручну позначили перший результат, який користувач прийняв би як потрібний продукт, за тими самими правилами, що й сліпий суддя.
| Потрібний продукт знайдено | Усі запити (90) | Окремі продукти (65) | Страви (25) |
|---|---|---|---|
| будь-де у списку | 92.2% | 93.8% | 88.0% |
| серед перших десяти | 90.0% | 90.8% | 88.0% |
| серед перших п’яти | 85.6% | 86.2% | 84.0% |
| на першому місці | 66.7% | 67.7% | 64.0% |
Точність усього пошуку. По десять запитів кожною з дев’яти мов, пошук як у застосунку. Окремі продукти — це продукти харчування, пакована продукція та напої; до страв належать і складені страви, як-от бутерброд із сиром чи вівсянка з молоком.
Потрібний продукт є десь у списку для 92% запитів, серед перших десяти результатів для 90%, серед перших п’яти для 86% і на першому місці для 67%. Окремі продукти знаходяться трохи частіше за страви (94% проти 88% будь-де у списку). Промахи — це здебільшого брендові продукти, яких немає в жодному списку, і перекуси з кількох продуктів, для яких списки пропонують складники, але не сам перекус. Десять запитів на мову — мала основа: один запит змінює результат мови на десять пунктів, тож ці числа описують пошук загалом і мало кажуть про окрему мову. Наступні розділи розбирають пошук на частини й вимірюють кожен крок на більших наборах запитів німецькою та українською.
4. Що дає правильний переклад для пошуку
Перш ніж описувати наші спроби побудувати добрий перекладач, ми виміряли, чого варта правильний переклад. Ми написали 100 запитів їжі українською (по 20 щодо повсякденних продуктів, страв, напоїв, брендів і неформальних запитів) і вручну переклали кожен на інші дев’ять мов, тож переклад правильний за побудовою. Для кожної мови ми шукали в Open Food Facts запит цією мовою і зливали списки методом взаємного злиття рангів (рівняння 1, однакові ваги). Перша конфігурація — лише українська, друга додає англійську, а далі ми додавали французьку, іспанську, німецьку, італійську, голландську, польську, румунську та данську в порядку кількості їхніх продуктів в OFF (рис. 2). Релевантність оцінив наосліп мовна модель за правилами розділу 3, на об’єднаній першій п’ятірці кожної конфігурації.
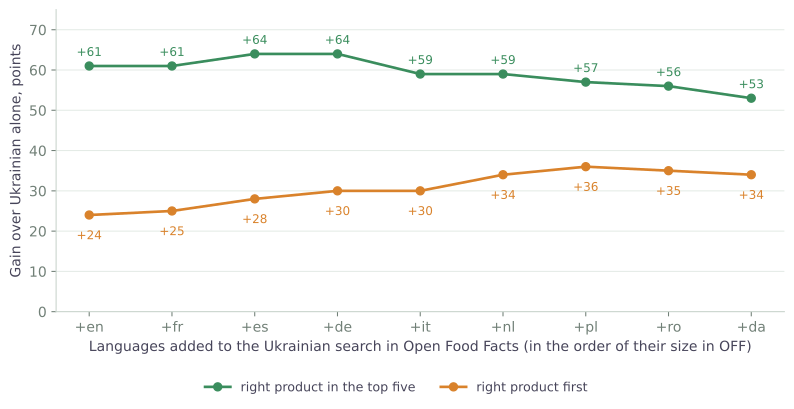
Перший крок найбільший. Пошук в OFF лише українською часто нічого не знаходить: в OFF мало продуктів українською мовою (рис. 1), а для 47 із 100 запитів український список був порожнім. Додавання англійського перекладу підвищує частку запитів, для яких потрібний продукт у першій п’ятірці, на 61 пункт, а на першому місці на 24 пункти. Це дає 61 виграний запит і жодного втраченого.
Наступні мови змінюють мало. Французька лишає першу п’ятірку без змін (виграно 5, втрачено 5). Іспанська та німецька додають ще 3 пункти, що в межах похибки. Далі перша п’ятірка падає на 11 пунктів від свого піку при всіх десяти мовах, тоді як перше місце повільно зростає ще на 10–12 пунктів. Падіння з чотирьох до десяти мов у першій п’ятірці є значущим на цих запитах (виграно 2, втрачено 13, знаковий тест p = 0.007); зростання першого місця від двох до десяти мов не є значущим (виграно 20, втрачено 10, p = 0.10). Бренди поводяться інакше, ніж повсякденна їжа: зі збільшенням числа списків запит бренду знаходять частіше (у першій п’ятірці на 15 пунктів більше з доданою іспанською, ніж лише з англійською), тоді як повсякденну їжу знаходять рідше (на 25 пунктів менше з десятьма мовами, ніж з англійською). Двадцять запитів на тип — мала вибірка, тож ці розбіжності є орієнтовними.
Правильний переклад англійською несе основний ефект. Кожна додаткова мова — це ще один запит до OFF, і після перших кількох він розмиває ранжування.
Страви чужої кухні
Крок до англійської важить найбільше, коли страва з іншої кухні. Окремий набір зі 100 запитів, по десять на кожну з десяти мов, називав відому іноземну страву так, як її ввів би користувач: Borschtsch для німецького користувача, paella, pierogi, tiramisu, stroopwafel, sarmale. Це старіший експеримент, а запити переклав нейромережевий перекладач, яким тоді користувався застосунок (розділ 5). Для 90 неанглійських запитів переклад запиту англійською підвищив частку запитів, де страва потрапляє в першу п’ятірку, на 34 пункти порівняно з пошуком в Open Food Facts мовою користувача (виграно 47, жодного втраченого, p < 0.001). Додавання інших мов після англійської не змінювало першу п’ятірку, навіть коли ми заздалегідь обирали мову країни походження страви.
Наша локальна база тут допомагала: без її англійського списку перше місце падало на 8 пунктів на цих запитах (7 запитів втрачено, жодного не виграно, p = 0.016), бо база знає paella, ratatouille чи lasagna і ставить їх першими. На повсякденній їжі вона такої користі не показала, але її вилучення також не покращило пошук (розділ 10), тож ми її залишаємо. Решта промахів — страви, яких немає в жодному списку OFF під жодною назвою, як-от sarmale. У наборі лише близько двадцяти різних страв, тож він описує відомі страви і мало говорить про рідкісні.
Точний збіг важив більше за мови
Найбільше окреме покращення всього дослідження прийшло від зіставлення слів у локальній базі, без жодного перекладу. Локальна база шукає своїм зіставленням, а службові слова, закінчення відмінків і десяткові коми ламали його: «суп з грибами» українською не повертав нічого, бо зіставлення вимагало, щоб кожне слово запиту знайшлося в тому вигляді, в якому його ввели. Зважування слів запиту за їхньою рідкістю (IDF), стеммер Snowball для мов, які його мають, і один формат чисел покращили top-5 на стандартному наборі приблизно на 9% від початку дослідження (знаковий тест p = 0.008), а на запитах з прийменниками та формами слів приблизно на 12%.
5. Чому ми замінили перекладач
Ми прибрали ML Kit, бо він погано перекладає назви продуктів. Це загальний перекладач, створений для речень, а назва продукту — це кілька слів без контексту: бренд, стан продукту, страва, названа на честь місця. Нашу базу спершу переклали ним, і ось реальні записи (українські та французькі переклади з поясненням для читачів, які не знають мови):
| Англійська назва | Результат ML Kit | Що пішло не так |
|---|---|---|
| plain, refrigerated | рівнина, холодильна (українською) | «plain» тут означає несолодкий, як у plain yoghurt, але перекладено як «plain», тобто рівнина; «refrigerated» стало прикметником «холодильний», тобто належний холодильнику |
| boneless | безкімнатний (українською) | означає «без кімнат»; задуманий сенс — «без кісток» |
| Pad Thai | Подушка тайська (українською) | назву страви прочитано як слова: «тайська подушка» |
| Rice flour, brown | Рисова борошно, коричневий (українською) | прикметники не узгоджуються з іменником «борошно», що неграматично українською |
| Meringue with chocolate; Ham salad spread | частково або повністю не перекладено (українською) | англійські слова лишаються в назві |
| bun | chignon (французькою) | зачіска «гулька», тоді як мали на увазі хлібну булочку |
| sauerkraut | chouchoune (французькою) | інше слово; французьке слово для квашеної капусти — choucroute |
Та сама вада проявляється і в запитах, де одне хибне слово означає відсутній продукт, і її не можна виправити локально: одне слово в нейромережевій моделі не виправиш. Було ще дві менші причини: моделі займають близько 40 МБ на мову, а SDK є сторонньою компонентою.
Дані, якими ми володіємо, вказують на кращий інструмент. Наша база має пари англійської назви та її назви кожною мовою, тобто паралельний корпус саме в нашій предметній області. Словник можна навчити на такому корпусі.
6. Словник, навчений вирівнюванням слів
Навчання словника з паралельного тексту — це давня задача вирівнювання слів: визначення, яке слово одного речення відповідає якому слову іншого. Класичне сімейство — моделі IBM зі статистичного машинного перекладу [1]. Модель 1, найпростіша і наша відправна точка, розглядає назву однією мовою як породжену словами іншої, без урахування порядку. Для англійської назви і назви іншою мовою (з доданим порожнім словом) ймовірність пари така
а таблиця ймовірностей перекладу слів , тобто словник, оцінюється методом очікування–максимізації: на кожному кроці кожна пара слів у парі назв отримує частку підрахунку, пропорційну поточній ймовірності, а частки нормуються в нові ймовірності. Для короткої назви продукту це добре пасує, бо порядок слів майже не потрібно моделювати. Відомий її недолік описав Мур [2]: рідке слово може отримати будь-яку ймовірність, що пасує до його єдиного речення, тож рідкі слова стають «збирачами сміття», які вирівнюються з забагато словами. Мур запропонував згладжування лічильників і кращу ініціалізацію; баєсівський апріорі для ймовірностей перекладу, застосований варіаційним висновком, є іншим засобом [7].
Що ми розглядали і вимірювали
Ми порівняли наш вирівнювач з його абляціями, з референсними реалізаціями двох опублікованих вирівнювачів і з методом, який взагалі не має моделі вирівнювання. Кожен метод отримав ті самі пари назв, ту саму відкладену вибірку з 5% і той самий спосіб перетворення вирівнювань у словник (пара слів зараховується, якщо вона зв’язана щонайменше двічі; кожне слово отримує свій найчастіший переклад). Якість — це F1 основ слів між словниковим перекладом відкладеної назви, слово за словом, і її англійською назвою, усереднене за дев’ятьма мовами (таблиця 1). Різниці малі, тож ми також звітуємо, в скількох із дев’яти мов різниця є чіткою (95% бутстреп-інтервал парної різниці не містить нуля).
| Метод | Що це | Середній F1 | Порівняно з нашим |
|---|---|---|---|
| Коефіцієнт Dice | без моделі вирівнювання, кожне слово пов’язується зі словом, яке найчастіше зустрічається разом із ним | 0.812 | гірше у 7 із 9 |
| IBM Model 1 [1], EM | ймовірності перекладу слів, без порядку слів | 0.817 | гірше у 6 із 9 |
| Model 1 з апріорі Діріхле [7] | варіаційний Баєс для ймовірностей перекладу | 0.822 | гірше у 4 із 9 |
| Діагональний апріорі вирівнювання, EM | Модель 2 у параметризації fast_align [5], без баєсівського апріорі | 0.822 | гірше у 6 із 9 |
| Наш | діагональний апріорі і апріорі Діріхле, два напрями, перетин | 0.825 | – |
| Наш, grow-diag-final-and | те саме, але зв’язки обох напрямів об’єднано стандартною евристикою | 0.828 | краще у 5 із 9, гірше у 1 |
| fast_align [5] | реалізація авторів, перетин / grow-diag-final-and | 0.826 / 0.831 | 3 краще, 2 гірше / 7 краще |
| eflomal [8] | HMM з фертильністю, баєсівський, семплювання MCMC; перетин / grow-diag-final-and | 0.825 / 0.828 | 2 краще, 2 гірше / 7 краще |
| SimAlign [10] | багатомовні вбудування BERT без навчання на наших назвах; три методи зіставлення (найкращий / ітеративний / перетин) | 0.824 / 0.822 / 0.812 | 2 краще, 2 гірше / 1 краще, 3 гірше / гірше у 8 |
Таблиця 1. Вирівнювачі, порівняні на відкладених назвах нашої бази, дев’ять мов. Останній стовпець рахує мови, в яких різниця з нашим є чіткою. fast_align і eflomal — реалізації авторів.
Голий коефіцієнт Dice відстає від нашого лише на 0.013, а SimAlign, якому не потрібне навчання на наших назвах, на найкращому налаштуванні на рівні з нашим. На коротких, майже паралельних назвах вибір вирівнювача мало важить, і більшість якості дають самі назви. Кожен наш компонент додає трохи, а справжній fast_align з тим самим перетином дає той самий результат (0.826 проти 0.825), чого й очікуємо від методу з тією самою конструкцією. Стандартна евристика grow-diag-final-and об’єднує зв’язки обох напрямів. Порівняно з перетином вона допомагає майже так само, як вибір моделі: від чверті до половини пункту F1 для всіх трьох. Це невеликий виграш, чіткий у більшості мов, і ми плануємо використати його наступного разу, коли перебудовуватимемо словники.
Зведення слів до стемів Snowball перед вирівнюванням знижує F1 (0.818, гірше у 6 із 9 мов), а збереження лише перших чотирьох літер кожного слова, яке Естлінг і Тідеманн описують як корисне наближене стемінг для машинного перекладу [8], знижує його значно більше (0.743). Різницю пояснює завдання: Естлінг і Тідеманн вимірюють системи перекладу, побудовані на вирівнюваннях, а ми шукаємо окремі слова назви продукту в словнику, де злиття форм слів зливає різні продукти.
Ми не запускали семплер Гіббса Мермера і Сараджара [9] (повністю баєсівську Модель 1), моделі IBM 3–5 або імовірнісні структуровані запити Дарвіша і Оарда [4], які зберігають кілька перекладів на слово. Останнє є можливим наступним кроком, бо наш словник зберігає лише найкращого кандидата.
Що таке наш вирівнювач
Наш вирівнювач — це власна реалізація IBM Model 2 у параметризації fast_align [5]: ймовірність того, що слово вирівнюється з певною позицією, спадає зі відстанню від діагоналі (у Моделі 1 вона рівномірна), бо назви продуктів мають тенденцію зберігати порядок слів між мовами. Поверх цього ймовірності перекладу слів отримують розріджений апріорі Діріхле з варіаційним висновком [7], як у fast_align, що не дає рідким словам поглинати ймовірність. Фіксовані константи (ймовірність вирівнювання слова з нічим, сила апріорі та початкова крутизна діагоналі) — ті, які повідомляють Dyer і колеги. fast_align також переоцінює крутизну під час навчання; ми цього не робимо. Навчання ведеться в обох напрямах, і зберігаються лише зв’язки, з якими погоджуються обидва напрями (перетин), що підвищує точність ціною частини повноти. Слова вирівнюються у своїх точних формах без стемінгу: зведення до основ, звичайне для мов з багатими закінченнями, у наших перших пробах погіршило точність, тож складені слова й слова з дефісом обробляються через фрази.
Результат — словник у трьох шарах, які перекладач застосовує, починаючи з найдовшого збігу до трьох слів: записи таксономії, фрази, вирівняні в нашій базі, і окремі слова, вирівняні в нашій базі. Слово, якого немає в словнику, як-от бренд або описка, передається без змін, бо OFF часто його знає. Кожна мова — це файл розміром у кілька сотень кілобайтів, тоді як нейромережеві моделі займають близько 40 МБ на мову. Він працює без мережі, і кожен переклад можна простежити до рядка словника та виправити.
Наскільки добрий переклад
Ми вимірюємо перекладач двома способами. На 5% пар назв, відкладених із навчання, переклад іноземної назви слово за словом і порівняння результату з англійською назвою за основами слів дають F1 від 0.78 до 0.90 у дев’яти мовах. На оцінних запитах, до кожного з яких ми написали еталонний англійський переклад, F1 основ слів становить 0.94 для німецької (88 із 100 запитів ідентичні за основами) і 0.96 для української (89 із 100).
Ці числа описують переклад коротких поширених запитів англійською. Якість самого пошуку нижча і вимірюється окремо (розділи 3 і 9). Ми не запускали старий нейромережевий перекладач на тих самих запитах, тож не стверджуємо, що словник кращий за ML Kit. Він досить точний на цих запитах, малий, працює без мережі та піддається виправленню.
7. Таксономії Open Food Facts: що вони дають і що коштують
OFF веде публічні таксономії інгредієнтів і категорій: ієрархічні списки, де кожен запис має англійську назву, а назви та синоніми багатьма мовами складають добровольці. Вони містять тисячі записів з англійською назвою і привабливі з трьох причин: переклади зроблені людьми в предметній області їжі, вони містять слова, яких не використовують наші власні назви (рідкісні інгредієнти), і вони незалежні від машинного перекладу, яким створено наші назви.
Труднощі такі:
- Нерівномірне покриття. Частка записів з назвою певною мовою коливається від 1.6% (українські категорії) до 84.6% (французькі категорії), тож таксономія не може бути єдиним джерелом. Ми застосовуємо її першою, де запис існує, а решту заповнює словник із нашої бази.
- Назви в стилі категорій і багато синонімів. Запис має одну англійську назву і багато синонімів мовою. Кожен синонім пов’язується з основною англійською назвою, а дуже довгі англійські назви пропускаються.
- Фрази, а також окремі слова. Назви таксономії є фразами, тож перекладач на кожній позиції спершу шукає найдовшу фразу, а потім окремі слова.
- Шум. Коли таксономію використовують і як навчальні дані, її фрази в стилі категорій конкурують з ідіоматичними фразами нашої бази. Вагу для пар таксономії довелося виміряти. Завелика вага втрачала точність на поширених словах, а діапазон, який працює, вузький.
Навчання на таксономії: тест, який не бачив ефекту
Наш перший тест додавання пар таксономії до навчання вирівнювання нічого не показав. Ми виміряли його на відкладених назвах з нашої бази та на наших запитах, і якість перекладу змінилася щонайбільше на кілька тисячних. Ми майже вирішили, що таксономія корисна лише як довідник. Той тест не міг побачити ефекту: обидва набори містять слова, які наша база вже знає, тоді як сенс таксономії — додати слова, яких база не знає.
Чесний тест вилучає десяту частину записів таксономії з шару пошуку і з навчання, будує словник з навчанням на таксономії і без нього та перекладає назви вилучених записів. Для мов з великою таксономією навчання додає від двох до чотирьох пунктів F1 на всіх відкладених назвах і від чотирьох до п’яти пунктів на назвах зі словом, якого бракує нашій базі, без втрат на назвах зі знайомих слів (рис. 3). Для мов з малою таксономією, як-от українська і румунська, нічого не змінюється. Ми відмовилися від нашої ранньої рекомендації, і словники в застосунку побудовано з навчанням на таксономії.
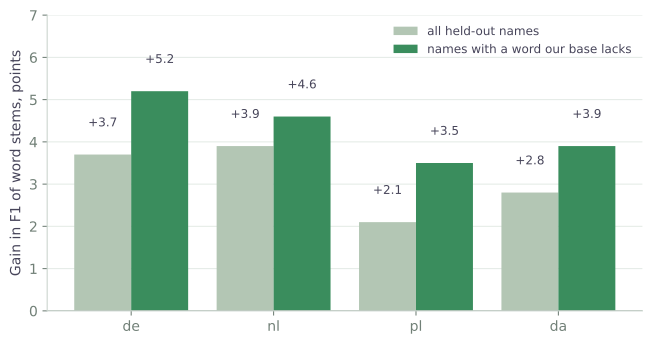
Де це може шкодити. Назви таксономії мають категорійний характер, і їхні синоніми можуть витіснити ідіоматичну фразу, вивчену з нашої бази («home fries» для страви з смаженої картоплі). На німецьких запитах це коштувало близько одного пункту F1, а на українських нічого; ми прийняли цю ціну заради виграшу на рідкісних словах.
8. Ваги чотирьох списків за мовами
У рівнянні (1) кожен список має вагу. Наші перші ваги були однаковими для всіх мов і підібрані на одному наборі запитів. Але якість списків різниться між мовами. Рідний список OFF C багатий французькими чи німецькими продуктами і бідний українськими, де список D з англійською несе більше навантаження. Надати мові власні ваги — природна ідея, і питання в тому, де взяти їх для десяти мов, якщо маємо тестові запити лише для двох.
Ми розглянули два показники. Перший — частка записів таксономії, які мають назву цією мовою. Його легко порахувати, але він міряє, наскільки добре волонтери переклали словник, що впливає на словник, і мало говорить про те, скільки продуктів мають назву цією мовою; його два стовпці навіть суперечать один одному (італійська: 75% інгредієнтів і 28% категорій). Ми його не використали. Другий — кількість продуктів OFF на мову відносно англійської, яку дає пошуковий сервіс (рис. 1). Це проксі, бо основна мова продукту може відрізнятися від мови поля назви, але він відображає те, що нам потрібно: наскільки ймовірно, що рідний список знає продукт. З нього ми виводимо вагу для кожної мови плавною формулою, яка дає рідному списку більшу вагу в міру зростання мови, і фіксуємо значення в невеликій таблиці в застосунку.
На 200 оцінених німецьких і українських запитах ефект є чітким для німецької і відсутній для української (рис. 4). MRR німецької зростає на .062 (95% бутстреп-інтервал різниці від +.030 до +.099), а перше місце на 7 пунктів, тоді як перша п’ятірка дає 3 пункти, що в межах похибки. MRR української знижується на .002, бо нові ваги близькі до старих спільних. Виграш для німецької зберігається в обох половинах запитів, якщо розділити їх на парні та непарні.
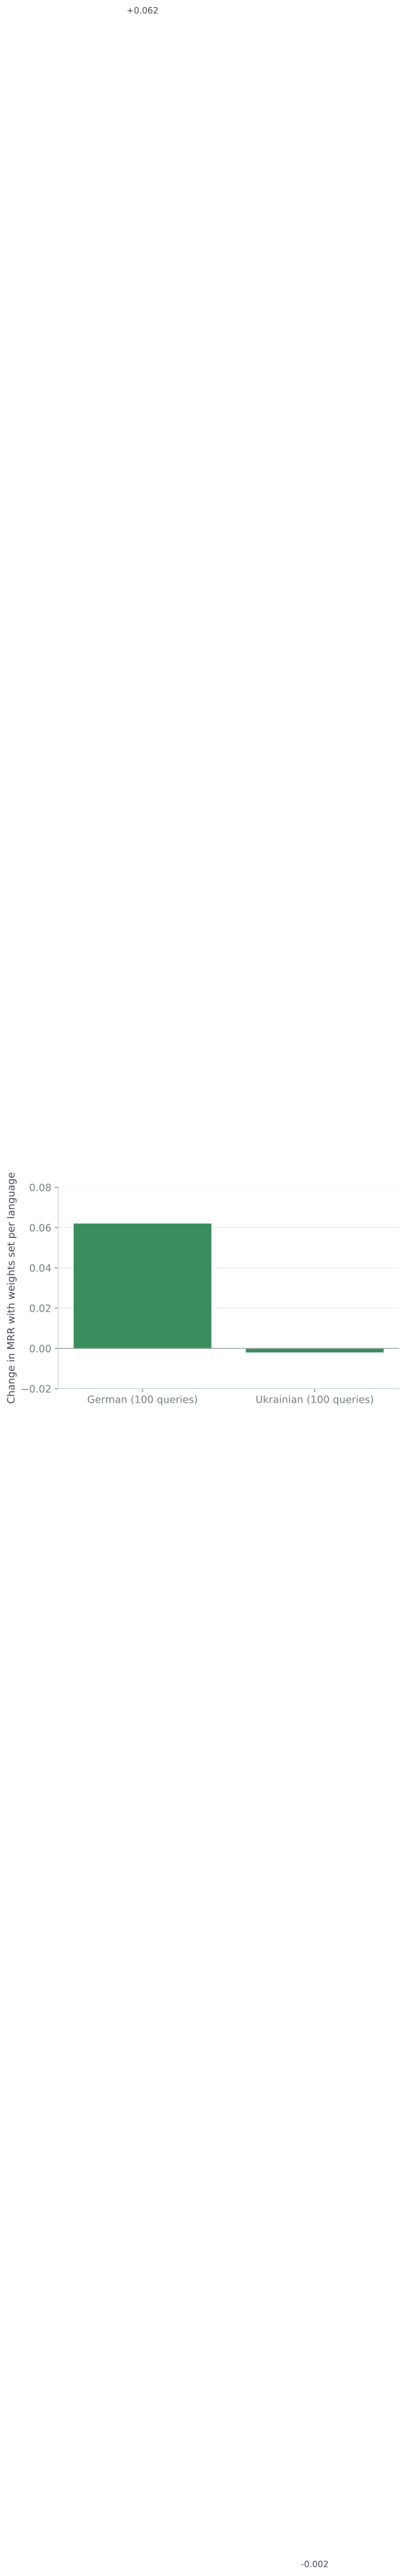
Константи формули підбирали на цих самих запитах, а ваги інших мов випливають з формули і не виміряні.
9. Друкарські помилки і форми слів
Словник знає точні форми слів. Слово з друкарською помилкою або форму відмінка, якої він не бачив, передається без змін і потрапляє в англійські списки як слово, яке там нічого не означає. Пошук у нашій локальній базі вже виправляє помилки за допомогою індексу SymSpell, індексу відстані редагування, у якому кількість дозволених правок зростає з довжиною слова. Відкритим питанням був крок перекладу, тож ми виміряли, чого коштують помилки і що дає запасний варіант.
Крок 1: помилки та форми слів, слово за словом
Ми перебудували словники дев’яти мов з наших назв і взяли з відкладених назв слова з відомим перекладом. Кожне отримало одну випадкову правку (літеру видалено, вставлено, замінено або поміняно місцями дві сусідні літери). Пошук у межах дозволеної відстані редагування повернув переклад вихідного слова для 92.5% пошкоджених слів, проти 0.3% для точного пошуку. Якщо перша літера мала збігатися, як це може вимагати пошук у локальній базі, показник упав до 77%, бо помилки в першій літері тоді пропускаються.
Для форм слів ми взяли відкладені слова, яких словник не знає, але чий стем Snowball збігається зі стемом відомого слова (переважно інший відмінок або число відомого слова). Відстань редагування дала правильний переклад для 55% з них, спільний початок слова для 63%, той самий стем для 69%. Закінчення відмінків часто змінюють кілька літер, а ліміт правок цього не дозволяє. Решта невідомих слів (бренди, рідкісні слова, числа) становить ризик: відстань редагування відповідає для чверті з них і є правильною в третині відповідей. Стеми ми використовуємо лише під час пошуку; під час навчання вони знижували якість (розділ 6).
Крок 2: запасний варіант на реальних словниках
Словники в застосунку пропускають слова, які однаково написані в обох мовах, тож для запасного варіанта таке слово «невідоме». Простий запасний варіант тому міняв слова, які були правильними: pizza ставала nicoise, pils — mushroom, а брендове слово Krönung — curd. На запитах як вони є F1 перекладу слів упав на 3 пункти. Три обмеження знімають більшість шкоди: слово, яке є англійським словом словника, лишається без змін; дуже короткі слова лишаються без змін; а дозволена відстань редагування лишається малою. Порядок такий: точний пошук, той самий стем, одна правка. З обмеженнями втрата на запитах як вони є скорочується до 1.5 пункту, а на запитах з помилкою F1 зростає на 30 пунктів.
Крок 3: увесь пошук
Word F1 порівнює переклад з еталоном, а пошук має інші списки, які можуть поглинути поганий переклад. Тому ми провели весь пошук, як у розділі 3, на 200 запитах (100 німецьких і 100 українських): як вони є і з однією випадковою друкарською помилкою в слові кожного запиту (змінено 195 запитів). Кожен запит переклали чотирма способами: правильним перекладом (верхня межа), словником як був, словником із простим запасним варіантом і словником з обмеженнями. Чотири ранжовані списки злили з вагами застосунку, а мовна модель наосліп оцінила об’єднані найкращі результати.
| Переклад | Запити як вони є перше / перша п’ятірка, пункти | Одна помилка на запит перше / перша п’ятірка, пункти |
|---|---|---|
| Правильний (верхня межа) | +0.5 / −1.0 | +15.0 / +11.5 |
| Словник, простий запасний варіант | +1.5 / +1.0 | +8.5 / +4.5 |
| Словник, запасний варіант з обмеженнями | +2.0 / +0.5 | +7.5 / +4.0 |
Таблиця 2. Зміна порівняно зі словником як був, у пунктах частки запитів, для яких потрібний продукт на першому місці та в першій п’ятірці.
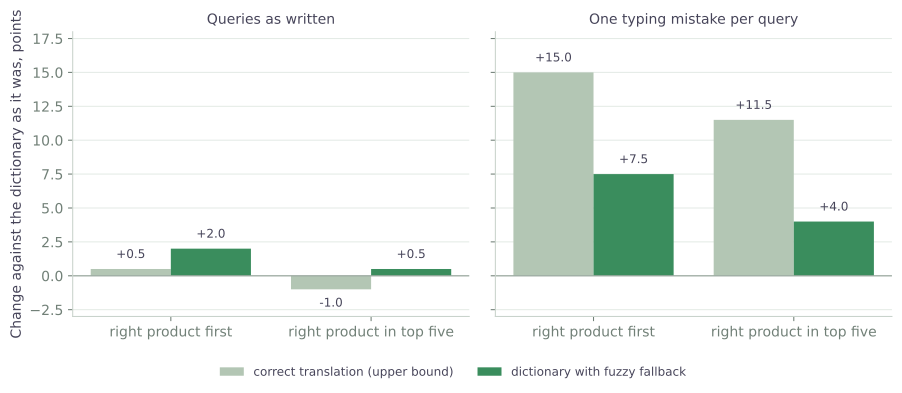
На запитах як вони є словник не поступається правильному перекладу (на першому місці на півпункту позаду, у першій п’ятірці на пункт попереду), а запасний варіант не змінює нічого, що ми можемо виявити (на першому місці виграно 4 запити, жодного не втрачено, p = 0.13). З друкарською помилкою словник як був втрачає 15 пунктів на першому місці; запасний варіант з обмеженнями повертає з них 7.5 (виграно 30 запитів, втрачено 15, p = 0.04) і 4 з 11.5 пунктів у першій п’ятірці (виграно 11, втрачено 3, p = 0.06). Пошук, який використовує лише англійський список Open Food Facts, виграє набагато більше: на 22 пункти на першому місці, бо йому нема на що спертися з рідного списку. Простий і обмежений запасні варіанти в загальному пошуку не відрізняються; ми залишаємо обмежений, бо він змінює менше правильних слів. Виграш різниться за мовами: українська дає 15 пунктів на першому місці, німецька жодного, і ми не з’ясовували чому.
Крок 4: межі вимірювання
Помилки синтетичні: одна випадкова правка майже в кожному запиті, значно частіше, ніж люди справді помиляються, і без помилок на сусідніх клавішах реальної клавіатури. Двісті запитів і одна модель як суддя дають p-значення близько 0.05, тож результат для помилок показує напрям, а точний розмір потребує реальних запитів. Виграш на один реальний запит — це виграш вище, помножений на частку запитів з помилкою, якої ми не знаємо; оскільки втрати на правильних запитах майже нульові, навіть мала частка окупається.
10. Що не спрацювало або не було потрібним
- Вилучення локального англійського списку. На другому наборі запитів версія без нього не була кращою за чотирисписковий варіант (перша п’ятірка на 2 пункти нижча, MRR на .015 нижчий, у межах похибки), тож ми зберегли структуру.
- Стемінг перед вирівнюванням. Стандартна порада для мов з багатими закінченнями; у наших пробах вона знизила точність. Точні форми разом з фразами спрацювали краще.
- Дуже велика вага для пар таксономії. Вона трохи допомогла на невідомих словах у двох мовах і програла на відомих. Робочий діапазон вузький, і ми тримаємося в ньому.
- Покриття таксономією як вага списку. Воно міряє якість перекладу в цій мові, а кількість продуктів, які існують нею, — окрема величина.
- Тест, який не міг побачити ефекту. Наш перший тест таксономії дивився на слова, які база вже знала, і зробив таксономію схожою на марну. Урок: перш ніж довіряти нульовому результату, варто спитати себе, що тест здатен побачити.
Як ми використовуємо це в MuscleTiger
Пошук їжі в MuscleTiger працює так, як описано: ваш запит іде до нашої бази та до Open Food Facts, мовою вашого застосунку і англійською, запит перекладається словником, який живе на вашому телефоні, а чотири ранжування зливаються з вагами, що залежать від вашої мови. Результати показуються мовою інтерфейсу застосунку, а продукти, які продаються у вашій країні, ранжуються попереду решти. Словник працює без мережі, тож запит у залі без сигналу все одно знаходить продукти в нашій локальній базі.
Висновки
- Пошук знаходить потрібний продукт для 92% запитів. У тесті всього пошуку дев’ятьма мовами він стоїть серед перших десяти результатів для 90% запитів і на першому місці для 67%; окремі продукти знаходяться трохи частіше за страви.
- Переклад англійською — це те, що важить. За правильних перекладів додавання англійського списку підвищило частку українських запитів, для яких потрібний продукт у першій п’ятірці, на 61 пункт порівняно з Open Food Facts лише українською; інші мови змінювали мало, а після чотирьох знижували першу п’ятірку.
- Для харчових запитів малий словник може виконати роботу перекладача. Вирівнювання слів на наших власних паралельних назвах дає файл розміром у кілька сотень кілобайтів на мову, працює без мережі й відтворює наші еталонні переклади коротких запитів з F1 за основами слів від 0.94 до 0.96. Це точність перекладу простих запитів; точність пошуку вимірюється окремо і нижча.
- Публічні таксономії найбільше допомагають там, де наші дані мовчать. Навчання словника на них покращило переклад відкладених рідкісних термінів на два–п’ять пунктів у мовах з великою таксономією, при невеликій ціні на поширених словах.
- Вага кожного списку може залежати від того, наскільки велика мова в OFF. Для німецької ця зміна підняла MRR на .062 на наших запитах; для української нічого не змінилося.
- Запасний варіант для друкарських помилок окупається. З друкарською помилкою перше місце падає на 15 пунктів, коли перекладач знає лише точні форми, а запасний варіант з обмеженнями (той самий стем, потім невелика відстань редагування) повертає половину цього; для запитів як вони є він не коштує нічого, що ми можемо виміряти.
- Зіставлення важило більше за мови. Зважування слів за рідкістю, стемінг і один формат чисел дали найбільший виграш дослідження.
Обмеження. Запити написали ми і оцінила мовна модель, тож межі похибки широкі (близько пунктів на 200 запитах). Числа стосуються німецької та української; ваги інших мов екстраполовані. Ми не порівнювали з нейромережевим перекладачем чи з іншими застосунками. Наступний крок — перевірка на реальних запитах користувачів.
Дані та ліцензії
Дані про продукти та таксономії походять з Open Food Facts, які доступні за Open Database License (ODbL); словники, описані тут, частково походять від таксономій OFF і несуть ту саму атрибуцію. Наша локальна база побудована на відкритих національних таблицях складу харчових продуктів, які опублікували державні органи; їхні джерела та ліцензії перелічено в застосунку. Ми дякуємо учасникам Open Food Facts і супровідникам національних таблиць.
Джерела
- Brown PF, Della Pietra SA, Della Pietra VJ, Mercer RL. The mathematics of statistical machine translation: parameter estimation. Computational Linguistics 1993;19(2):263–311. ACL Anthology
- Moore RC. Improving IBM word-alignment Model 1. Proceedings of ACL 2004:518–525. ACL Anthology
- Cormack GV, Clarke CLA, Büttcher S. Reciprocal rank fusion outperforms Condorcet and individual rank learning methods. Proceedings of SIGIR 2009. doi:10.1145/1571941.1572114
- Darwish K, Oard DW. Probabilistic structured query methods. Proceedings of SIGIR 2003.
- Dyer C, Chahuneau V, Smith NA. A simple, fast, and effective reparameterization of IBM Model 2. Proceedings of NAACL-HLT 2013:644–648. ACL Anthology
- Open Food Facts: taxonomies of ingredients and categories and product data, world.openfoodfacts.org, under the Open Database Licence (ODbL).
- Riley D, Gildea D. Improving the IBM alignment models using variational Bayes. Proceedings of ACL (short papers) 2012:306–310. ACL Anthology
- Östling R, Tiedemann J. Efficient word alignment with Markov chain Monte Carlo. The Prague Bulletin of Mathematical Linguistics 2016;106:125–146.
- Mermer C, Saraçlar M. Bayesian word alignment for statistical machine translation. Proceedings of ACL (short papers) 2011:182–187. ACL Anthology
- Jalili Sabet M, Dufter P, Yvon F, Schütze H. SimAlign: high quality word alignments without parallel training data using static and contextualized embeddings. Findings of EMNLP 2020.