MuscleTiger Forschungsnotizen · Nr. 5
Lebensmittelsuche in jeder Sprache: Anfragen übersetzen, Datenbanken zusammenführen und was wir gemessen haben
Du tippst „Spiegelei mit Speck“ oder „борщ з м’ясом“ in ein Ernährungstagebuch und erwartest, ein Produkt mit Kalorien und Makronährstoffen zu sehen. Die größten offenen Lebensmitteldatenbanken sind überwiegend auf Englisch und Französisch verfasst, die Menschen suchen aber in ihrer eigenen Sprache, mit Markennamen, Wortendungen und Tippfehlern. Diese Notiz beschreibt, wie wir die Lebensmittelsuche in MuscleTiger gebaut haben, was wir ausprobiert haben, was sich als überflüssig erwies und was wir gemessen haben.
Kurz gesagt
Unsere Lebensmittelsuche findet bei 92 % der Anfragen in neun Sprachen das gemeinte Lebensmittel (Abschnitt 3). Wir durchsuchen vier Listen gleichzeitig (unsere eigene Lebensmittelbasis auf Englisch und in der Sprache des Nutzers sowie Open Food Facts in der Sprache des Nutzers und auf Englisch) und führen die Rangfolgen mit Reciprocal Rank Fusion zusammen. Eine Anfrage in einer anderen Sprache wird zuerst ins Englische übersetzt. Zuerst verwendeten wir einen neuronalen Übersetzer auf dem Gerät, dann ersetzten wir ihn durch ein kleines Wörterbuch, das aus unseren eigenen parallelen Lebensmittelnamen mit einem Wortaligner aus der Familie von IBM Model 2 mit einem bayesschen Prior gelernt wurde, und aus den Taxonomien von Open Food Facts. Bei unseren Testanfragen reproduziert das Wörterbuch die englische Referenzübersetzung mit einem Wortstamm-F1 von 0.94 (Deutsch) und 0.96 (Ukrainisch); das misst die Übersetzung kurzer, einfacher Anfragen. Mit korrekten Übersetzungen erhöht das Hinzufügen der englischen Liste den Anteil ukrainischer Anfragen, bei denen das richtige Produkt in den Top 5 steht, um 61 Punkte; weitere Sprachen bringen wenig. Die Gewichte der vier Listen, die davon abhängen, wie groß die Sprache in Open Food Facts ist, verbesserten Deutsch und ließen Ukrainisch unverändert. Eine Absicherung für Tippfehler im Übersetzer holt etwa die Hälfte der 15 Punkte zurück, die ein Fehler kostet.
Wir erklären den Ansatz und die Verfahrensfamilien, die wir in Betracht gezogen haben.
1. Das Problem: eine Anfrage in einer Sprache, Daten in mehreren
Eine Lebensmittelsuche muss drei Dinge gleichzeitig gut leisten. Sie muss eine kurze und unordentliche Anfrage verstehen („Hähnchenbrust 200g“, „coca cola zero“, „мигдальне молоко“). Sie muss ein Produkt mit vollständigen und plausiblen Nährwerten finden. Und sie muss in der Sprache der Person funktionieren, auf dem Telefon, schnell und idealerweise offline.
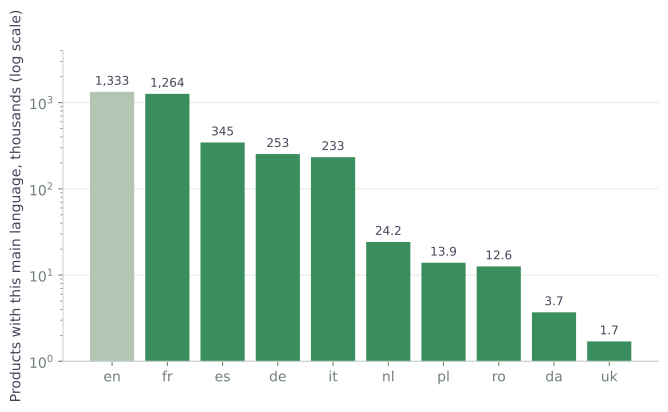
Die Daten, die wir nutzen können, sind ungleich verteilt. Open Food Facts (OFF) [6], die offene Datenbank verpackter Produkte, enthält Millionen von Produkten, doch die Sprache eines Produkts folgt dem Land, in dem es verkauft wird, und den Gewohnheiten seiner Beitragenden. Zählt man Produkte nach ihrer Hauptsprache (OFF, 15. November 2026), führen Englisch und Französisch mit je etwa 1.3 Millionen Produkten, danach folgen Spanisch, Deutsch und Italienisch mit 230 bis 350 Tausend, und die kleineren Sprachen, die wir unterstützen, haben zwischen 1.7 und 25 Tausend (Abbildung 1). Eine Anfrage auf Ukrainisch kann also von sehr wenigen Produkten auf Ukrainisch beantwortet werden, während eine Anfrage auf Französisch auf eine Datenbank trifft, die von Haus aus überwiegend französisch ist.
Unsere eigene Basis
Die zweite Quelle ist unsere eigene Basis mit Lebensmitteln, die vollständige Energie- und Makronährstoffwerte haben. Sie ist eine Zusammenführung mehrerer nationaler Nährwerttabellen, ausgewählt, weil sie offen, im Labor gemessen und bei den Makronährstoffen vollständig sind. Viele ihrer Lebensmittel haben Haushaltsportionen wie „1 Scheibe“. Ein Lebensmittel wird übersprungen, wenn bereits eines mit demselben Namen in der Basis steht, und neue Zeilen werden immer nach den alten angehängt, sodass sich die Nummer eines Produkts und seiner Übersetzungen nie ändert, wenn eine Tabelle hinzukommt.
Als wir später drei weitere Tabellen hinzufügten, stieg der Anteil der Testanfragen, bei denen das richtige Produkt in den Top 5 stand, um 3 Punkte, und der Anteil auf dem ersten Platz um 2 Punkte; keine der beiden Änderungen ist signifikant. Der Gewinn kam vor allem von gängigen Gerichten, die die neuen Tabellen auf einfachem Englisch beschreiben, etwa lasagna, cappuccino oder Greek yoghurt. Eine Tabelle, die wir in Erwägung gezogen hatten, haben wir weggelassen, weil ihre Lizenz eine Share-alike-Klausel enthält, die sich auf unsere zusammengeführte Basis ausweiten könnte.
Die Tabellen sind auf Englisch oder in der Sprache ihres Landes verfasst, daher mussten die Namen in den anderen Sprachen erst erstellt werden. Die englischen Namen sind das Original; die Namen in den anderen Sprachen wurden durch maschinelle Übersetzung erzeugt und zum Teil später von Sprachmodell-Agenten mit automatischen Prüfungen überarbeitet (ein Validator weist eine Antwort zurück, die Zahlen, Einheiten oder die Struktur des Namens verändert). Zahlen in Namen verwenden in jeder Sprache einen Dezimalpunkt, in der Basis wie in der Anfrage, damit eine Anfrage mit einem Fettanteil das Produkt mit genau diesem Prozentsatz bevorzugen kann.
2. Vier Listen und eine Rangfolge
Der Entwurf, den wir verwenden, lässt sich einfach beschreiben. Jede Anfrage wird an vier Stellen gesucht:
- A: unsere lokale Basis, mit der ins Englische übersetzten Anfrage;
- B: unsere lokale Basis, mit der Anfrage so, wie sie in der Sprache des Nutzers eingegeben wurde;
- C: Open Food Facts, in der Sprache des Nutzers durchsucht;
- D: Open Food Facts, mit der englischen Übersetzung durchsucht.
Jede Liste liefert ihre eigene Rangfolge, und die Rangfolgen werden durch Reciprocal Rank Fusion (RRF) [3] zusammengeführt. Ein Produkt, das in mehreren Listen weit oben steht, schlägt ein Produkt, das nur in einer Liste auf Platz eins steht:
wobei die Position des Produkts in der Liste ist, ein Gewicht der Liste und eine kleine Konstante, die verhindert, dass der erste Platz alles dominiert. Die Methode braucht keine Punktwerte aus den Listen, nur deren Reihenfolge; das ist wichtig, weil die Listen aus verschiedenen Systemen stammen, deren Punktwerte nicht vergleichbar sind. Genau deshalb haben wir sie gewählt. Cormack et al. berichten, dass sie in ihren Experimenten mit aufwendigeren Rank-Learning-Verfahren konkurrenzfähig ist [3].
RRF ist eine veröffentlichte Methode, und unser Beitrag ist die Messung: welche Listen einbezogen werden, wie die Anfrage übersetzt wird und wie stark man jeder Liste in jeder Sprache vertraut.
3. Wie wir gemessen haben
Das Vorgehen:
- Wir haben Anfragesets in mehreren Typen geschrieben: Marke plus Produkt, Gericht, Alltagslebensmittel, Getränk sowie umgangssprachliche oder fehlerhaft geschriebene Anfragen. Ein Set umfasst 959 Anfragen, von denen 200 im Detail bewertet wurden; ein zweites Set hat 200 Anfragen, 100 auf Deutsch und 100 auf Ukrainisch, mit je 20 jedes Typs. Ein eigenes Set mit Gerichten aus fremden Küchen (zum Beispiel ein japanisches Gericht, auf Deutsch gefragt) prüft, ob die Sprache der Anfrage dem Gericht folgen sollte.
- Für jede Anfrage haben wir die Top-Ergebnisse jeder Konfiguration zusammengefasst, und ein Sprachmodell hat jeden Kandidaten als relevant oder nicht relevant bewertet. Es sah die Anfrage und die englische Übersetzung, aber nicht, welche Konfiguration den Kandidaten geliefert hatte. Der Bewerter konnte also keine Methode bevorzugen.
- Wir berichten Top-1 (das richtige Produkt steht an erster Stelle), Top-5 (es steht unter den ersten fünf) und MRR, den Mittelwert von des ersten relevanten Ergebnisses. Für Vergleiche zwischen Konfigurationen paaren wir die Ergebnisse nach Anfrage und verwenden Vorzeichentests und Bootstrap-Intervalle.
Genauigkeit der gesamten Suche
Die Zahl in der Zusammenfassung stammt aus einem Test der Suche genau so, wie sie in der App läuft. Wir haben in jeder der neun Sprachen, die die App außer Englisch unterstützt, zehn Anfragen geschrieben, zwei von jedem Typ, insgesamt 90 Anfragen. Jede Anfrage durchlief dieselben Schritte wie auf dem Handy: Übersetzung mit dem Wörterbuch, unsere Datenbank auf Englisch und in der Sprache der Anfrage, Open Food Facts in beiden Sprachen, wobei die im Land dieser Sprache verkauften Produkte nach vorn rücken, und die Fusion mit den Gewichten der App. Wir haben die gesamte zusammengeführte Liste jeder Anfrage gelesen, im Schnitt etwa sechzig Ergebnisse, und von Hand das erste Ergebnis markiert, das ein Nutzer als das gemeinte Lebensmittel akzeptieren würde, nach denselben Regeln wie der blinde Bewerter.
| Das gemeinte Lebensmittel wird gefunden | Alle Anfragen (90) | Einzelne Produkte (65) | Gerichte (25) |
|---|---|---|---|
| irgendwo in der Liste | 92.2% | 93.8% | 88.0% |
| unter den ersten zehn | 90.0% | 90.8% | 88.0% |
| unter den ersten fünf | 85.6% | 86.2% | 84.0% |
| auf dem ersten Platz | 66.7% | 67.7% | 64.0% |
Genauigkeit der gesamten Suche. Zehn Anfragen in jeder von neun Sprachen, gesucht wie in der App. Einzelne Produkte sind Lebensmittel, verpackte Produkte und Getränke; zu den Gerichten zählen auch zusammengesetzte Mahlzeiten wie ein Käsebrot oder Haferflocken mit Milch.
Das gemeinte Lebensmittel steht bei 92 % der Anfragen irgendwo in der Liste, bei 90 % unter den ersten zehn Ergebnissen, bei 86 % unter den ersten fünf und bei 67 % auf dem ersten Platz. Einzelne Produkte werden etwas häufiger gefunden als Gerichte (94 % gegenüber 88 % irgendwo in der Liste). Die Fehlschläge sind meist Markenprodukte, die keine Liste enthält, und Snacks aus mehreren Lebensmitteln, für die die Listen die Zutaten anbieten, den Snack selbst aber nicht. Zehn Anfragen pro Sprache sind eine kleine Basis: Eine Anfrage verschiebt das Ergebnis einer Sprache um zehn Punkte, daher beschreiben die Zahlen die Suche als Ganzes und sagen wenig über eine einzelne Sprache. Die folgenden Abschnitte zerlegen die Suche und messen jeden Schritt an größeren Anfragesätzen auf Deutsch und Ukrainisch.
4. Was eine korrekte Übersetzung für die Suche bringt
Bevor wir beschreiben, wie wir versucht haben, einen guten Übersetzer zu bauen, haben wir gemessen, was eine gute Übersetzung wert ist. Wir haben 100 Lebensmittelanfragen auf Ukrainisch geschrieben (je 20 aus Alltagslebensmitteln, Gerichten, Getränken, Marken und umgangssprachlichen Anfragen) und jede von Hand in die anderen neun Sprachen übersetzt, sodass die Übersetzung korrekt ist. Für jede Sprache haben wir Open Food Facts mit der Anfrage in dieser Sprache durchsucht und die Listen mit Reciprocal Rank Fusion zusammengeführt (Gleichung 1, gleiche Gewichte). Die erste Konfiguration ist Ukrainisch allein, die zweite fügt Englisch hinzu, dann kamen Französisch, Spanisch, Deutsch, Italienisch, Niederländisch, Polnisch, Rumänisch und Dänisch hinzu, in der Reihenfolge, wie viele Produkte jede Sprache in OFF hat (Abbildung 2). Die Relevanz wurde blind von einem Sprachmodell nach den Regeln aus Abschnitt 3 bewertet, über die gepoolten Top 5 jeder Konfiguration.
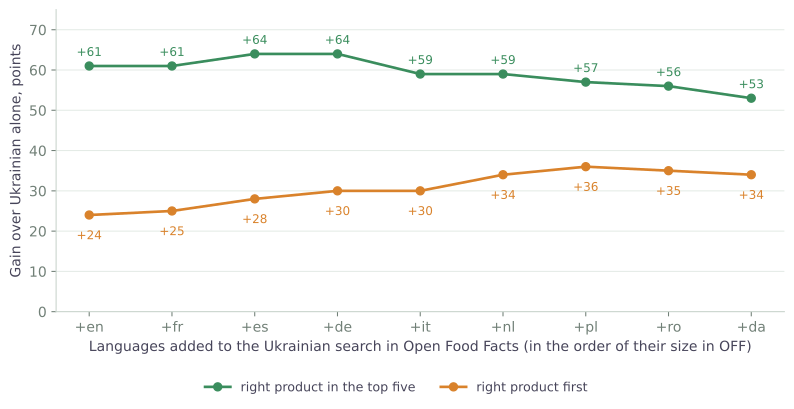
Der erste Schritt ist mit Abstand der größte. Die Suche in OFF nur auf Ukrainisch findet oft gar nichts: OFF hat nur wenige ukrainischsprachige Produkte (Abbildung 1), und bei 47 der 100 Anfragen war die ukrainische Liste leer. Das Hinzufügen der englischen Übersetzung erhöht den Anteil der Anfragen, bei denen das richtige Produkt in den Top 5 steht, um 61 Punkte und auf dem ersten Platz um 24 Punkte, mit 61 gewonnenen Anfragen und keiner verlorenen.
Die nächsten Sprachen ändern wenig. Französisch lässt die Top 5 unverändert (5 Anfragen gewonnen, 5 verloren). Spanisch und Deutsch bringen weitere 3 Punkte, innerhalb des Rauschens. Danach fällt die Top 5 mit allen zehn Sprachen um 11 Punkte von ihrem Höchstwert, während der erste Platz um weitere 10 bis 12 Punkte steigt. Der Rückgang von vier auf zehn Sprachen in den Top 5 ist bei diesen Anfragen signifikant (2 gewonnen, 13 verloren, Vorzeichentest p = 0.007); der Anstieg des ersten Platzes von zwei auf zehn Sprachen ist es nicht (20 gewonnen, 10 verloren, p = 0.10). Marken verhalten sich anders als Alltagslebensmittel: Mit mehr Listen wird eine Markenanfrage öfter gefunden (15 Punkte mehr in den Top 5 mit zusätzlichem Spanisch als mit Englisch allein), während Alltagslebensmittel seltener gefunden werden (25 Punkte weniger mit zehn Sprachen als mit Englisch). Zwanzig Anfragen je Typ sind eine kleine Basis, daher sind diese Aufteilungen nur richtungweisend.
Eine korrekte Übersetzung ins Englische trägt den Effekt. Jede weitere Sprache ist eine weitere Anfrage an OFF und verwässert, ab den ersten wenigen, die Rangfolge.
Gerichte aus einer anderen Küche
Der Schritt ins Englische ist am wichtigsten, wenn das Gericht aus einer anderen Küche stammt. Ein eigenes Set von 100 Anfragen, je zehn in jeder der zehn Sprachen, nannte ein bekanntes ausländisches Gericht so, wie es ein Nutzer eintippen würde: Borschtsch für einen deutschen Nutzer, paella, pierogi, tiramisu, stroopwafel, sarmale. Dies ist ein älteres Experiment, und die Anfragen wurden mit dem neuronalen Übersetzer übersetzt, den die App damals verwendete (Abschnitt 5). Für die 90 nicht englischen Anfragen hob die Übersetzung der Anfrage ins Englische den Anteil, bei dem das Gericht in den Top 5 steht, um 34 Punkte gegenüber einer Suche in Open Food Facts in der eigenen Sprache des Nutzers (47 Anfragen gewonnen, keine verloren, p < 0.001). Weitere Sprachen nach Englisch änderten in den Top 5 nichts, auch dann nicht, wenn wir vorab die Sprache des Herkunftslandes des Gerichts gewählt hatten.
Unsere lokale Basis half hier: Ohne ihre englische Liste fiel der erste Platz bei diesen Anfragen um 8 Punkte (7 verloren, keine gewonnen, p = 0.016), weil die Basis paella, ratatouille oder lasagna kennt und sie an erste Stelle setzt. Bei Alltagslebensmitteln zeigte sie keinen solchen Vorteil, doch das Entfernen machte die Suche auch nicht besser (Abschnitt 10), daher behalten wir sie. Die verbleibenden Fehler waren Gerichte, die keine OFF-Liste unter irgendeinem Namen führt, etwa sarmale. Das Set hat nur etwa zwanzig verschiedene Gerichte und beschreibt daher bekannte Gerichte gut, über seltene Gerichte sagt es wenig.
Das Abgleichen war wichtiger als die Sprachen
Die größte einzelne Verbesserung der ganzen Studie kam vom Abgleichen von Wörtern in der lokalen Basis, ganz ohne Übersetzung. Die lokale Basis wird mit ihrem eigenen Abgleich durchsucht, und Funktionswörter, Kasusendungen und Dezimalkommas haben ihn gestört: „soup with mushrooms“ auf Ukrainisch lieferte nichts, weil der Abgleich verlangte, dass jedes Wort der Anfrage so gefunden wird, wie es eingegeben wurde. Die Gewichtung der Anfragewörter nach ihrer Seltenheit (IDF), ein Snowball-Stemmer für die Sprachen, die einen haben, und ein einheitliches Zahlenformat verbesserten die Top 5 im Standardset seit Beginn der Studie um etwa 9 % (Vorzeichentest p = 0.008), und bei Anfragen mit Präpositionen und Wortformen um etwa 12 %.
5. Warum wir den Übersetzer ersetzt haben
Wir haben ML Kit entfernt, weil es Lebensmittelnamen schlecht übersetzt. Es ist ein allgemeiner Übersetzer für Sätze, und ein Lebensmittelname besteht aus wenigen Wörtern ohne Kontext: einer Marke, einem Zustand des Produkts, einem Gericht, das nach einem Ort benannt ist. Unsere Basis wurde zuerst damit übersetzt, und hier sind echte Einträge (die ukrainischen und französischen Übersetzungen, mit einer Erklärung für Leser, die die Sprache nicht sprechen):
| Englischer Name | Ausgabe von ML Kit | Was schiefging |
|---|---|---|
| plain, refrigerated | рівнина, холодильна (Ukrainisch) | “plain” bedeutet hier ungewürzt, wie in plain yoghurt, und wurde als “plain” im Sinne von Ebene übersetzt; “refrigerated” wurde zu einem Adjektiv mit der Bedeutung “aus einem Kühlschrank” |
| boneless | безкімнатний (Ukrainisch) | bedeutet “ohne Räume”; gemeint ist “ohne Knochen” |
| Pad Thai | Подушка тайська (Ukrainisch) | der Gerichtsname wurde als Wörter gelesen: “thailändisches Kissen” |
| Rice flour, brown | Рисова борошно, коричневий (Ukrainisch) | die Adjektive stimmen nicht mit dem Substantiv “Mehl” überein, was im Ukrainischen ungrammatisch ist |
| Meringue with chocolate; Ham salad spread | teilweise oder ganz unübersetzt gelassen (Ukrainisch) | die englischen Wörter bleiben im Namen |
| bun | chignon (Französisch) | ein Haarknoten (die Frisur), gemeint war das Brötchen |
| sauerkraut | chouchoune (Französisch) | ein anderes Wort; das französische Wort für Sauerkraut ist choucroute |
Dasselbe Problem betrifft Anfragen, bei denen ein falsches Wort ein fehlendes Produkt bedeutet, und es lässt sich lokal nicht beheben: Man kann ein einzelnes Wort in einem neuronalen Modell nicht korrigieren. Es gab zwei kleinere Gründe: Die Modelle brauchen etwa 40 MB je Sprache, und das SDK ist eine Komponente eines Drittanbieters.
Die Daten, die wir besitzen, weisen auf ein besseres Werkzeug hin. Unsere Basis hat Paare aus einem englischen Namen und seinem Namen in jeder Sprache, ein paralleles Korpus genau in der Domäne, die wir brauchen. Ein Wörterbuch lässt sich aus einem solchen Korpus lernen.
6. Ein durch Wortalignment gelerntes Wörterbuch
Ein Wörterbuch aus parallelem Text zu lernen ist das alte Problem des Wortalignments: zu entscheiden, welches Wort des einen Satzes welchem Wort des anderen entspricht. Die klassische Familie sind die IBM-Modelle der statistischen maschinellen Übersetzung [1]. Model 1, das einfachste und unser Ausgangspunkt, behandelt einen Namen in einer Sprache als aus den Wörtern der anderen erzeugt, ohne Rücksicht auf die Reihenfolge. Für einen englischen Namen und einen Namen in einer anderen Sprache (mit einem hinzugefügten leeren Wort) ist die Wahrscheinlichkeit des Paares
und die Tabelle der Wortübersetzungswahrscheinlichkeiten , das Wörterbuch, wird durch Erwartungsmaximierung geschätzt: In jeder Runde erhält jedes Wortpaar in einem Namenspaar einen Anteil der Zählung, proportional zur aktuellen Wahrscheinlichkeit, und die Anteile werden zu neuen Wahrscheinlichkeiten normiert. Für einen kurzen Lebensmittelnamen passt das gut, weil es wenig Wortreihenfolge zu modellieren gibt. Seine bekannte Schwäche beschrieb Moore [2]: Ein seltenes Wort kann jede Wahrscheinlichkeit annehmen, die zu seinem einzelnen Satz passt, sodass seltene Wörter zu „Müllsammlern“ werden, die zu viele Wörter aligniert. Moore schlug vor, die Zählungen zu glätten und eine bessere Initialisierung zu verwenden; ein bayesscher Prior auf die Übersetzungswahrscheinlichkeiten, angewandt durch variationelle Inferenz, ist ein weiteres Mittel [7].
Was wir betrachtet und gemessen haben
Wir haben unseren Aligner mit seinen Ablationen verglichen, mit Referenzimplementierungen zweier veröffentlichter Aligner und mit einem Verfahren, das überhaupt kein Alignmentmodell hat. Jede Methode bekam dieselben Namenspaare, dieselben zurückgehaltenen 5 % und dieselbe Art, Alignments in ein Wörterbuch umzuwandeln (ein Wortpaar zählt, wenn es mindestens zweimal verknüpft ist; jedes Wort bekommt seine häufigste Übersetzung). Die Qualität ist das F1 der Wortstämme zwischen der Wörterbuchübersetzung eines zurückgehaltenen Namens, Wort für Wort, und seinem englischen Namen, gemittelt über neun Sprachen (Tabelle 1). Die Unterschiede sind klein, daher berichten wir zusätzlich, in wie vielen der neun Sprachen ein Unterschied eindeutig ist (das 95-%-Bootstrap-Intervall der gepaarten Differenz enthält die Null nicht).
| Methode | Was es ist | Mittleres F1 | Im Vergleich zu unserem |
|---|---|---|---|
| Dice coefficient | kein Alignmentmodell, jedes Wort verknüpft sich mit dem Wort, mit dem es am häufigsten gemeinsam auftritt | 0.812 | schlechter in 7 von 9 |
| IBM Model 1 [1], EM | Wortübersetzungswahrscheinlichkeiten, ohne Wortreihenfolge | 0.817 | schlechter in 6 von 9 |
| Model 1 mit Dirichlet-Prior [7] | variationelles Bayes auf den Übersetzungswahrscheinlichkeiten | 0.822 | schlechter in 4 von 9 |
| Diagonal-Alignment-Prior, EM | Model 2 in der fast_align-Parametrisierung [5], ohne den bayesschen Prior | 0.822 | schlechter in 6 von 9 |
| Unser | Diagonal-Prior und Dirichlet-Prior, zwei Richtungen, Schnittmenge | 0.825 | – |
| Unser, grow-diag-final-and | dasselbe, die Verknüpfungen beider Richtungen werden nach der Standardheuristik kombiniert | 0.828 | besser in 5 von 9, schlechter in 1 |
| fast_align [5] | die Implementierung der Autoren, Schnittmenge / grow-diag-final-and | 0.826 / 0.831 | 3 besser, 2 schlechter / 7 besser |
| eflomal [8] | HMM mit Fertilität, bayesisch, MCMC-Sampling; Schnittmenge / grow-diag-final-and | 0.825 / 0.828 | 2 besser, 2 schlechter / 7 besser |
| SimAlign [10] | multilinguale BERT-Einbettungen, ohne Training auf unseren Namen; drei Abgleichverfahren (bestes / iterativ / Schnittmenge) | 0.824 / 0.822 / 0.812 | 2 besser, 2 schlechter / 1 besser, 3 schlechter / schlechter in 8 |
Tabelle 1. Aligner im Vergleich auf zurückgehaltenen Namen unserer Basis, neun Sprachen. Die letzte Spalte zählt die Sprachen, in denen der Unterschied zu unserem eindeutig ist. fast_align und eflomal sind die Implementierungen der Autoren.
Der reine Dice-Koeffizient liegt nur 0.013 hinter unserem, und SimAlign, das kein Training auf unseren Namen braucht, ist in seiner besten Einstellung mit unserem gleichauf. Bei kurzen, nahezu parallelen Namen spielt die Wahl des Aligners kaum eine Rolle, und der größte Teil der Qualität kommt von den Namen selbst. Jeder Bestandteil unseres Verfahrens trägt ein wenig bei, und der echte fast_align mit derselben Schnittmenge ergibt dasselbe Resultat (0.826 gegen 0.825), was wir von einer Methode mit demselben Entwurf erwarten. Wenn man die beiden Richtungen mit der Standardheuristik grow-diag-final-and kombiniert, hilft das etwa so viel wie die Wahl des Modells: zwischen einem Viertel und einem halben Punkt F1 bei allen dreien. Das ist ein kleiner Gewinn, der in den meisten Sprachen eindeutig ist, und wir planen, ihn beim nächsten Neuaufbau der Wörterbücher zu verwenden.
Das Reduzieren der Wörter auf Snowball-Stämme vor dem Alignment senkt das F1 (0.818, schlechter in 6 von 9 Sprachen), und das Behalten nur der ersten vier Buchstaben jedes Wortes, das Östling und Tiedemann als nützliche näherungsweise Stammbildung für maschinelle Übersetzung berichten [8], senkt es noch viel stärker (0.743). Die Aufgabe erklärt den Unterschied: Östling und Tiedemann messen Übersetzungssysteme, die auf den Alignments aufbauen, und wir suchen einzelne Wörter eines Lebensmittelnamens in einem Wörterbuch nach, wo das Zusammenführen von Wortformen verschiedene Lebensmittel zusammenführt.
Den Gibbs-Sampler von Mermer und Saraçlar [9] (ein vollständig bayessches Model 1), die IBM-Modelle 3–5 oder die probabilistischen strukturierten Anfragen von Darwish und Oard [4], die mehrere Übersetzungen je Wort behalten, haben wir nicht ausgeführt. Letzteres ist ein möglicher nächster Schritt, da unser Wörterbuch nur den besten Kandidaten behält.
Was unser Aligner ist
Unser Aligner ist eine eigene Implementierung eines IBM Model 2 in der fast_align-Parametrisierung [5]: Die Wahrscheinlichkeit, dass ein Wort an eine bestimmte Position aligniert wird, nimmt mit dem Abstand von der Diagonale ab (in Model 1 ist sie gleichverteilt), weil Lebensmittelnamen ihre Wortreihenfolge zwischen Sprachen meist beibehalten. Darüber hinaus erhalten die Wortübersetzungswahrscheinlichkeiten einen dünn besetzten Dirichlet-Prior mit variationeller Inferenz [7], wie in fast_align, der verhindert, dass seltene Wörter die Wahrscheinlichkeit an sich ziehen. Die festen Konstanten (die Wahrscheinlichkeit, ein Wort mit dem leeren Wort zu verknüpfen, die Stärke des Priors und die anfängliche Steilheit der Diagonale) sind die, die Dyer et al. berichten; fast_align schätzt die Steilheit während des Trainings außerdem neu, wir nicht. Er wird in beide Richtungen trainiert, und nur die Verknüpfungen, auf die sich beide Richtungen einigen, werden behalten (Schnittmenge), was die Präzision auf Kosten der Trefferquote erhöht. Wörter werden in ihrer exakten Form ohne Stemming aligniert: Das Reduzieren von Wörtern auf Stämme, das für Sprachen mit reicher Wortbildung üblich ist, senkte in unseren ersten Versuchen die Genauigkeit, daher werden Komposita und Bindestrich-Wörter über Phrasen behandelt.
Das Ergebnis ist ein Wörterbuch in drei Schichten, das der Übersetzer ab der längsten Übereinstimmung von bis zu drei Wörtern anwendet: Taxonomie-Einträge, in unserer Basis alignierte Phrasen und in unserer Basis alignierte einzelne Wörter. Ein Wort, das nicht im Wörterbuch steht, etwa eine Marke oder ein Tippfehler, wird unverändert durchgereicht, weil OFF es oft kennt. Jede Sprache ist eine Datei von einigen hundert Kilobyte, gegenüber etwa 40 MB je Sprache bei den neuronalen Modellen. Es funktioniert offline, und jede Übersetzung lässt sich auf eine Zeile des Wörterbuchs zurückführen und korrigieren.
Wie gut ist die Übersetzung
Wir messen den Übersetzer auf zwei Arten. Bei 5 % der Namenspaare, die vom Training zurückgehalten wurden, ergibt die Übersetzung des fremdsprachigen Namens Wort für Wort, verglichen mit dem englischen Namen über Wortstämme, ein F1 zwischen 0.78 und 0.90 über die neun Sprachen. Bei den Bewertungsanfragen, zu denen wir jeweils eine englische Referenzübersetzung geschrieben haben, beträgt das F1 der Wortstämme 0.94 für Deutsch (88 von 100 Anfragen in den Stämmen identisch) und 0.96 für Ukrainisch (89 von 100).
Diese Zahlen beschreiben die Übersetzung kurzer, gängiger Anfragen ins Englische. Die Qualität der Suche selbst ist niedriger und wird getrennt gemessen (Abschnitte 3 und 9). Wir haben den alten neuronalen Übersetzer nicht auf denselben Anfragen laufen lassen, daher behaupten wir nicht, dass das Wörterbuch besser ist als ML Kit; es ist für diese Anfragen genau genug, klein, offline und korrigierbar.
7. Die Taxonomien von Open Food Facts: was sie bringen und was sie kosten
OFF pflegt öffentliche Taxonomien von Zutaten und Kategorien: hierarchische Listen, in denen jeder Eintrag einen englischen Namen hat und Namen sowie Synonyme in vielen Sprachen, von Freiwilligen geschrieben. Sie enthalten Tausende Einträge mit einem englischen Namen und sind aus drei Gründen attraktiv: Die Übersetzungen stammen von Menschen und aus der Lebensmitteldomäne, sie enthalten Wörter, die unsere eigenen Namen nie verwenden (seltene Zutaten), und sie sind unabhängig von der maschinellen Übersetzung, die unsere Namen erzeugt hat.
Die Schwierigkeiten:
- Ungleichmäßige Abdeckung. Der Anteil der Einträge mit einem Namen in einer bestimmten Sprache reicht von 1.6 % (ukrainische Kategorien) bis 84.6 % (französische Kategorien), daher kann die Taxonomie nicht die einzige Quelle sein. Wir wenden sie zuerst an, wo ein Eintrag existiert, und lassen das Wörterbuch aus unserer Basis den Rest füllen.
- Kategorienartige Namen und viele Synonyme. Ein Eintrag hat einen englischen Namen und viele Synonyme in einer Sprache. Jedes Synonym wird mit dem englischen Hauptnamen gepaart, und sehr lange englische Namen werden übersprungen.
- Phrasen wie auch Wörter. Taxonomienamen sind Phrasen, daher findet der Übersetzer an jeder Position zuerst die längste Phrase, bevor er einzelne Wörter prüft.
- Rauschen. Wenn die Taxonomie auch als Trainingsdaten dient, konkurrieren ihre kategorienartigen Phrasen mit den idiomatischen Phrasen unserer Basis. Ein Gewicht für die Taxonomie-Paare musste gemessen werden. Ein zu großes Gewicht kostete Genauigkeit bei gängigen Wörtern, und der Bereich, der funktioniert, ist eng.
Training auf der Taxonomie: ein Test, der den Effekt nicht sehen konnte
Unser erster Test, Taxonomie-Paare zum Alignment-Training hinzuzufügen, zeigte nichts. Wir haben ihn an zurückgehaltenen Namen unserer eigenen Basis und an unseren Anfragen gemessen, und die Übersetzungsqualität bewegte sich um höchstens einige Tausendstel. Wir hätten fast geschlossen, dass die Taxonomie nur als Nachschlagewerk nützlich ist. Dieser Test konnte den Effekt nicht sehen: Beide Sets enthalten Wörter, die unsere Basis schon kennt, während der Sinn der Taxonomie darin liegt, Wörter hinzuzufügen, die sie nicht kennt.
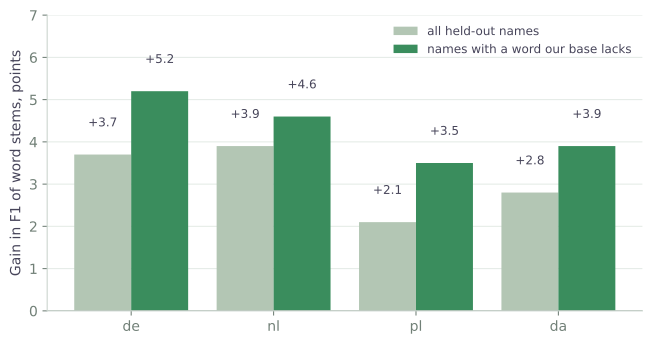
Der faire Test entfernt ein Zehntel der Taxonomie-Einträge aus der Nachschlageebene und aus dem Training, baut das Wörterbuch mit und ohne Taxonomie-Training und übersetzt die Namen der entfernten Einträge. Für die Sprachen mit einer großen Taxonomie bringt das Training zwei bis vier Punkte F1 auf allen zurückgehaltenen Namen und vier bis fünf Punkte auf Namen mit einem Wort, das unserer Basis fehlt, ohne Verlust bei Namen aus bekannten Wörtern (Abbildung 3). Für Sprachen mit kleiner Taxonomie, wie Ukrainisch und Rumänisch, ändert sich nichts. Wir haben unsere frühe Empfehlung umgekehrt, und die Wörterbücher in der App werden mit Taxonomie-Training gebaut.
Wo es schaden kann. Taxonomienamen sind kategorienartig, und ihre Synonyme können eine idiomatische Phrase verdrängen, die aus unserer Basis gelernt wurde („home fries“ für ein Gericht aus frittierten Kartoffeln). Bei den deutschen Anfragen kostete das etwa einen Punkt F1 und bei Ukrainisch nichts, ein Preis, den wir für den Gewinn bei seltenen Wörtern akzeptiert haben.
8. Gewichte der vier Listen nach Sprache
In Gleichung (1) hat jede Liste ein Gewicht. Unsere ersten Gewichte waren für alle Sprachen gleich und auf einem Anfrageset abgestimmt. Die Qualität der Listen unterscheidet sich aber je nach Sprache. Die OFF-Liste in der eigenen Sprache (C) ist auf Französisch oder Deutsch reich und auf Ukrainisch dünn, wo die englische Liste (D) mehr Last trägt. Einer Sprache eigene Gewichte zu geben liegt nahe, und die Frage ist, woher wir sie für zehn Sprachen nehmen, wenn wir Testanfragen nur für zwei haben.
Wir haben zwei Maße erwogen. Das erste war der Anteil der Taxonomie-Einträge, die einen Namen in der Sprache haben. Es ist leicht zu berechnen, misst aber, wie gut Freiwillige den Wortschatz übersetzt haben, was das Wörterbuch betrifft, und sagt wenig darüber, wie viele Produkte einen Namen in dieser Sprache tragen; seine beiden Spalten widersprechen sich sogar (Italienisch: 75 % der Zutaten und 28 % der Kategorien). Wir haben es nicht verwendet. Das zweite war die Anzahl der OFF-Produkte je Sprache im Verhältnis zu Englisch, verfügbar über den Suchdienst (Abbildung 1). Es ist eine Näherungsgröße, weil die Hauptsprache eines Produkts von der Sprache eines Namensfelds abweichen kann, und es verfolgt trotzdem, was wir brauchen: wie wahrscheinlich die eigene Liste das Produkt kennt. Daraus leiten wir mit einer glatten Formel ein Gewicht für jede Sprache ab, das der eigenen Liste mehr Gewicht gibt, je größer die Sprache ist, und die Werte legen wir in einer kleinen Nachschlagetabelle in der App fest.
Bei den 200 bewerteten deutschen und ukrainischen Anfragen ist der Effekt für Deutsch klar und für Ukrainisch nicht vorhanden (Abbildung 4). Das MRR für Deutsch steigt um .062 (95-%-Bootstrap-Intervall der Differenz +.030 bis +.099), und der erste Platz um 7 Punkte, während die Top 5 um 3 Punkte zulegen, was im Rauschen liegt. Das MRR für Ukrainisch sinkt um .002, weil seine neuen Gewichte nahe an den alten gemeinsamen liegen. Der Gewinn für Deutsch zeigt sich in beiden Hälften der Anfragen, wenn man sie in ungerade und gerade aufteilt.
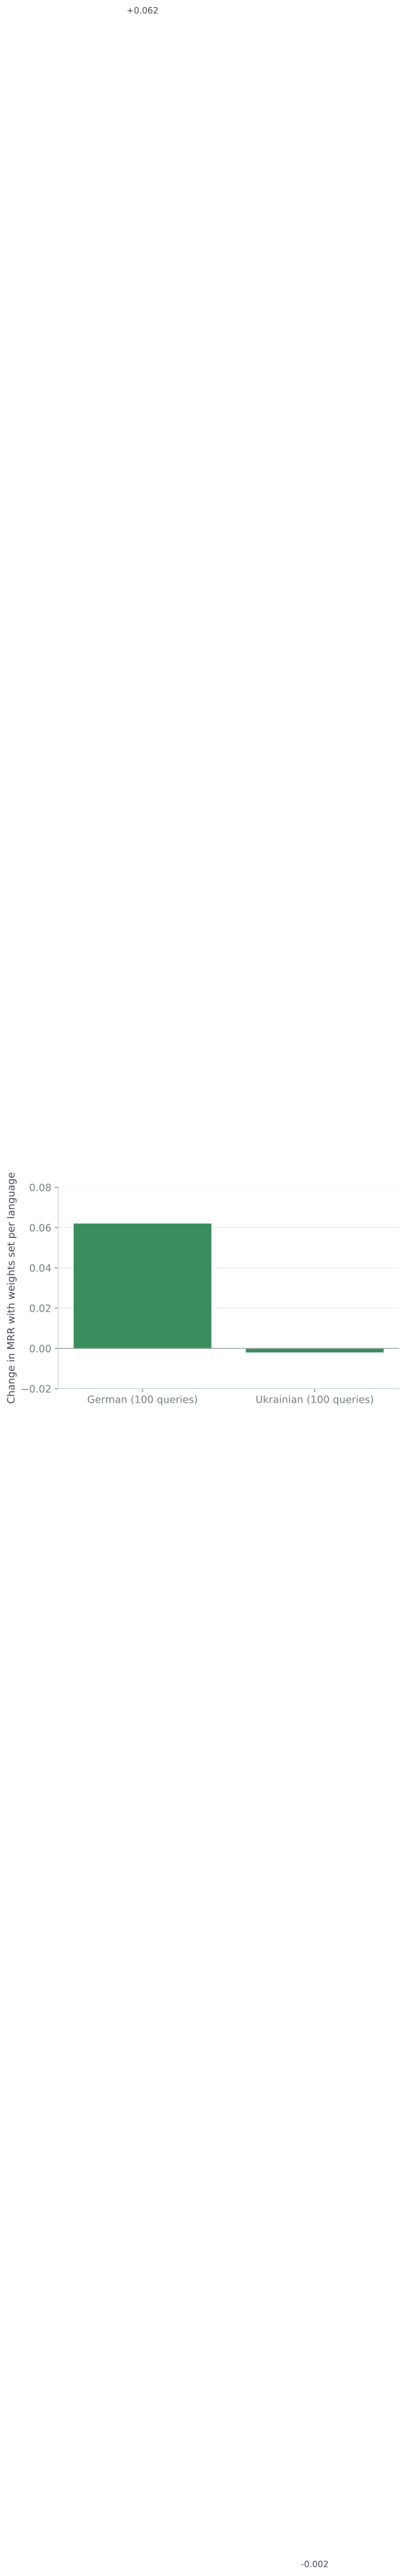
Die Konstanten der Formel wurden an denselben Anfragen festgelegt, und die Gewichte der anderen Sprachen folgen aus der Formel und sind nicht gemessen.
9. Tippfehler und Wortformen
Das Wörterbuch kennt exakte Wortformen. Ein Wort mit einem Tippfehler oder einer Kasusform, die es nicht gesehen hat, bleibt unverändert und erreicht die englischen Listen als ein Wort, das dort nichts bedeutet. Die Suche in unserer lokalen Basis korrigiert Fehler bereits mit einem SymSpell-Index, einem Index der Editierdistanz, bei dem die Zahl der erlaubten Änderungen mit der Länge des Wortes wächst. Die offene Frage war der Übersetzungsschritt, daher haben wir gemessen, was Fehler kosten und was eine Absicherung bringt.
Schritt 1: Fehler und Wortformen, Wort für Wort
Wir haben die Wörterbücher der neun Sprachen aus unseren Namen neu erstellt und aus den zurückgehaltenen Namen die Wörter mit bekannter Übersetzung genommen. Jedes erhielt eine zufällige Änderung (ein Buchstabe gelöscht, eingefügt, ersetzt oder zwei benachbarte Buchstaben vertauscht). Eine Suche innerhalb der erlaubten Editierdistanz gab die Übersetzung des ursprünglichen Wortes für 92.5 % der beschädigten Wörter zurück, gegenüber 0.3 % bei der exakten Suche. Musste der erste Buchstabe übereinstimmen, wie es die Suche in der lokalen Basis verlangen kann, sank der Wert auf 77 %, weil Fehler am ersten Buchstaben dann übersehen werden.
Bei Wortformen haben wir die zurückgehaltenen Wörter genommen, die das Wörterbuch nicht kennt, deren Snowball-Stamm aber dem Stamm eines bekannten Wortes entspricht (meist ein anderer Kasus oder Numerus eines bekannten Wortes). Die Editierdistanz gab für 55 % von ihnen eine richtige Übersetzung, ein gemeinsamer Wortanfang für 63 % und derselbe Stamm für 69 %. Kasusendungen ändern oft mehrere Buchstaben, was die Editiergrenze nicht zulässt. Die übrigen unbekannten Wörter (Marken, seltene Wörter, Zahlen) sind ein Risiko: Die Editierdistanz antwortet bei einem Viertel von ihnen und liegt bei einem Drittel der Antworten richtig. Stämme verwenden wir nur bei der Suche im Wörterbuch; beim Training haben sie die Qualität gesenkt (Abschnitt 6).
Schritt 2: die Absicherung bei den echten Wörterbüchern
Die Wörterbücher in der App lassen Wörter aus, die in beiden Sprachen gleich geschrieben werden, daher ist ein solches Wort für die Absicherung „unbekannt“. Eine einfache Absicherung hat deshalb Wörter verändert, die richtig waren: pizza wurde zu nicoise, pils zu mushroom, das Markenwort Krönung zu curd. Bei Anfragen wie geschrieben fiel das F1 der Wortübersetzung um 3 Punkte. Drei Schutzregeln beseitigen den größten Teil des Schadens: Ein Wort, das selbst ein englisches Wort des Wörterbuchs ist, bleibt unverändert; sehr kurze Wörter bleiben unverändert, und die erlaubte Editierdistanz bleibt klein. Die Reihenfolge ist: exakte Suche, gleicher Stamm, dann eine Änderung. Mit den Schutzregeln sinkt der Verlust bei Anfragen wie geschrieben auf 1.5 Punkte, und bei Anfragen mit einem Fehler steigt das F1 um 30 Punkte.
Schritt 3: die ganze Suche
Das F1 eines Wortes vergleicht eine Übersetzung mit einer Referenz, und eine Suche hat andere Listen, die eine schlechte Übersetzung auffangen können. Daher haben wir die ganze Suche, wie in Abschnitt 3, an 200 Anfragen durchgeführt (100 deutsche und 100 ukrainische): wie geschrieben und mit einem zufälligen Tippfehler in einem Wort jeder Anfrage (195 Anfragen geändert). Jede Anfrage wurde auf vier Arten übersetzt: die korrekte Übersetzung (obere Schranke), das Wörterbuch wie es war, das Wörterbuch mit der einfachen Absicherung und das Wörterbuch mit den Schutzregeln. Die vier Rangfolgen wurden mit den Gewichten der App zusammengeführt, und ein Sprachmodell hat die gepoolten Top-Ergebnisse blind bewertet.
| Übersetzung | Anfragen wie geschrieben erster Platz / Top 5, Punkte | Ein Tippfehler pro Anfrage erster Platz / Top 5, Punkte |
|---|---|---|
| Korrekt (obere Schranke) | +0.5 / −1.0 | +15.0 / +11.5 |
| Wörterbuch, einfache Absicherung | +1.5 / +1.0 | +8.5 / +4.5 |
| Wörterbuch, Absicherung mit Schutzregeln | +2.0 / +0.5 | +7.5 / +4.0 |
Tabelle 2. Änderung gegenüber dem Wörterbuch wie es war, in Punkten des Anteils der Anfragen, bei denen das richtige Produkt an erster Stelle und in den Top 5 steht.
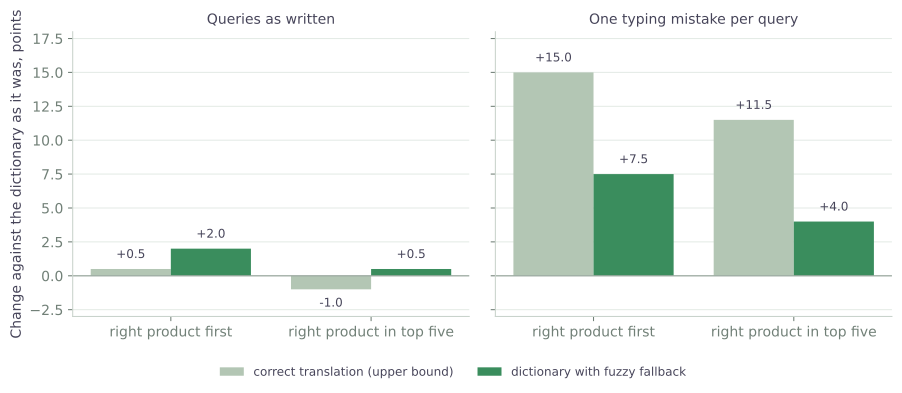
Bei Anfragen wie geschrieben ist das Wörterbuch so gut wie die korrekte Übersetzung (einen halben Punkt zurück auf dem ersten Platz, einen Punkt voraus in den Top 5), und die Absicherung ändert nichts, was wir feststellen können (4 Anfragen gewonnen und keine verloren auf dem ersten Platz, p = 0.13). Bei einem Tippfehler verliert das Wörterbuch wie es war 15 Punkte auf dem ersten Platz; die Absicherung mit Schutzregeln holt 7.5 davon zurück (30 Anfragen gewonnen, 15 verloren, p = 0.04) und 4 der 11.5 Punkte in den Top 5 (11 gewonnen, 3 verloren, p = 0.06). Die Suche, die nur die englische Liste von Open Food Facts nutzt, gewinnt viel mehr, 22 Punkte auf dem ersten Platz, weil sie keine eigene Liste in der Sprache des Nutzers hat, auf die sie zurückfallen kann. Die einfache und die geschützte Absicherung lassen sich in der ganzen Suche nicht unterscheiden; wir behalten die geschützte, weil sie weniger korrekte Wörter verändert. Der Gewinn unterscheidet sich nach Sprache: Ukrainisch gewinnt 15 Punkte auf dem ersten Platz, Deutsch keinen, und warum, haben wir nicht untersucht.
Schritt 4: Grenzen der Messung
Die Tippfehler sind synthetisch: eine zufällige Änderung in fast jeder Anfrage, viel häufiger, als Menschen wirklich tippfehlern, und ohne die Fehler auf benachbarten Tasten einer echten Tastatur. Zweihundert Anfragen und ein Modell als Bewerter ergeben p-Werte um 0.05, daher gibt das Tippfehler-Ergebnis die Richtung an, und die genaue Größe braucht echte Anfragen. Der Gewinn je echter Anfrage ist der obige Gewinn mal dem Anteil der Anfragen mit einem Fehler, den wir nicht kennen; da die Kosten bei korrekten Anfragen etwa null sind, lohnt sich schon ein kleiner Anteil.
10. Was nicht funktioniert hat oder nicht nötig war
- Das Entfernen der lokalen englischen Liste. Auf dem zweiten Anfrageset war die Version ohne sie nicht besser als die Version mit vier Listen (die Top 5 2 Punkte niedriger, MRR .015 niedriger, innerhalb des Rauschens), daher haben wir die Struktur beibehalten.
- Stemming vor dem Alignment. Gängiger Rat für Sprachen mit reicher Wortbildung; in unseren Versuchen hat es die Genauigkeit gesenkt. Exakte Formen mit Phrasen haben besser funktioniert.
- Ein sehr großes Gewicht für Taxonomie-Paare. Es half etwas bei unbekannten Wörtern in zwei Sprachen und verlor bei bekannten Wörtern. Der brauchbare Bereich ist eng, und wir bleiben darin.
- Abdeckung der Taxonomie als Gewicht einer Liste. Sie misst die Übersetzungsqualität in dieser Sprache, und die Zahl der Produkte, die es in ihr gibt, ist eine andere Größe.
- Ein Test, der den Effekt nicht sehen konnte. Unser erster Taxonomietest betrachtete Wörter, die die Basis schon kannte, und ließ die Taxonomie nutzlos erscheinen. Die Lehre ist, bevor man einem Nullergebnis vertraut, zu fragen, was ein Test überhaupt sehen kann.
So nutzen wir das in MuscleTiger
Die Lebensmittelsuche in MuscleTiger funktioniert so, wie beschrieben: Deine Anfrage geht an unsere eigene Basis und an Open Food Facts, in deiner Sprache und auf Englisch, die Anfrage wird durch ein Wörterbuch übersetzt, das auf deinem Telefon liegt, und die vier Rangfolgen werden mit Gewichten zusammengeführt, die von deiner Sprache abhängen. Die Ergebnisse werden in der Sprache der Benutzeroberfläche der App angezeigt, und Produkte, die in deinem Land verkauft werden, stehen vor den übrigen. Das Wörterbuch funktioniert ohne Netzwerk, daher findet eine Anfrage im Fitnessstudio ohne Empfang trotzdem Lebensmittel aus unserer lokalen Basis.
Fazit
- Die Suche findet das gemeinte Lebensmittel bei 92 % der Anfragen. Im Test der gesamten Suche in neun Sprachen steht es bei 90 % unter den ersten zehn Ergebnissen und bei 67 % auf dem ersten Platz; einzelne Produkte werden etwas häufiger gefunden als Gerichte.
- Die Übersetzung ins Englische ist das, worauf es ankommt. Mit korrekten Übersetzungen erhöhte das Hinzufügen der englischen Liste den Anteil ukrainischer Anfragen, bei denen das richtige Produkt in den Top 5 steht, um 61 Punkte gegenüber Open Food Facts allein auf Ukrainisch; weitere Sprachen änderten wenig und senkten ab vier die Top 5.
- Für Lebensmittelanfragen kann ein kleines Wörterbuch die Arbeit des Übersetzers erledigen. Wortalignment auf unseren eigenen parallelen Namen ergibt eine Datei von einigen hundert Kilobyte je Sprache, offline, und reproduziert unsere Referenzübersetzungen kurzer Anfragen mit einem F1 der Wortstämme von 0.94 bis 0.96. Das ist die Genauigkeit bei der Übersetzung einfacher Anfragen; die Genauigkeit der Suche wird getrennt gemessen und ist niedriger.
- Die öffentlichen Taxonomien helfen am meisten dort, wo unsere eigenen Daten schweigen. Das Training des Wörterbuchs auf ihnen verbesserte die Übersetzung seltener Begriffe, die zurückgehalten wurden, um zwei bis fünf Punkte in den Sprachen mit einer großen Taxonomie, bei einem kleinen Verlust bei gängigen Begriffen.
- Das Gewicht jeder Liste kann von der Größe der Sprache in OFF abhängen. Für Deutsch hob die Änderung das MRR um .062 bei unseren Anfragen; bei Ukrainisch änderte sich nichts.
- Eine Absicherung für Tippfehler lohnt sich. Mit einem Tippfehler sinkt der erste Platz um 15 Punkte, wenn der Übersetzer nur exakte Formen kennt, und eine Absicherung mit Schutzregeln (gleicher Stamm, dann eine kleine Editierdistanz) holt die Hälfte davon zurück; bei Anfragen wie geschrieben kostet sie nichts, was wir messen können.
- Das Abgleichen war wichtiger als die Sprachen. Die Gewichtung der Wörter nach Seltenheit, das Stemming und ein einheitliches Zahlenformat brachten den größten Gewinn der Studie.
Grenzen. Die Anfragen haben wir selbst geschrieben und ein Sprachmodell hat sie bewertet, daher sind die Spielräume breit (etwa Punkte bei 200 Anfragen). Die Zahlen gelten für Deutsch und Ukrainisch; die Gewichte der anderen Sprachen sind extrapoliert. Wir haben nicht mit dem neuronalen Übersetzer oder mit anderen Apps verglichen. Der nächste Schritt ist ein Abgleich mit echten Anfragen von Nutzern.
Daten und Lizenzen
Produktdaten und Taxonomien stammen von Open Food Facts und stehen unter der Open Database License (ODbL); die hier beschriebenen Wörterbücher sind teilweise aus den OFF-Taxonomien abgeleitet und tragen dieselbe Namensnennung. Unsere lokale Basis entsteht aus offenen nationalen Nährwerttabellen, die von öffentlichen Behörden veröffentlicht werden; ihre Quellen und Lizenzen sind in der App aufgeführt. Wir danken den Mitwirkenden von Open Food Facts und den Betreuern der nationalen Tabellen.
Quellen
- Brown PF, Della Pietra SA, Della Pietra VJ, Mercer RL. The mathematics of statistical machine translation: parameter estimation. Computational Linguistics 1993;19(2):263–311. ACL Anthology
- Moore RC. Improving IBM word-alignment Model 1. Proceedings of ACL 2004:518–525. ACL Anthology
- Cormack GV, Clarke CLA, Büttcher S. Reciprocal rank fusion outperforms Condorcet and individual rank learning methods. Proceedings of SIGIR 2009. doi:10.1145/1571941.1572114
- Darwish K, Oard DW. Probabilistic structured query methods. Proceedings of SIGIR 2003.
- Dyer C, Chahuneau V, Smith NA. A simple, fast, and effective reparameterization of IBM Model 2. Proceedings of NAACL-HLT 2013:644–648. ACL Anthology
- Open Food Facts: taxonomies of ingredients and categories and product data, world.openfoodfacts.org, under the Open Database Licence (ODbL).
- Riley D, Gildea D. Improving the IBM alignment models using variational Bayes. Proceedings of ACL (short papers) 2012:306–310. ACL Anthology
- Östling R, Tiedemann J. Efficient word alignment with Markov chain Monte Carlo. The Prague Bulletin of Mathematical Linguistics 2016;106:125–146.
- Mermer C, Saraçlar M. Bayesian word alignment for statistical machine translation. Proceedings of ACL (short papers) 2011:182–187. ACL Anthology
- Jalili Sabet M, Dufter P, Yvon F, Schütze H. SimAlign: high quality word alignments without parallel training data using static and contextualized embeddings. Findings of EMNLP 2020.