Notas de investigación de MuscleTiger · N.º 5
Búsqueda de alimentos en cualquier idioma: traducción de consultas, combinación de bases de datos y lo que medimos
Escribes «Spiegelei mit Speck» o «борщ з м’ясом» en un diario de alimentación y esperas ver un producto con calorías y macronutrientes. Las bases de datos abiertas de alimentos más grandes están escritas sobre todo en inglés y francés, mientras que la gente busca en su propio idioma, con nombres de marcas, terminaciones de palabras y erratas. Esta nota describe cómo construimos la búsqueda de alimentos en MuscleTiger, qué probamos, qué resultó innecesario y qué medimos.
En resumen
Nuestra búsqueda de alimentos encuentra el alimento buscado en el 92 % de las consultas en nueve idiomas (sección 3). Buscamos en cuatro listas a la vez (nuestra base de alimentos en inglés y en el idioma del usuario, y Open Food Facts en el idioma del usuario y en inglés) y combinamos los rankings mediante fusión de rangos recíproca. Una consulta en otro idioma se traduce primero al inglés. Al principio usamos un traductor neuronal en el dispositivo; después lo reemplazamos por un pequeño diccionario aprendido de nuestros propios nombres de alimentos paralelos, con un alineador de palabras de la familia IBM Model 2 con un prior bayesiano, y de las taxonomías de Open Food Facts. En nuestras consultas de prueba, el diccionario reproduce la traducción de referencia al inglés con un F1 de raíces de palabra de 0.94 (alemán) y 0.96 (ucraniano). Esto mide la traducción de consultas cortas y simples. Con traducciones correctas, añadir la lista en inglés sube en 61 puntos la proporción de consultas en ucraniano con el producto correcto en el top cinco, y los idiomas adicionales aportan poco. Los pesos de las cuatro listas, que dependen del tamaño de cada idioma en Open Food Facts, mejoraron el resultado en alemán y no cambiaron el ucraniano. Una corrección para errores de escritura en el traductor recupera alrededor de la mitad de los 15 puntos que cuesta un error.
Explicamos el enfoque y las familias de métodos que consideramos.
1. El problema: una consulta en un idioma, datos en varios
Una búsqueda de alimentos tiene que hacer tres cosas bien a la vez. Tiene que entender una consulta corta y desordenada («pechuga de pollo 200g», «coca cola zero», «мигдальне молоко»). Tiene que encontrar un producto con valores nutricionales completos y verosímiles. Y tiene que funcionar en el idioma de la persona, en el teléfono, con rapidez e idealmente sin conexión.
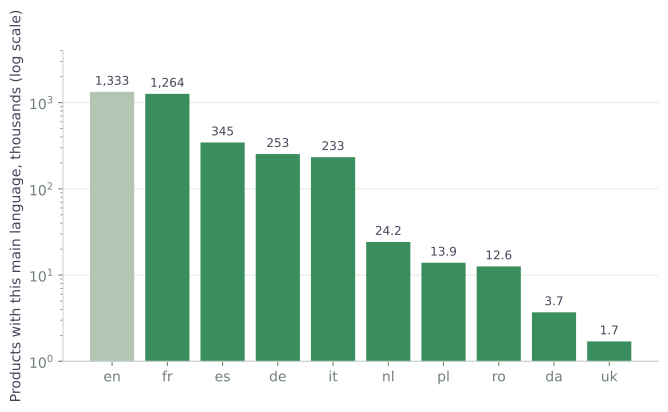
Los datos que podemos usar son desiguales. Open Food Facts (OFF) [6], la base de datos abierta de productos envasados, reúne millones de productos, pero el idioma de un producto depende del país donde se vende y de las costumbres de quienes lo cargan. Si contamos los productos por su idioma principal (OFF, 15 de noviembre de 2026), el inglés y el francés lideran con unos 1.3 millones de productos cada uno; el español, el alemán y el italiano les siguen con entre 230 y 350 mil; y los idiomas más pequeños que soportamos tienen entre 1.7 y 25 mil (figura 1). Una consulta en ucraniano puede tener muy pocas respuestas en ucraniano, mientras que una consulta en francés encuentra una base de datos que ya es mayoritariamente francesa.
Nuestra propia base
La segunda fuente es nuestra propia base de alimentos con energía y macronutrientes completos. Es una combinación de varias tablas nacionales de composición de alimentos, elegidas porque son abiertas, medidas en laboratorio y completas en macronutrientes. Muchos de sus alimentos tienen porciones caseras como «1 rebanada». Se omite un alimento cuando ya existe otro con el mismo nombre en la base, y las filas nuevas siempre se añaden después de las antiguas, de modo que el número de un producto y sus traducciones nunca cambia cuando se añade una tabla.
Cuando después añadimos tres tablas más, la proporción de consultas de prueba con el producto correcto en el top cinco subió 3 puntos, y en el primer lugar 2 puntos; ninguno de los dos cambios es significativo. La mejora vino sobre todo de platos comunes que las nuevas tablas describen en inglés sencillo, como lasagna, cappuccino o Greek yoghurt. Dejamos fuera una tabla candidata, porque su licencia tiene una cláusula de share-alike que podría extenderse a nuestra base combinada.
Las tablas están escritas en inglés o en el idioma de su país, así que los nombres en los demás idiomas hubo que crearlos. Los nombres en inglés son los originales; los de los demás idiomas se produjeron con traducción automática y en parte se rehicieron después con agentes de modelos de lenguaje y comprobaciones automáticas (un validador rechaza una respuesta que cambie números, unidades o la estructura del nombre). Los números dentro de los nombres usan punto decimal en todos los idiomas, tanto en la base como en la consulta, para que una consulta con un porcentaje de grasa pueda preferir el producto con ese porcentaje.
2. Cuatro listas y un solo ranking
El diseño que usamos es simple de enunciar. Cada consulta se busca en cuatro lugares:
- A: nuestra base local, con la consulta traducida al inglés;
- B: nuestra base local, con la consulta tal como la escribió el usuario en su idioma;
- C: Open Food Facts, buscada en el idioma del usuario;
- D: Open Food Facts, buscada con la traducción al inglés.
Cada lista devuelve su propio ranking, y los rankings se combinan mediante fusión de rangos recíproca (RRF) [3]. Un producto que aparece cerca de la cima en varias listas supera a un producto que está primero solo en una:
donde es la posición del producto en la lista , es un peso de la lista y es una constante pequeña que evita que el primer lugar domine. El método usa únicamente el orden de cada lista, lo que importa porque las listas vienen de sistemas distintos con puntuaciones incomparables. Lo elegimos por esa razón; Cormack et al. informan que es competitivo con métodos de aprendizaje de rangos más elaborados en sus experimentos [3].
RRF es un método publicado, y nuestra contribución es la medición: qué listas incluir, cómo traducir la consulta y cuánto confiar en cada lista en cada idioma.
3. Cómo medimos
El protocolo:
- Redactamos conjuntos de consultas de varios tipos: marca más producto, plato, alimento cotidiano, bebida, y consultas informales o con erratas. Un conjunto tiene 959 consultas, de las cuales 200 se evaluaron en detalle; un segundo conjunto tiene 200 consultas, 100 en alemán y 100 en ucraniano, con 20 de cada tipo. Un conjunto aparte de platos de cocinas extranjeras (por ejemplo, un plato japonés preguntado en alemán) comprueba si el idioma de la consulta debe seguir al plato.
- Para cada consulta reunimos los primeros resultados de cada configuración, y un modelo de lenguaje juzgó cada candidato como relevante o no, viendo la consulta y su traducción al inglés, pero no qué configuración devolvió el candidato. El juez no podía, por tanto, favorecer ningún método.
- Informamos el top-1 (el producto correcto está primero), el top-5 (está entre los cinco primeros) y el MRR, la media de del primer resultado relevante. Para las comparaciones entre configuraciones emparejamos los resultados por consulta y usamos pruebas de signo e intervalos de bootstrap.
Precisión de la búsqueda completa
La cifra del resumen procede de una prueba de la búsqueda tal como funciona en la app. Escribimos diez consultas en cada uno de los nueve idiomas que la app admite además del inglés, dos de cada tipo, 90 consultas en total. Cada consulta pasó por los mismos pasos que en un teléfono: traducción con el diccionario, nuestra base en inglés y en el idioma de la consulta, Open Food Facts en ambos idiomas con los productos que se venden en el país de ese idioma por delante, y la fusión con los pesos de la app. Leímos la lista fusionada completa de cada consulta, unos sesenta resultados de media, y marcamos a mano el primer resultado que un usuario aceptaría como el alimento que buscaba, con las mismas reglas que el juez ciego.
| Se encuentra el alimento buscado | Todas las consultas (90) | Productos simples (65) | Platos (25) |
|---|---|---|---|
| en cualquier lugar de la lista | 92.2% | 93.8% | 88.0% |
| entre los diez primeros | 90.0% | 90.8% | 88.0% |
| entre los cinco primeros | 85.6% | 86.2% | 84.0% |
| en primer lugar | 66.7% | 67.7% | 64.0% |
Precisión de la búsqueda completa. Diez consultas en cada uno de los nueve idiomas, buscadas como en la app. Los productos simples son alimentos, productos envasados y bebidas; los platos incluyen también comidas compuestas, como un sándwich de queso o copos de avena con leche.
El alimento buscado aparece en algún lugar de la lista en el 92 % de las consultas, entre los diez primeros resultados en el 90 %, entre los cinco primeros en el 86 % y en primer lugar en el 67 %. Los productos simples se encuentran algo más a menudo que los platos (94 % frente a 88 % en cualquier lugar de la lista). Los fallos son sobre todo productos de marca que ninguna lista contiene y tentempiés hechos con varios alimentos, para los que las listas ofrecen los ingredientes pero no el tentempié en sí. Diez consultas por idioma es una base pequeña: una sola consulta mueve el resultado de un idioma diez puntos, así que las cifras describen la búsqueda en conjunto y dicen poco de un idioma concreto. Las secciones siguientes desmontan la búsqueda y miden cada paso con conjuntos de consultas más grandes en alemán y ucraniano.
4. Qué aporta una traducción correcta a la búsqueda
Antes de describir nuestros intentos de construir un buen traductor, medimos cuánto vale una buena traducción. Escribimos 100 consultas de alimentos en ucraniano (20 de cada tipo: alimentos cotidianos, platos, bebidas, marcas e informales) y las tradujimos a mano a los otros nueve idiomas, de modo que la traducción es correcta por construcción. Para cada idioma buscamos en Open Food Facts con la consulta en ese idioma y combinamos las listas con fusión de rangos recíproca (ecuación 1, pesos iguales). La primera configuración es solo ucraniano; la segunda añade el inglés; y luego añadimos francés, español, alemán, italiano, neerlandés, polaco, rumano y danés, en el orden del número de productos de cada idioma en OFF (figura 2). La relevancia la juzgó a ciegas un modelo de lenguaje con las reglas de la sección 3, sobre los primeros cinco resultados agrupados de cada configuración.
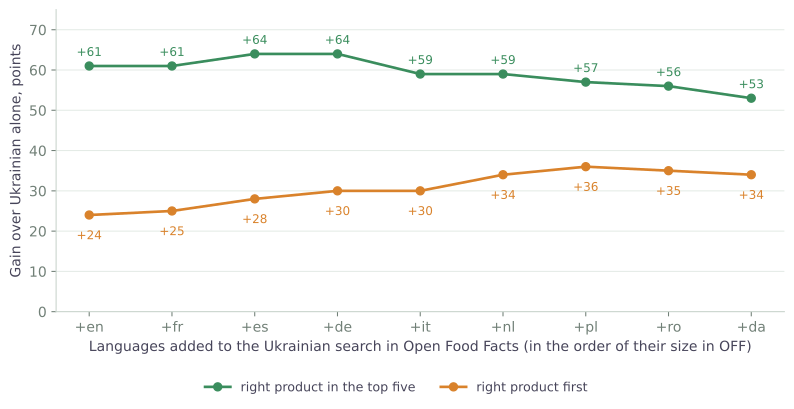
El primer paso es, con mucho, el más grande. Buscar en OFF solo en ucraniano a menudo no encuentra nada: OFF tiene pocos productos en ucraniano (figura 1), y en 47 de las 100 consultas la lista en ucraniano estaba vacía. Añadir la traducción al inglés sube en 61 puntos la proporción de consultas con el producto correcto en el top cinco, y en 24 puntos en el primer lugar, con 61 consultas ganadas y ninguna perdida.
Los siguientes idiomas cambian poco. El francés deja el top cinco igual (5 consultas ganadas, 5 perdidas). El español y el alemán añaden 3 puntos más, dentro del ruido. Después, el top cinco baja, 11 puntos desde su máximo con los diez idiomas, mientras que el primer lugar sube poco a poco otros 10 a 12 puntos. La caída de cuatro a diez idiomas en el top cinco es significativa en estas consultas (2 ganadas, 13 perdidas, prueba de signo p = 0.007); la subida del primer lugar de dos a diez idiomas no lo es (20 ganadas, 10 perdidas, p = 0.10). Las marcas se comportan de forma distinta a los alimentos cotidianos: con más listas, una consulta de marca se encuentra con más frecuencia (15 puntos más en el top cinco con español añadido que solo con inglés), mientras que los alimentos cotidianos se encuentran con menos frecuencia (25 puntos menos con diez idiomas que con inglés). Veinte consultas por tipo es una base pequeña, así que estas divisiones son orientativas.
Una traducción correcta al inglés es lo que produce el efecto. Cada idioma adicional es otra solicitud a OFF y, a partir de los primeros, diluye el ranking.
Platos de otra cocina
El paso al inglés importa más cuando el plato viene de otra cocina. Un conjunto aparte de 100 consultas, diez en cada uno de los diez idiomas, nombró un plato extranjero conocido como lo escribiría un usuario: Borschtsch para un usuario alemán, paella, pierogi, tiramisu, stroopwafel, sarmale. Este es un experimento anterior, y las consultas las tradujo el traductor neuronal que usaba la app en ese momento (sección 5). Para las 90 consultas que no estaban en inglés, traducir la consulta al inglés subió en 34 puntos la proporción con el plato en el top cinco frente a una búsqueda de Open Food Facts en el idioma propio del usuario (47 consultas ganadas, ninguna perdida, p < 0.001). Añadir más idiomas después del inglés no cambió nada en el top cinco, incluso cuando elegimos de antemano el idioma del país de origen del plato.
Nuestra base local ayudó aquí: sin su lista en inglés, el primer lugar bajó 8 puntos en estas consultas (7 perdidas, ninguna ganada, p = 0.016), porque la base conoce paella, ratatouille o lasagna y los pone primero. En alimentos cotidianos no mostró ese beneficio, pero quitarla tampoco mejoró la búsqueda (sección 10), así que la mantenemos. Los fallos restantes fueron platos que ninguna lista de OFF tiene con ningún nombre, como sarmale. El conjunto tiene solo unos veinte platos distintos, así que describe bien los platos conocidos y dice poco sobre los raros.
Lo que importó más que los idiomas: el emparejamiento
La mejora individual más grande de todo el estudio vino de emparejar palabras en la base local, sin traducción de por medio. La base local se busca con su propio emparejamiento, y las palabras funcionales, las terminaciones de caso y las comas decimales lo rompían: «суп з грибами» (sopa de setas, en ucraniano) no devolvía nada, porque el emparejamiento exigía que cada palabra de la consulta se encontrara tal como se escribió. Al ponderar las palabras de la consulta según lo raras que son (IDF), usar un stemmer Snowball para los idiomas que lo tienen y un único formato de número, el top-5 en el conjunto estándar mejoró cerca de un 9 % desde el inicio del estudio (prueba de signo p = 0.008), y en consultas con preposiciones y formas de palabra, cerca de un 12 %.
5. Por qué reemplazamos el traductor
Quitamos ML Kit porque traduce mal los nombres de alimentos. Es un traductor de propósito general construido para oraciones, y un nombre de alimento son unas pocas palabras sin contexto: una marca, un estado del producto, un plato que lleva el nombre de un lugar. Nuestra base se tradujo primero con él, y estas son entradas reales (las traducciones al ucraniano y al francés, con una glosa para los lectores que no hablan el idioma):
| Nombre en inglés | Resultado de ML Kit | Qué salió mal |
|---|---|---|
| plain, refrigerated | рівнина, холодильна (ucraniano) | «plain» aquí significa sin aditivos, como en plain yoghurt, pero se tradujo como рівнина, «llanura» (el paisaje); «refrigerated» se volvió un adjetivo que significa «de refrigerador» |
| boneless | безкімнатний (ucraniano) | significa «sin habitaciones»; el sentido buscado es «sin huesos» |
| Pad Thai | Подушка тайська (ucraniano) | el nombre del plato se leyó como palabras: «cojín tailandés» |
| Rice flour, brown | Рисова борошно, коричневий (ucraniano) | los adjetivos no concuerdan con el sustantivo «harina», lo cual es agramatical en ucraniano |
| Meringue with chocolate; Ham salad spread | dejado en parte o del todo sin traducir (ucraniano) | las palabras en inglés se quedan en el nombre |
| bun | chignon (francés) | un moño (el peinado), cuando se quería decir el panecillo |
| sauerkraut | chouchoune (francés) | es otra palabra; el término francés para el chucrut es choucroute |
El mismo defecto afecta a las consultas, donde una palabra equivocada es un producto que falta, y no se puede corregir localmente: no puedes corregir una palabra dentro de un modelo neuronal. Había dos razones menores: los modelos ocupan unos 40 MB por idioma y el SDK es un componente de terceros.
Los datos que poseemos apuntan a una herramienta mejor. Nuestra base tiene pares de un nombre en inglés y su nombre en cada idioma, un corpus paralelo exactamente en el dominio que necesitamos. Un diccionario se puede aprender de un corpus así.
6. Un diccionario aprendido por alineación de palabras
Aprender un diccionario a partir de texto paralelo es el viejo problema de la alineación de palabras: decidir qué palabra de una oración corresponde a qué palabra de la otra. La familia clásica son los modelos IBM de traducción automática estadística [1]. El Modelo 1, el más simple y nuestro punto de partida, trata un nombre en un idioma como generado a partir de las palabras del otro, sin tener en cuenta el orden. Para un nombre en inglés y un nombre en otro idioma (con una palabra vacía añadida), la probabilidad del par es
y la tabla de probabilidades de traducción de palabras , el diccionario, se estima por esperanza–maximización: en cada ronda, cada par de palabras de un par de nombres recibe una parte de la cuenta proporcional a su probabilidad actual, y las partes se normalizan en nuevas probabilidades. Para un nombre de alimento corto esto encaja bien, porque hay poco orden de palabras que modelar. Su debilidad conocida la describió Moore [2]: una palabra rara puede tomar cualquier probabilidad que convenga a su única oración, así que las palabras raras se vuelven «recolectores de basura» que se alinean con demasiadas palabras. Moore propuso suavizar los conteos y mejorar la inicialización; un prior bayesiano sobre las probabilidades de traducción, aplicado por inferencia variacional, es otro remedio [7].
Lo que consideramos y medimos
Comparamos nuestro alineador con sus versiones simplificadas, con implementaciones de referencia de dos alineadores publicados y con un método que no tiene ningún modelo de alineación. Todos los métodos recibieron los mismos pares de nombres, el mismo 5 % retenido y la misma forma de convertir alineaciones en un diccionario (un par de palabras cuenta si está enlazado al menos dos veces; cada palabra recibe su traducción más frecuente). La calidad es el F1 de las raíces de palabra entre la traducción del diccionario de un nombre retenido, palabra por palabra, y su nombre en inglés, promediado sobre nueve idiomas (tabla 1). Las diferencias son pequeñas, así que también informamos en cuántos de los nueve idiomas una diferencia es clara (intervalo de bootstrap del 95 % de la diferencia emparejada que no incluye el cero).
| Método | Qué es | F1 medio | Frente al nuestro |
|---|---|---|---|
| Coeficiente de Dice | sin modelo de alineación, cada palabra se enlaza con la palabra con la que más coincide | 0.812 | peor en 7 de 9 |
| Modelo 1 de IBM [1], EM | probabilidades de traducción de palabras, sin orden de palabras | 0.817 | peor en 6 de 9 |
| Modelo 1 con prior de Dirichlet [7] | Bayes variacional sobre las probabilidades de traducción | 0.822 | peor en 4 de 9 |
| Prior diagonal de alineación, EM | Modelo 2 en la parametrización de fast_align [5], sin el prior bayesiano | 0.822 | peor en 6 de 9 |
| Nuestro | prior diagonal y prior de Dirichlet, dos direcciones, intersección | 0.825 | – |
| Nuestro, grow-diag-final-and | lo mismo, con los enlaces de ambas direcciones combinados con la heurística estándar | 0.828 | mejor en 5 de 9, peor en 1 |
| fast_align [5] | la implementación de los autores, intersección / grow-diag-final-and | 0.826 / 0.831 | 3 mejor, 2 peor / 7 mejor |
| eflomal [8] | HMM con fertilidad, bayesiano, muestreo MCMC; intersección / grow-diag-final-and | 0.825 / 0.828 | 2 mejor, 2 peor / 7 mejor |
| SimAlign [10] | embeddings de BERT multilingüe, sin entrenamiento con nuestros nombres; tres métodos de emparejamiento (mejor / iterativo / intersección) | 0.824 / 0.822 / 0.812 | 2 mejor, 2 peor / 1 mejor, 3 peor / peor en 8 |
Tabla 1. Alineadores comparados en nombres retenidos de nuestra base, nueve idiomas. La última columna cuenta los idiomas donde la diferencia con el nuestro es clara. fast_align y eflomal son las implementaciones de los autores.
El coeficiente de Dice solo queda 0.013 por detrás del nuestro, y SimAlign, que no necesita entrenamiento con nuestros nombres, iguala al nuestro en su mejor ajuste. En nombres cortos y casi paralelos la elección del alineador importa poco, y la mayor parte de la calidad viene de los propios nombres. Cada ingrediente nuestro añade algo poco, y el fast_align real con la misma intersección da el mismo resultado (0.826 frente a 0.825), que es lo que esperamos de un método con el mismo diseño. Con la heurística estándar grow-diag-final-and, que combina los enlaces de ambas direcciones, la mejora es casi tan grande como la de elegir el modelo: entre un cuarto y medio punto de F1 en los tres casos. Es una ganancia pequeña pero clara en la mayoría de los idiomas, y planeamos usarla la próxima vez que se reconstruyan los diccionarios.
Reducir las palabras a raíces Snowball antes de la alineación baja el F1 (0.818, peor en 6 de 9 idiomas), y quedarse solo con las primeras cuatro letras de cada palabra, que Östling y Tiedemann señalan como un stemming aproximado útil para la traducción automática [8], lo baja mucho más (0.743). La tarea explica la diferencia: Östling y Tiedemann miden sistemas de traducción construidos sobre las alineaciones, y nosotros buscamos palabras sueltas de un nombre de alimento en un diccionario, donde unir formas de palabra une alimentos distintos.
No ejecutamos el muestreador de Gibbs de Mermer y Saraçlar [9] (un Modelo 1 totalmente bayesiano), los modelos IBM 3–5, ni las consultas estructuradas probabilísticas de Darwish y Oard [4], que mantienen varias traducciones por palabra. Esta última es un posible siguiente paso, ya que nuestro diccionario conserva solo el mejor candidato.
Qué es nuestro alineador
Nuestro alineador es una implementación propia del Modelo 2 de IBM en la parametrización de fast_align [5]: la probabilidad de alinear una palabra con una posición dada disminuye con la distancia a la diagonal (en el Modelo 1 es uniforme), porque los nombres de alimentos tienden a conservar su orden de palabras entre idiomas. Encima de eso, las probabilidades de traducción de palabras reciben un prior de Dirichlet disperso con inferencia variacional [7], como en fast_align, lo que evita que las palabras raras absorban probabilidad. Las constantes fijas (la probabilidad de alinear una palabra con nada, la fuerza del prior y la pendiente inicial de la diagonal) son las que reportan Dyer et al.; fast_align también reestima la pendiente durante el entrenamiento, y nosotros no. Se entrena en ambas direcciones, y solo se conservan los enlaces en los que las dos direcciones coinciden (intersección), lo que sube la precisión a costa de algo de exhaustividad. Las palabras se alinean en sus formas exactas, sin stemming: reducir las palabras a raíces, lo habitual en idiomas con terminaciones ricas, nos hizo perder precisión en las primeras pruebas, así que los compuestos y las palabras con guion se tratan mediante frases.
El resultado es un diccionario en tres capas que el traductor aplica desde la coincidencia más larga de hasta tres palabras: entradas de la taxonomía, frases alineadas en nuestra base y palabras sueltas alineadas en nuestra base. Una palabra que no está en el diccionario, como una marca o una errata, pasa sin cambios, porque OFF a menudo la conoce. Cada idioma es un archivo de unos pocos cientos de kilobytes, frente a unos 40 MB por idioma de los modelos neuronales. Funciona sin conexión y cada traducción se puede rastrear hasta una línea del diccionario y corregir.
Qué tan buena es la traducción
Medimos el traductor de dos maneras. En el 5 % de los pares de nombres que se retuvieron fuera del entrenamiento, traducir el nombre extranjero palabra por palabra y comparar el resultado con el nombre en inglés por raíces de palabra da un F1 entre 0.78 y 0.90 en los nueve idiomas. En las consultas de evaluación, para las que escribimos junto a cada consulta una traducción de referencia al inglés, el F1 de raíces de palabra es 0.94 para alemán (88 de 100 consultas idénticas en raíces) y 0.96 para ucraniano (89 de 100).
Estos números describen la traducción de consultas cortas y comunes al inglés. La calidad de la búsqueda en sí es menor y se mide por separado (secciones 3 y 9). No ejecutamos el antiguo traductor neuronal con las mismas consultas, así que no afirmamos que el diccionario sea mejor que ML Kit; es lo bastante preciso en estas consultas, pequeño, sin conexión y corregible.
7. Las taxonomías de Open Food Facts: qué dan y qué cuestan
OFF mantiene taxonomías públicas de ingredientes y de categorías: listas jerárquicas en las que cada entrada tiene un nombre en inglés y nombres y sinónimos en muchos idiomas, escritos por voluntarios. Tienen miles de entradas con nombre en inglés, y resultan atractivas por tres razones: las traducciones las hacen personas y en el dominio alimentario, contienen palabras que nuestros propios nombres nunca usan (ingredientes raros), y son independientes de la traducción automática que produjo nuestros nombres.
Las dificultades:
- Cobertura desigual. La proporción de entradas con nombre en un idioma dado va desde el 1.6 % (categorías en ucraniano) hasta el 84.6 % (categorías en francés), así que la taxonomía no puede ser la única fuente. La aplicamos primero, donde existe una entrada, y dejamos que el diccionario de nuestra base complete el resto.
- Nombres de estilo de categoría y muchos sinónimos. Una entrada tiene un nombre en inglés y muchos sinónimos en un idioma. Cada sinónimo se empareja con el nombre principal en inglés, y los nombres en inglés muy largos se omiten.
- Frases además de palabras. Los nombres de la taxonomía son frases, así que el traductor busca primero la frase más larga en cada posición y luego las palabras sueltas.
- Ruido. Cuando la taxonomía también se usa como datos de entrenamiento, sus frases de estilo categórico compiten con las frases idiomáticas de nuestra base. Hubo que medir un peso para los pares de la taxonomía. Un peso demasiado grande perdía precisión en palabras comunes, y el rango que funciona es estrecho.
Entrenar con la taxonomía: una prueba que no podía ver el efecto
Nuestra primera prueba de añadir pares de la taxonomía al entrenamiento de alineación no mostró nada. La medimos con nombres retenidos de nuestra propia base y con nuestras consultas, y la calidad de la traducción se movió como mucho unas pocas milésimas. Casi concluimos que la taxonomía solo servía como búsqueda. Esa prueba no podía ver el efecto: ambos conjuntos contienen palabras que nuestra base ya conoce, mientras que el objetivo de la taxonomía es añadir palabras que la base no tiene.
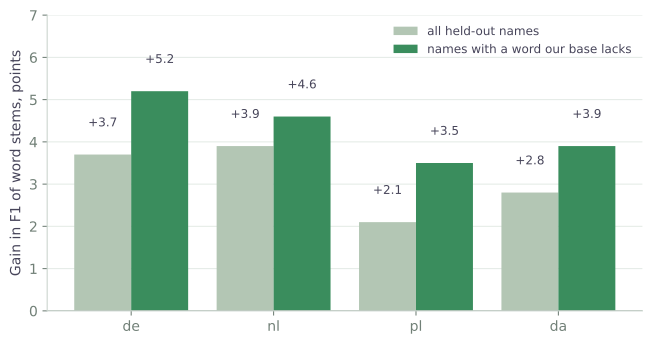
La prueba justa quita una décima parte de las entradas de la taxonomía de la capa de búsqueda y del entrenamiento, construye el diccionario con y sin entrenamiento con taxonomía, y traduce los nombres de las entradas quitadas. Para los idiomas con una taxonomía grande, el entrenamiento añade de dos a cuatro puntos de F1 en todos los nombres retenidos y de cuatro a cinco puntos en nombres con una palabra que nuestra base no tiene, sin pérdida en nombres formados por palabras conocidas (figura 3). Para los idiomas con una taxonomía pequeña, como el ucraniano y el rumano, no cambia nada. Abandonamos nuestra recomendación temprana, y los diccionarios de la app se construyen con entrenamiento con taxonomía.
Dónde puede perjudicar. Los nombres de la taxonomía son de estilo categórico, y sus sinónimos pueden desplazar una frase idiomática aprendida de nuestra base («home fries» para un plato de patatas fritas). En las consultas en alemán esto costó alrededor de un punto de F1 y nada en ucraniano, un precio que aceptamos por la ganancia en palabras raras.
8. Pesos de las cuatro listas por idioma
En la ecuación (1), cada lista tiene un peso. Nuestros primeros pesos eran iguales para todos los idiomas, ajustados en un solo conjunto de consultas. Pero la calidad de las listas difiere entre idiomas. La lista nativa C de OFF es rica en francés o alemán y escasa en ucraniano, donde la lista en inglés D lleva más peso. Dar a cada idioma sus propios pesos es una idea natural, y la pregunta es de dónde obtenerlos para diez idiomas cuando tenemos consultas de prueba para dos.
Consideramos dos medidas. La primera fue la proporción de entradas de la taxonomía que tienen un nombre en el idioma. Es fácil de calcular, pero mide qué tan bien los voluntarios tradujeron el vocabulario, lo que afecta al diccionario, y dice poco sobre cuántos productos llevan un nombre en ese idioma; sus dos columnas incluso discrepan entre sí (italiano: 75 % de los ingredientes y 28 % de las categorías). No la usamos. La segunda fue el número de productos de OFF por idioma en relación con el inglés, disponible desde el servicio de búsqueda (figura 1). Es un indicador indirecto, porque el idioma principal de un producto puede diferir del idioma de un campo de nombre, y aun así sigue lo que necesitamos: qué tan probable es que la lista nativa conozca el producto. A partir de él derivamos un peso para cada idioma con una fórmula suave, que da más peso a la lista nativa a medida que el idioma crece, y fijamos los valores en una pequeña tabla de consulta en la app.
En las 200 consultas juzgadas en alemán y ucraniano, el efecto es claro para el alemán y ausente para el ucraniano (figura 4). El MRR en alemán sube .062 (intervalo de bootstrap del 95 % de la diferencia, de +.030 a +.099) y el primer lugar 7 puntos, mientras que el top cinco gana 3 puntos, lo que está dentro del ruido. El MRR del ucraniano baja .002, porque sus nuevos pesos están cerca de los antiguos comunes. La ganancia en alemán se mantiene en ambas mitades de las consultas cuando se dividen en impares y pares.
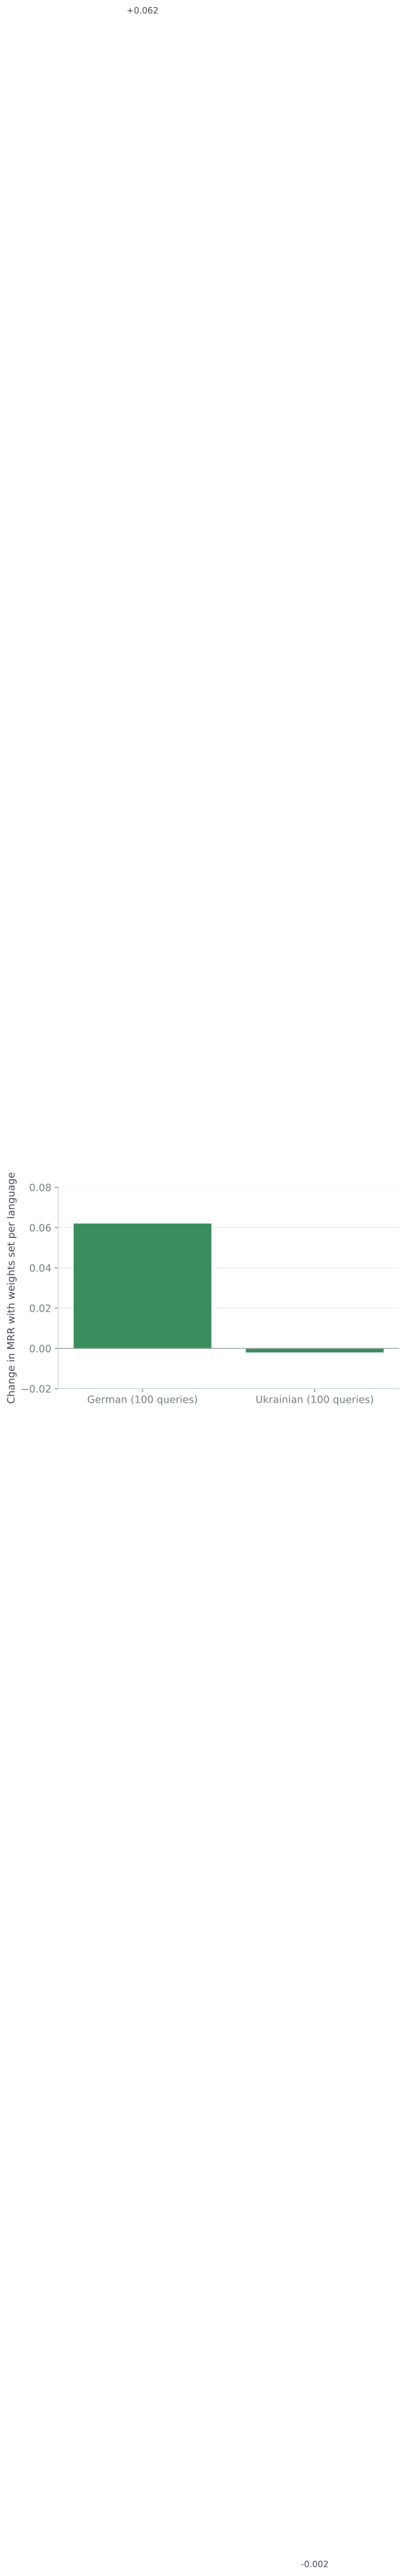
Las constantes de la fórmula se fijaron con estas mismas consultas, y los pesos de los demás idiomas se derivan de la fórmula y no se han medido.
9. Errores de escritura y formas de palabra
El diccionario conoce las formas exactas de las palabras. Una palabra con un error de escritura, o una forma de caso que no ha visto, pasa sin cambios y llega a las listas en inglés como una palabra que allí no significa nada. La búsqueda en nuestra base local ya corrige errores con un índice SymSpell, un índice de distancia de edición en el que el número de ediciones permitidas crece con la longitud de la palabra. La pregunta abierta era el paso de traducción, así que medimos cuánto cuestan los errores y cuánto aporta un respaldo.
Paso 1: errores y formas de palabra, palabra por palabra
Reconstruimos los diccionarios de los nueve idiomas a partir de nuestros nombres y tomamos, de los nombres retenidos, las palabras con una traducción conocida. A cada una le aplicamos una edición aleatoria (una letra eliminada, insertada o reemplazada, o dos letras vecinas intercambiadas). Una búsqueda dentro de la distancia de edición permitida devolvió la traducción de la palabra original para el 92.5 % de las palabras dañadas, frente al 0.3 % de la búsqueda exacta. Si la primera letra debía coincidir, como puede exigir la búsqueda en la base local, bajó al 77 %, porque los errores en la primera letra se pierden entonces.
Para las formas de palabra tomamos las palabras retenidas que el diccionario no conoce pero cuya raíz Snowball es igual a la raíz de una palabra conocida (sobre todo otro caso o número de una palabra conocida). La distancia de edición dio una traducción correcta para el 55 % de ellas, un inicio común de la palabra para el 63 %, y la misma raíz para el 69 %. Las terminaciones de caso a menudo cambian varias letras, lo que el límite de edición no permite. Las palabras desconocidas restantes (marcas, palabras raras, números) son un riesgo: la distancia de edición responde a una cuarta parte de ellas y acierta en un tercio de las respuestas. Usamos las raíces solo en la búsqueda; durante el entrenamiento bajaban la calidad (sección 6).
Paso 2: el respaldo en los diccionarios reales
Los diccionarios de la app omiten las palabras que se escriben igual en ambos idiomas, así que una palabra así es «desconocida» para el respaldo. Un respaldo simple, por tanto, cambiaba palabras que eran correctas: pizza se convertía en nicoise, pils en mushroom, la palabra de marca Krönung en curd. En consultas tal como se escribieron, el F1 de palabras de la traducción bajó 3 puntos. Tres salvaguardas eliminan la mayor parte del daño: una palabra que ya es una palabra inglesa del diccionario se deja tal cual, las palabras muy cortas se dejan tal cual, y la distancia de edición permitida se mantiene pequeña. El orden es: búsqueda exacta, misma raíz y, por último, una edición. Con las salvaguardas, la pérdida en consultas tal como se escribieron se reduce a 1.5 puntos, y en consultas con un error el F1 sube 30 puntos.
Paso 3: la búsqueda completa
El F1 de palabras compara una traducción con una referencia, y una búsqueda tiene otras listas que pueden absorber una mala traducción. Así que ejecutamos la búsqueda completa, como en la sección 3, sobre 200 consultas (100 en alemán y 100 en ucraniano): tal como se escribieron, y con un error de escritura aleatorio en una palabra de cada consulta (cambiaron 195 consultas). Cada consulta se tradujo de cuatro formas: la traducción correcta (una cota superior), el diccionario tal como era, el diccionario con el respaldo simple, y el diccionario con las salvaguardas. Las cuatro listas ordenadas se combinaron con los pesos de la app, y un modelo de lenguaje juzgó a ciegas los primeros resultados agrupados.
| Traducción | Consultas tal como se escribieron primero / top cinco, puntos | Un error por consulta primero / top cinco, puntos |
|---|---|---|
| Correcta (cota superior) | +0.5 / −1.0 | +15.0 / +11.5 |
| Diccionario, respaldo simple | +1.5 / +1.0 | +8.5 / +4.5 |
| Diccionario, respaldo con salvaguardas | +2.0 / +0.5 | +7.5 / +4.0 |
Tabla 2. Cambio frente al diccionario tal como era, en puntos de la proporción de consultas con el producto correcto en primer lugar y en el top cinco.
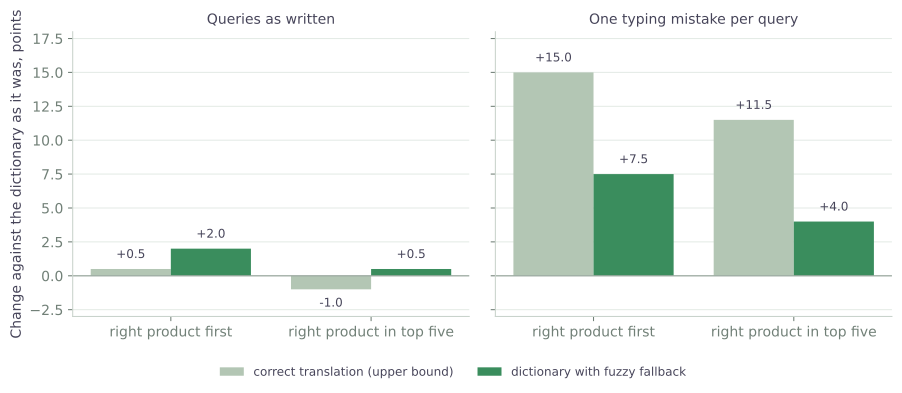
En consultas tal como se escribieron, el diccionario es tan bueno como la traducción correcta (medio punto por detrás en primer lugar, un punto por delante en el top cinco), y el respaldo no cambia nada que podamos detectar (4 consultas ganadas y ninguna perdida en primer lugar, p = 0.13). Con un error de escritura, el diccionario tal como era pierde 15 puntos en el primer lugar; el respaldo con salvaguardas recupera 7.5 de ellos (30 consultas ganadas, 15 perdidas, p = 0.04) y 4 de los 11.5 puntos en el top cinco (11 ganadas, 3 perdidas, p = 0.06). La búsqueda que usa solo la lista en inglés de Open Food Facts gana mucho más, 22 puntos en el primer lugar, porque no tiene una lista nativa en la que apoyarse. El respaldo simple y el que tiene salvaguardas no se pueden distinguir en la búsqueda completa; conservamos el que tiene salvaguardas porque cambia menos palabras correctas. La ganancia varía según el idioma: el ucraniano gana 15 puntos en el primer lugar, el alemán ninguno, y no investigamos por qué.
Paso 4: límites de la medición
Los errores son sintéticos: una edición aleatoria en casi cada consulta, con mucha más frecuencia de la que la gente realmente escribe mal, y sin los errores de teclas vecinas de un teclado real. Doscientas consultas y un solo modelo como juez dan valores p alrededor de 0.05, así que el resultado sobre errores indica la dirección, pero el tamaño exacto necesita consultas reales. La ganancia por consulta real es la ganancia de arriba multiplicada por la proporción de consultas con un error, que no conocemos; con un costo en las consultas correctas de alrededor de cero, incluso una proporción pequeña compensa.
10. Lo que no funcionó, o no hizo falta
- Quitar la lista local en inglés. En el segundo conjunto de consultas, la versión sin ella no fue mejor que la de cuatro listas (el top cinco 2 puntos menos, MRR .015 menos, dentro del ruido), así que conservamos la estructura.
- Stemming antes de la alineación. Es el consejo habitual para idiomas con terminaciones ricas; en nuestras pruebas perdió precisión. Las formas exactas más las frases funcionaron mejor.
- Un peso muy grande para los pares de la taxonomía. Ayudó un poco con palabras desconocidas en dos idiomas y perdió con palabras conocidas. El rango útil es estrecho, y nos mantenemos dentro de él.
- La cobertura de la taxonomía como peso de una lista. Mide la calidad de la traducción en ese idioma, y el número de productos que existen en él es una cantidad aparte.
- Una prueba que no podía ver el efecto. Nuestra primera prueba de taxonomía miró palabras que la base ya conocía y hizo parecer inútil a la taxonomía. La lección es preguntarse qué puede ver una prueba antes de confiar en un resultado nulo.
Cómo usamos esto en MuscleTiger
La búsqueda de alimentos de MuscleTiger funciona como se describe: tu consulta va a nuestra base propia y a Open Food Facts, en tu idioma y en inglés; la consulta la traduce un diccionario que vive en tu teléfono, y las cuatro listas de resultados se combinan con pesos que dependen de tu idioma. Los resultados se muestran en el idioma de la interfaz de la app, y los productos que se venden en tu país aparecen antes que los demás. El diccionario funciona sin red, así que una consulta en el gimnasio sin señal todavía encuentra alimentos en nuestra base local.
Conclusiones
- La búsqueda encuentra el alimento buscado en el 92 % de las consultas. En una prueba de la búsqueda completa en nueve idiomas aparece entre los diez primeros resultados en el 90 % y en primer lugar en el 67 %; los productos simples se encuentran algo más a menudo que los platos.
- Lo que importa es la traducción al inglés. Con traducciones correctas, añadir la lista en inglés subió en 61 puntos la proporción de consultas en ucraniano con el producto correcto en el top cinco frente a Open Food Facts solo en ucraniano; los idiomas adicionales cambiaron poco y, a partir de cuatro, bajaron el top cinco.
- Para las consultas de alimentos, un diccionario pequeño puede hacer el trabajo del traductor. La alineación de palabras sobre nuestros propios nombres paralelos da un archivo de unos cientos de kilobytes por idioma, sin conexión, y reproduce nuestras traducciones de referencia de consultas cortas con un F1 de raíces de palabra de 0.94 a 0.96. Esa es la precisión de traducir consultas simples; la precisión de la búsqueda se mide aparte y es menor.
- Las taxonomías públicas ayudan sobre todo donde nuestros datos callan. Entrenar el diccionario con ellas mejoró la traducción de términos raros retenidos en dos a cinco puntos en los idiomas con una taxonomía grande, a un pequeño costo en los comunes.
- El peso de cada lista puede depender del tamaño del idioma en OFF. Para el alemán el cambio elevó el MRR en .062 en nuestras consultas; para el ucraniano no cambió nada.
- Un respaldo para errores de escritura compensa. Con un error de escritura, el primer lugar cae 15 puntos cuando el traductor solo conoce formas exactas, y un respaldo con salvaguardas (misma raíz y luego una distancia de edición pequeña) recupera la mitad; en consultas tal como se escribieron no cuesta nada que podamos medir.
- El emparejamiento importó más que los idiomas. Ponderar las palabras por rareza, el stemming y un único formato de número dieron la mayor ganancia del estudio.
Límites. Las consultas las redactamos nosotros y las juzgó un modelo de lenguaje, así que los márgenes son amplios (unos puntos con 200 consultas). Los números son para alemán y ucraniano; los pesos de los demás idiomas son extrapolados. No comparamos con el traductor neuronal ni con otras apps. El siguiente paso es una comprobación con consultas reales de usuarios.
Datos y licencias
Los datos de productos y las taxonomías provienen de Open Food Facts, disponibles bajo la Open Database Licence (ODbL); los diccionarios descritos aquí se derivan en parte de las taxonomías de OFF y llevan la misma atribución. Nuestra base local se construye con tablas nacionales de composición de alimentos abiertas, publicadas por autoridades públicas; sus fuentes y licencias se listan en la app. Agradecemos a los colaboradores de Open Food Facts y a los responsables de las tablas nacionales.
Sources
- Brown PF, Della Pietra SA, Della Pietra VJ, Mercer RL. The mathematics of statistical machine translation: parameter estimation. Computational Linguistics 1993;19(2):263–311. ACL Anthology
- Moore RC. Improving IBM word-alignment Model 1. Proceedings of ACL 2004:518–525. ACL Anthology
- Cormack GV, Clarke CLA, Büttcher S. Reciprocal rank fusion outperforms Condorcet and individual rank learning methods. Proceedings of SIGIR 2009. doi:10.1145/1571941.1572114
- Darwish K, Oard DW. Probabilistic structured query methods. Proceedings of SIGIR 2003.
- Dyer C, Chahuneau V, Smith NA. A simple, fast, and effective reparameterization of IBM Model 2. Proceedings of NAACL-HLT 2013:644–648. ACL Anthology
- Open Food Facts: taxonomies of ingredients and categories and product data, world.openfoodfacts.org, under the Open Database Licence (ODbL).
- Riley D, Gildea D. Improving the IBM alignment models using variational Bayes. Proceedings of ACL (short papers) 2012:306–310. ACL Anthology
- Östling R, Tiedemann J. Efficient word alignment with Markov chain Monte Carlo. The Prague Bulletin of Mathematical Linguistics 2016;106:125–146.
- Mermer C, Saraçlar M. Bayesian word alignment for statistical machine translation. Proceedings of ACL (short papers) 2011:182–187. ACL Anthology
- Jalili Sabet M, Dufter P, Yvon F, Schütze H. SimAlign: high quality word alignments without parallel training data using static and contextualized embeddings. Findings of EMNLP 2020.