Note di ricerca MuscleTiger · N. 5
Ricerca di alimenti in qualsiasi lingua: come tradurre le query, unire i database e che cosa abbiamo misurato
Digiti «Spiegelei mit Speck» o «борщ з м’ясом» in un diario alimentare e ti aspetti di vedere un prodotto con calorie e macronutrienti. I più grandi database alimentari aperti sono per lo più scritti in inglese e in francese, mentre le persone cercano nella propria lingua, con marchi, desinenze delle parole ed errori di battitura. Questa nota descrive come abbiamo costruito la ricerca di alimenti in MuscleTiger, che cosa abbiamo provato, che cosa si è rivelato non necessario e che cosa abbiamo misurato.
In breve
La nostra ricerca di alimenti trova l’alimento cercato per il 92% delle query in nove lingue (sezione 3). Cerchiamo in quattro liste contemporaneamente (la nostra base di alimenti in inglese e nella lingua dell’utente, e Open Food Facts nella lingua dell’utente e in inglese) e fondiamo le graduatorie con la reciprocal rank fusion. Una query in un’altra lingua viene prima tradotta in inglese. Abbiamo usato in un primo momento un traduttore neurale eseguito sul dispositivo, poi lo abbiamo sostituito con un piccolo dizionario appreso dai nostri nomi paralleli di alimenti, con un allineatore di parole della famiglia IBM Model 2 con un prior bayesiano, e dalle tassonomie di Open Food Facts. Sulle nostre query di prova il dizionario riproduce la traduzione inglese di riferimento con un F1 sugli stemmi delle parole di 0.94 (tedesco) e 0.96 (ucraino); questo misura la traduzione di query brevi e semplici. Con traduzioni corrette, aggiungere la lista inglese aumenta di 61 punti la quota di query in ucraino con il prodotto giusto tra i primi cinque, e le altre lingue aggiungono poco. I pesi delle quattro liste, che dipendono dalla dimensione della lingua in Open Food Facts, hanno migliorato il tedesco e hanno lasciato invariato l’ucraino. Un ripiego per gli errori di battitura nel traduttore recupera circa la metà dei 15 punti che un errore costa.
Spieghiamo l’approccio e le famiglie di metodi che abbiamo considerato.
1. Il problema: una query in una lingua, dati in più lingue
Una ricerca di alimenti deve fare bene tre cose insieme. Deve capire una query breve e disordinata («chicken breast 200g», «coca cola zero», «мигдальне молоко»). Deve trovare un prodotto con valori nutrizionali completi e plausibili. E deve funzionare nella lingua della persona, sul telefono, in fretta e idealmente offline.
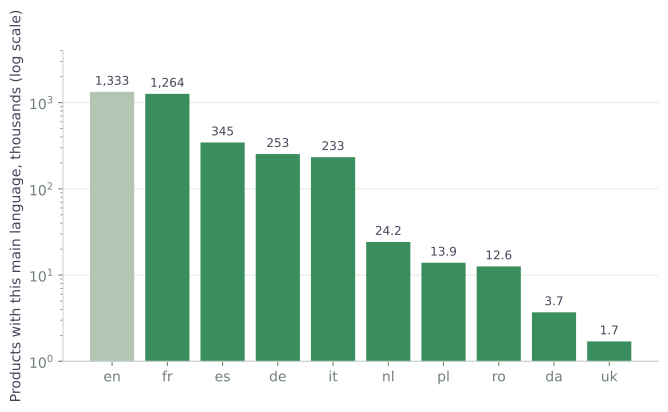
I dati che possiamo usare sono disomogenei. Open Food Facts (OFF) [6], il database aperto dei prodotti confezionati, contiene milioni di prodotti, ma la lingua di un prodotto segue il paese in cui viene venduto e le abitudini di chi contribuisce. Contando i prodotti in base alla lingua principale (OFF, 15 novembre 2026), l’inglese e il francese sono in testa con circa 1.3 milioni di prodotti ciascuno, lo spagnolo, il tedesco e l’italiano seguono con da 230 a 350 mila, e le lingue più piccole che supportiamo hanno tra 1.7 e 25 mila prodotti (Figura 1). Una query in ucraino può quindi ricevere risposta in ucraino da pochissimi prodotti, mentre una query in francese incontra un database che è già in gran parte francese.
La nostra base
La seconda fonte è la nostra base di alimenti con energia e macronutrienti completi. È una fusione di diverse tabelle nazionali di composizione degli alimenti, scelte perché sono aperte, misurate in laboratorio e complete per i macronutrienti. Molti dei suoi alimenti hanno porzioni domestiche come “1 slice”. Un alimento viene saltato quando uno con lo stesso nome è già nella base, e le nuove righe vengono sempre aggiunte dopo quelle vecchie, così il numero di un prodotto e delle sue traduzioni non cambia mai quando si aggiunge una tabella.
Quando più tardi abbiamo aggiunto altre tre tabelle, la quota di query di prova con il prodotto giusto tra i primi cinque è salita di 3 punti e quella al primo posto di 2 punti; nessuno dei due cambiamenti è significativo. Il guadagno è venuto soprattutto da piatti comuni che le nuove tabelle descrivono in inglese semplice, come lasagne, cappuccino o yogurt greco. Abbiamo escluso una tabella candidata, perché la sua licenza prevede una clausola di condivisione con la stessa licenza (share-alike) che potrebbe estendersi alla nostra base fusa.
Le tabelle sono scritte in inglese o nella lingua del loro paese, quindi i nomi nelle altre lingue hanno dovuto essere creati. I nomi inglesi sono quelli originali; i nomi nelle altre lingue sono stati prodotti con la traduzione automatica e in parte rifatti successivamente da agenti basati su modelli linguistici con controlli automatici (un validatore scarta una risposta che cambia numeri, unità o la struttura del nome). I numeri nei nomi usano il punto decimale in ogni lingua, nella base e nella query, così che una query con una percentuale di grassi possa preferire il prodotto con quella percentuale.
2. Quattro liste e una sola graduatoria
Il progetto che usiamo è semplice da descrivere. Ogni query viene cercata in quattro posti:
- A: la nostra base locale, con la query tradotta in inglese;
- B: la nostra base locale, con la query come digitata nella lingua dell’utente;
- C: Open Food Facts, cercato nella lingua dell’utente;
- D: Open Food Facts, cercato con la traduzione inglese.
Ogni lista restituisce una propria graduatoria, e le graduatorie vengono fuse con la reciprocal rank fusion (RRF) [3]. Un prodotto che compare in alto in più liste batte un prodotto che è primo in una sola lista:
dove è la posizione del prodotto nella lista , è il peso della lista e è una piccola costante che impedisce al primo posto di dominare. Il metodo non richiede punteggi dalle liste, solo il loro ordine, il che conta perché le liste provengono da sistemi diversi con punteggi non confrontabili. Lo abbiamo scelto per questo motivo; Cormack et al. riportano che è competitivo con metodi di apprendimento del ranking più elaborati nei loro esperimenti [3].
RRF è un metodo pubblicato, e il nostro contributo è la misura: quali liste includere, come tradurre la query e quanto fidarsi di ciascuna lista in ogni lingua.
3. Come abbiamo misurato
Il protocollo:
- Abbiamo scritto insiemi di query di vari tipi: marchio più prodotto, piatto, alimento di uso quotidiano, bevanda, e query informali o con errori di ortografia. Un insieme ha 959 query, di cui 200 valutate in dettaglio; un secondo insieme ha 200 query, 100 in tedesco e 100 in ucraino, con 20 per tipo. Un insieme separato di piatti di cucine straniere (per esempio un piatto giapponese chiesto in tedesco) verifica se la lingua della query debba seguire il piatto.
- Per ogni query abbiamo raccolto i primi risultati di ogni configurazione, e un modello linguistico ha giudicato ogni candidato come pertinente o no, vedendo la query e la traduzione inglese ma non quale configurazione avesse restituito il candidato. Il giudice non poteva quindi favorire un metodo.
- Riportiamo il top-1 (il prodotto giusto è primo), il top-5 (è tra i primi cinque) e l’MRR, la media di del primo risultato pertinente. Per i confronti tra configurazioni accoppiamo i risultati per query e usiamo test dei segni e intervalli bootstrap.
Accuratezza della ricerca completa
Il numero del riassunto viene da un test della ricerca esattamente come funziona nell’app. Abbiamo scritto dieci query in ciascuna delle nove lingue che l’app supporta oltre all’inglese, due per ogni tipo, 90 query in tutto. Ogni query ha seguito gli stessi passaggi che su un telefono: traduzione con il dizionario, la nostra base in inglese e nella lingua della query, Open Food Facts in entrambe le lingue con i prodotti venduti nel paese di quella lingua messi in testa, e la fusione con i pesi dell’app. Abbiamo letto l’intera lista fusa di ogni query, circa sessanta risultati in media, e segnato a mano il primo risultato che un utente accetterebbe come l’alimento cercato, con le stesse regole del giudice alla cieca.
| L’alimento cercato viene trovato | Tutte le query (90) | Prodotti singoli (65) | Piatti (25) |
|---|---|---|---|
| in qualsiasi punto della lista | 92.2% | 93.8% | 88.0% |
| tra i primi dieci | 90.0% | 90.8% | 88.0% |
| tra i primi cinque | 85.6% | 86.2% | 84.0% |
| al primo posto | 66.7% | 67.7% | 64.0% |
Accuratezza della ricerca completa. Dieci query in ciascuna delle nove lingue, cercate come nell’app. I prodotti singoli sono alimenti, prodotti confezionati e bevande; i piatti comprendono anche pasti composti, come un panino al formaggio o fiocchi d’avena con latte.
L’alimento cercato è da qualche parte nella lista per il 92% delle query, tra i primi dieci risultati per il 90%, tra i primi cinque per l’86% e al primo posto per il 67%. I prodotti singoli vengono trovati un po’ più spesso dei piatti (94% contro 88% in qualsiasi punto della lista). I mancati ritrovamenti sono soprattutto prodotti di marca che nessuna lista contiene e spuntini fatti di più alimenti, per i quali le liste offrono gli ingredienti ma non lo spuntino stesso. Dieci query per lingua sono una base piccola: una sola query sposta il risultato di una lingua di dieci punti, quindi i numeri descrivono la ricerca nel suo insieme e dicono poco della singola lingua. Le sezioni seguenti scompongono la ricerca e misurano ogni passaggio su insiemi di query più grandi in tedesco e ucraino.
4. Che cosa fa una traduzione corretta per la ricerca
Prima di descrivere i nostri tentativi di costruire un buon traduttore, abbiamo misurato quanto vale una buona traduzione. Abbiamo scritto 100 query alimentari in ucraino (20 ciascuna per alimenti di uso quotidiano, piatti, bevande, marchi e query informali) e le abbiamo tradotte a mano in ciascuna delle altre nove lingue, così che la traduzione sia corretta per costruzione. Per ogni lingua abbiamo cercato in Open Food Facts con la query in quella lingua e fuso le liste con la reciprocal rank fusion (equazione 1, pesi uguali). La prima configurazione è solo ucraino, la seconda aggiunge l’inglese, e poi abbiamo aggiunto francese, spagnolo, tedesco, italiano, olandese, polacco, rumeno e danese, nell’ordine del numero di prodotti che ogni lingua ha in OFF (Figura 2). La pertinenza è stata giudicata alla cieca da un modello linguistico con le regole della sezione 3, sui primi cinque raccolti di ogni configurazione.
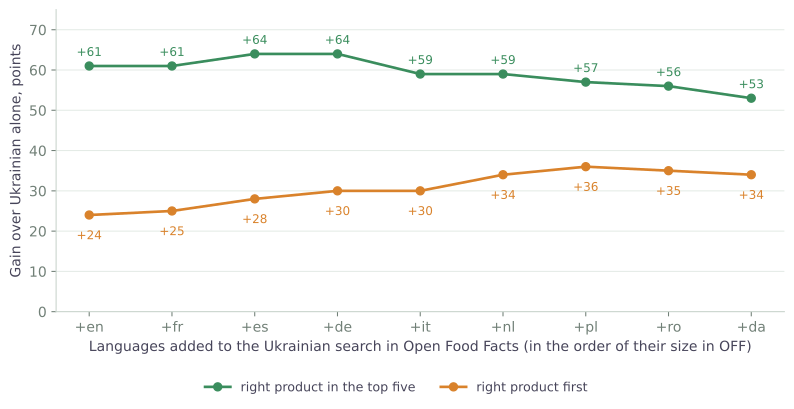
Il primo passo è di gran lunga il più grande. Cercando in OFF solo in ucraino spesso non si trova nulla: OFF ha pochi prodotti in lingua ucraina (Figura 1), e per 47 query su 100 la lista ucraina era vuota. Aggiungere la traduzione inglese alza la quota di query con il prodotto giusto tra i primi cinque di 61 punti e quella al primo posto di 24 punti, con 61 query guadagnate e nessuna persa.
Le lingue successive cambiano poco. Il francese lascia invariati i primi cinque (5 query guadagnate, 5 perse). Spagnolo e tedesco aggiungono altri 3 punti, entro il rumore. Dopo, i primi cinque scendono, di 11 punti rispetto al picco con tutte e dieci le lingue, mentre il primo posto sale ancora di altri 10–12 punti. Il calo dei primi cinque da quattro a dieci lingue è significativo su queste query (2 guadagnate, 13 perse, test dei segni p = 0.007); l’aumento del primo posto da due a dieci lingue non lo è (20 guadagnate, 10 perse, p = 0.10). I marchi si comportano diversamente dagli alimenti comuni: con più liste una query di marca viene trovata più spesso (15 punti in più nei primi cinque con lo spagnolo aggiunto rispetto al solo inglese), mentre gli alimenti comuni vengono trovati meno spesso (25 punti in meno con dieci lingue rispetto all’inglese). Venti query per tipo è una base piccola, quindi queste differenze sono indicative.
Una traduzione corretta in inglese porta da sola l’effetto. Ogni lingua in più è un’altra richiesta a OFF e, oltre le prime poche, diluisce la graduatoria.
Piatti di un’altra cucina
Il passaggio all’inglese conta di più quando il piatto viene da un’altra cucina. Un insieme separato di 100 query, dieci per ciascuna delle dieci lingue, nominava un piatto straniero noto nel modo in cui lo digiterebbe un utente: Borschtsch per un utente tedesco, paella, pierogi, tiramisu, stroopwafel, sarmale. Questo è un esperimento più vecchio, e le query sono state tradotte dal traduttore neurale che l’app usava allora (sezione 5). Per le 90 query non in inglese, tradurre la query in inglese ha alzato la quota con il piatto tra i primi cinque di 34 punti rispetto a una ricerca in Open Food Facts nella lingua propria dell’utente (47 query guadagnate, nessuna persa, p < 0.001). Aggiungere altre lingue dopo l’inglese non ha cambiato nulla nei primi cinque, anche quando avevamo scelto in anticipo la lingua del paese da cui viene il piatto.
La nostra base locale ha aiutato qui: senza la sua lista inglese, il primo posto scendeva di 8 punti su queste query (7 perse, nessuna guadagnata, p = 0.016), perché la base conosce paella, ratatouille o lasagne e le mette al primo posto. Sugli alimenti comuni non ha mostrato un beneficio del genere. Anche toglierla non ha reso migliore la ricerca (sezione 10), quindi la teniamo. Le query ancora non trovate erano piatti che nessuna lista di OFF ha con alcun nome, come sarmale. L’insieme ha solo una ventina di piatti distinti, quindi descrive piatti noti e dice poco di quelli rari.
Il matching contava più delle lingue
Il miglioramento singolo più grande di tutto lo studio è venuto dal matching delle parole nella base locale, senza alcuna traduzione coinvolta. La base locale viene cercata con il proprio matching, e le parole funzionali, le desinenze dei casi e le virgole decimali lo rompevano: «soup with mushrooms» in ucraino non restituiva nulla, perché il matching richiedeva che ogni parola della query fosse trovata come digitata. Pesando le parole della query in base a quanto sono rare (IDF), con uno stemmer Snowball per le lingue che ne hanno uno e un solo formato dei numeri, il top-5 sull’insieme standard è migliorato di circa il 9% dall’inizio dello studio (test dei segni p = 0.008), e sulle query con preposizioni e forme di parole di circa il 12%.
5. Perché abbiamo sostituito il traduttore
Abbiamo eliminato ML Kit perché traduce male i nomi degli alimenti. È un traduttore generico costruito per le frasi, mentre il nome di un alimento è qualche parola senza contesto: un marchio, uno stato del prodotto, un piatto che prende il nome da un luogo. La nostra base è stata tradotta prima con esso, e questi sono risultati reali (le traduzioni ucraine e francesi, con una glossa per i lettori che non conoscono la lingua):
| Nome inglese | Risultato di ML Kit | Che cosa è andato storto |
|---|---|---|
| plain, refrigerated | рівнина, холодильна (ucraino) | «plain» qui significa «semplice, senza aromi», come in plain yoghurt, ed è stato tradotto come «plain» nel senso di «pianura»; «refrigerated» è diventato un aggettivo che significa «di frigorifero» |
| boneless | безкімнатний (ucraino) | significa «senza stanze»; il significato voluto era «senza ossa» |
| Pad Thai | Подушка тайська (ucraino) | il nome del piatto è stato letto come parole: «Thai cushion», cioè cuscino tailandese |
| Rice flour, brown | Рисова борошно, коричневий (ucraino) | gli aggettivi non concordano con il sostantivo «борошно» (farina), il che è scorretto in ucraino |
| Meringue with chocolate; Ham salad spread | lasciato in parte o del tutto non tradotto (ucraino) | le parole inglesi restano nel nome |
| bun | chignon (francese) | uno chignon (l’acconciatura), mentre si intendeva il panino dolce |
| sauerkraut | chouchoune (francese) | una parola diversa; la parola francese per i crauti è choucroute |
La stessa debolezza colpisce le query, dove una parola sbagliata significa un prodotto mancante, e non si può correggere in locale: in un modello neurale non si può correggere una sola parola. C’erano due ragioni minori: i modelli occupano circa 40 MB per lingua e l’SDK è un componente di terze parti.
I dati che possediamo indicano uno strumento migliore. La nostra base ha coppie di un nome inglese e del suo nome in ciascuna lingua, un corpus parallelo esattamente nel dominio che ci serve. Da un corpus del genere si può imparare un dizionario.
6. Un dizionario appreso con l’allineamento delle parole
Imparare un dizionario da un testo parallelo è il vecchio problema dell’allineamento delle parole: decidere quale parola di una frase corrisponde a quale parola dell’altra. La famiglia classica è quella dei modelli IBM di traduzione automatica statistica [1]. Il Modello 1, il più semplice e il nostro punto di partenza, tratta un nome in una lingua come generato dalle parole dell’altra, senza tenere conto dell’ordine. Per un nome inglese e un nome in un’altra lingua (con una parola vuota aggiunta), la probabilità della coppia è
e la tabella delle probabilità di traduzione delle parole , cioè il dizionario, viene stimata con l’algoritmo expectation–maximisation: a ogni giro ogni coppia di parole in una coppia di nomi riceve una quota del conteggio proporzionale alla probabilità corrente, e le quote vengono normalizzate in nuove probabilità. Per un nome alimentare breve questo si adatta bene, perché c’è poco ordine delle parole da modellare. La sua debolezza nota è stata descritta da Moore [2]: una parola rara può prendere qualsiasi probabilità che si adatti alla sua singola frase, quindi le parole rare diventano «collettori di spazzatura» che si allineano a troppe parole. Moore ha proposto di lisciare i conteggi e un’inizializzazione migliore; un prior bayesiano sulle probabilità di traduzione, applicato con l’inferenza variazionale, è un altro rimedio [7].
Che cosa abbiamo considerato e misurato
Abbiamo confrontato il nostro allineatore con le sue versioni ridotte, con implementazioni di riferimento di due allineatori pubblicati e con un metodo che non ha alcun modello di allineamento. Ogni metodo ha ricevuto le stesse coppie di nomi, lo stesso 5% di dati di verifica e lo stesso modo di trasformare gli allineamenti in un dizionario (una coppia di parole conta se è collegata almeno due volte; ogni parola riceve la sua traduzione più frequente). La qualità è l’F1 degli stemmi delle parole tra la traduzione dal dizionario di un nome di verifica, parola per parola, e il suo nome inglese, mediato su nove lingue (Tabella 1). Le differenze sono piccole, quindi riportiamo anche in quante delle nove lingue una differenza è chiara (intervallo bootstrap al 95% della differenza accoppiata che non include lo zero).
| Metodo | Che cos’è | F1 medio | Rispetto al nostro |
|---|---|---|---|
| Dice coefficient | nessun modello di allineamento, ogni parola si collega alla parola con cui co-occorre più spesso | 0.812 | peggiore in 7 su 9 |
| IBM Model 1 [1], EM | probabilità di traduzione delle parole, senza ordine delle parole | 0.817 | peggiore in 6 su 9 |
| Model 1 con un prior di Dirichlet [7] | Bayes variazionale sulle probabilità di traduzione | 0.822 | peggiore in 4 su 9 |
| Prior di allineamento diagonale, EM | Model 2 nella parametrizzazione di fast_align [5], senza il prior bayesiano | 0.822 | peggiore in 6 su 9 |
| Il nostro | prior diagonale e prior di Dirichlet, due direzioni, intersezione | 0.825 | – |
| Il nostro, grow-diag-final-and | lo stesso, con i collegamenti di entrambe le direzioni combinati con l’euristica standard | 0.828 | migliore in 5 su 9, peggiore in 1 |
| fast_align [5] | l’implementazione degli autori, intersezione / grow-diag-final-and | 0.826 / 0.831 | 3 migliori, 2 peggiori / 7 migliori |
| eflomal [8] | HMM con fertilità, bayesiano, campionamento MCMC; intersezione / grow-diag-final-and | 0.825 / 0.828 | 2 migliori, 2 peggiori / 7 migliori |
| SimAlign [10] | embedding BERT multilingue, nessun addestramento sui nostri nomi; tre metodi di matching (best / iterative / intersection) | 0.824 / 0.822 / 0.812 | 2 migliori, 2 peggiori / 1 migliore, 3 peggiori / peggiore in 8 |
Tabella 1. Allineatori confrontati su nomi di verifica della nostra base, nove lingue. L’ultima colonna conta le lingue in cui la differenza rispetto al nostro è chiara. fast_align ed eflomal sono le implementazioni degli autori.
Il coefficiente di Dice puro è indietro di appena 0.013 rispetto al nostro, e SimAlign, che non richiede addestramento sui nostri nomi, è alla pari con il nostro nella sua impostazione migliore. Con nomi brevi e quasi paralleli la scelta dell’allineatore conta poco, e gran parte della qualità viene dai nomi stessi. Ogni ingrediente del nostro aggiunge un po’, e il vero fast_align con la stessa intersezione dà lo stesso risultato (0.826 contro 0.825), che è ciò che ci aspettiamo da un metodo con lo stesso disegno. Combinare le due direzioni con l’euristica standard grow-diag-final-and invece dell’intersezione aiuta quanto la scelta del modello: tra un quarto e mezzo punto di F1 per tutti e tre. È un piccolo guadagno che è chiaro nella maggior parte delle lingue, e pensiamo di usarlo la prossima volta che i dizionari verranno ricostruiti.
Ridurre le parole agli stemmi Snowball prima dell’allineamento abbassa l’F1 (0.818, peggiore in 6 delle 9 lingue), e tenere solo le prime quattro lettere di ogni parola, che Östling e Tiedemann riportano come uno stemming approssimativo utile per la traduzione automatica [8], la abbassa molto di più (0.743). Il compito spiega la differenza: Östling e Tiedemann misurano sistemi di traduzione costruiti sugli allineamenti, mentre noi cerchiamo nel dizionario singole parole di un nome alimentare, dove unire le forme delle parole significa unire alimenti diversi.
Non abbiamo eseguito il campionatore di Gibbs di Mermer e Saraçlar [9] (un Modello 1 completamente bayesiano), i Modelli IBM 3–5, né le query strutturate probabilistiche di Darwish e Oard [4], che mantengono più traduzioni per parola. L’ultima è un possibile passo successivo, dato che il nostro dizionario conserva solo il candidato migliore.
Che cos’è il nostro allineatore
Il nostro allineatore è una nostra implementazione di un IBM Model 2 nella parametrizzazione di fast_align [5]: la probabilità che una parola sia allineata a una data posizione diminuisce con la distanza dalla diagonale (nel Modello 1 è uniforme), perché i nomi alimentari tendono a mantenere l’ordine delle parole tra le lingue. Sopra questo, le probabilità di traduzione delle parole ricevono un prior di Dirichlet sparso con inferenza variazionale [7], come in fast_align, che impedisce alle parole rare di assorbire probabilità. Le costanti fisse (la probabilità di allineare una parola alla parola vuota, la forza del prior e la pendenza iniziale della diagonale) sono quelle riportate da Dyer et al.; fast_align stima di nuovo anche la pendenza durante l’addestramento, noi no. Viene addestrato in entrambe le direzioni, e si mantengono solo i collegamenti su cui concordano entrambe le direzioni (intersezione), il che alza la precisione a costo di un certo richiamo. Le parole vengono allineate nelle loro forme esatte senza stemming: ridurre le parole agli stemmi, cosa usuale per le lingue con ricche desinenze, ha ridotto l’accuratezza nelle nostre prime prove, quindi composti e parole con trattino vengono gestiti tramite frasi.
Il risultato è un dizionario su tre livelli che il traduttore applica partendo dalla corrispondenza più lunga di fino a tre parole: voci della tassonomia, frasi allineate nella nostra base e singole parole allineate nella nostra base. Una parola che non è nel dizionario, come un marchio o un errore di battitura, passa invariata, perché OFF spesso la conosce. Ogni lingua è un file di qualche centinaio di kilobyte, contro circa 40 MB per lingua dei modelli neurali. Funziona offline e ogni traduzione può essere ricondotta a una riga del dizionario e corretta.
Quanto è buona la traduzione
Misuriamo il traduttore in due modi. Sul 5% delle coppie di nomi tenute fuori dall’addestramento, traducendo il nome straniero parola per parola e confrontando il risultato con il nome inglese tramite gli stemmi delle parole, si ottiene un F1 tra 0.78 e 0.90 nelle nove lingue. Sulle query di valutazione, per cui abbiamo scritto una traduzione inglese di riferimento insieme a ogni query, l’F1 degli stemmi delle parole è 0.94 per il tedesco (88 query su 100 identiche negli stemmi) e 0.96 per l’ucraino (89 su 100).
Questi numeri descrivono la traduzione in inglese di query brevi e comuni. La qualità della ricerca in sé è più bassa e viene misurata a parte (sezioni 3 e 9). Non abbiamo eseguito il vecchio traduttore neurale sulle stesse query, quindi non affermiamo che il dizionario sia migliore di ML Kit; su queste query è abbastanza accurato, piccolo, offline e correggibile.
7. Le tassonomie di Open Food Facts: che cosa danno e che cosa costano
OFF mantiene tassonomie pubbliche di ingredienti e categorie: liste gerarchiche in cui ogni voce ha un nome inglese e nomi e sinonimi in molte lingue, scritti da volontari. Contengono migliaia di voci con un nome inglese, e sono interessanti per tre motivi: le traduzioni sono fatte da persone e nel dominio alimentare, contengono parole che i nostri nomi non usano mai (ingredienti rari), e sono indipendenti dalla traduzione automatica che ha prodotto i nostri nomi.
Le difficoltà:
- Copertura disomogenea. La quota di voci con un nome in una data lingua va dall’1.6% (categorie ucraine) all’84.6% (categorie francesi), quindi la tassonomia non può essere l’unica fonte. La applichiamo per prima, dove esiste una voce, e lasciamo che il dizionario della nostra base riempia il resto.
- Nomi in stile categoria e molti sinonimi. Una voce ha un solo nome inglese e molti sinonimi in una lingua. Ogni sinonimo viene accoppiato con il nome inglese principale, e i nomi inglesi molto lunghi vengono saltati.
- Frasi oltre alle parole. I nomi della tassonomia sono frasi, quindi il traduttore cerca in ogni posizione la frase più lunga prima delle singole parole.
- Rumore. Quando la tassonomia viene usata anche come dati di addestramento, le sue frasi in stile categoria competono con le frasi idiomatiche della nostra base. Il peso delle coppie della tassonomia andava misurato. Un peso troppo grande faceva perdere accuratezza sulle parole comuni, e l’intervallo che funziona è stretto.
Addestrare sulla tassonomia: un test che non poteva vedere l’effetto
Il nostro primo test dell’aggiunta di coppie della tassonomia all’addestramento dell’allineamento non ha mostrato nulla. Lo abbiamo misurato su nomi di verifica della nostra base e sulle nostre query, e la qualità della traduzione si è mossa al massimo di pochi millesimi. Siamo stati quasi sul punto di concludere che la tassonomia fosse utile solo come ricerca. Quel test non poteva vedere l’effetto: entrambi gli insiemi contengono parole che la nostra base conosce già, mentre lo scopo della tassonomia è aggiungere parole che la base non ha.
Il test corretto toglie un decimo delle voci della tassonomia dal livello di ricerca e dall’addestramento, costruisce il dizionario con e senza addestramento sulla tassonomia, e traduce i nomi delle voci tolte. Per le lingue con una tassonomia ampia l’addestramento aggiunge da due a quattro punti di F1 su tutti i nomi di verifica e da quattro a cinque punti sui nomi con una parola che la nostra base non ha, senza perdite sui nomi fatti di parole note (Figura 3). Per le lingue con una tassonomia piccola, come ucraino e rumeno, non cambia nulla. Abbiamo ribaltato la nostra raccomandazione iniziale, e i dizionari dell’app sono costruiti con l’addestramento sulla tassonomia.
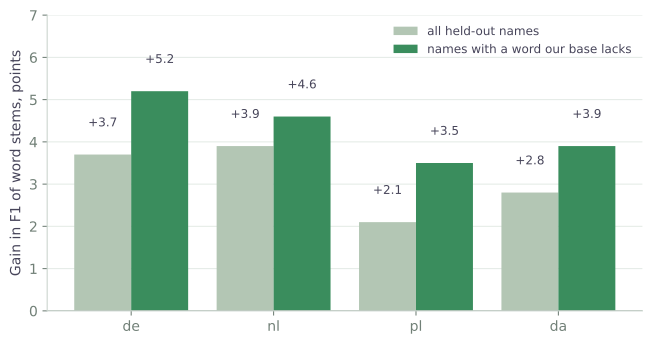
Dove può nuocere. I nomi della tassonomia sono in stile categoria, e i loro sinonimi possono spostare una frase idiomatica appresa dalla nostra base («home fries» per un piatto di patate fritte). Sulle query tedesche questo è costato circa un punto di F1 e niente per l’ucraino, un prezzo che abbiamo accettato per il guadagno sulle parole rare.
8. Pesi delle quattro liste per lingua
Nell’Equazione (1) ogni lista ha un peso. I nostri primi pesi erano uguali per tutte le lingue, tarati su un solo insieme di query. Ma la qualità delle liste varia tra le lingue. La lista OFF nativa C è ricca in francese o tedesco e scarsa in ucraino, dove la lista inglese D porta più del carico. Dare a ogni lingua i propri pesi è un’idea naturale, e la domanda è da dove prenderli per dieci lingue quando abbiamo query di prova per due.
Abbiamo considerato due misure. La prima era la quota di voci della tassonomia che hanno un nome nella lingua. È facile da calcolare, ma misura quanto bene i volontari hanno tradotto il vocabolario, cosa che incide sul dizionario, e dice poco su quanti prodotti hanno un nome in quella lingua; le sue due colonne sono perfino in disaccordo tra loro (italiano: 75% degli ingredienti e 28% delle categorie). Non l’abbiamo usata. La seconda era il numero di prodotti OFF per lingua rispetto all’inglese, disponibile dal servizio di ricerca (Figura 1). È un indicatore indiretto, perché la lingua principale di un prodotto può differire dalla lingua di un campo del nome, e tuttavia segue ciò che ci serve: quanto è probabile che la lista nativa conosca il prodotto. Da questo ricaviamo un peso per ogni lingua con una formula regolare, che dà più peso alla lista nativa man mano che la lingua cresce, e fissiamo i valori in una piccola tabella di consultazione nell’app.
Sulle 200 query tedesche e ucraine giudicate, l’effetto è chiaro per il tedesco e assente per l’ucraino (Figura 4). L’MRR tedesco sale di .062 (intervallo bootstrap al 95% della differenza da +.030 a +.099) e il primo posto di 7 punti, mentre i primi cinque guadagnano 3 punti, entro il rumore. L’MRR ucraino scende di .002, perché i suoi nuovi pesi sono vicini ai vecchi pesi comuni. Il guadagno tedesco vale in entrambe le metà delle query, quando vengono divise in quelle dispari e quelle pari.
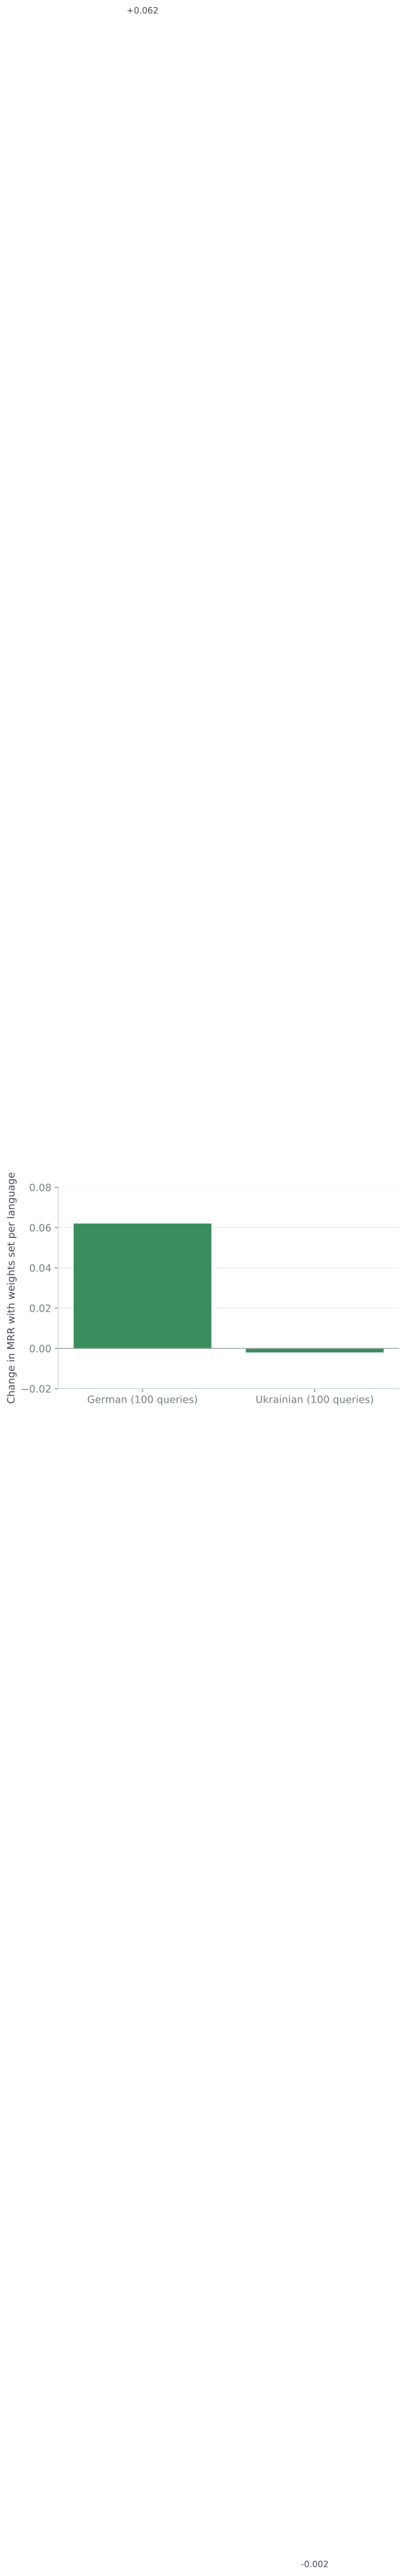
Le costanti della formula sono state fissate sulle stesse query, e i pesi delle altre lingue derivano dalla formula e non sono stati misurati.
9. Errori di battitura e forme delle parole
Il dizionario conosce le forme esatte delle parole. Una parola con un errore di battitura, o una forma di caso che non ha mai visto, passa invariata e arriva alle liste inglesi come una parola che lì non significa nulla. La ricerca nella nostra base locale corregge già gli errori con un indice SymSpell, un indice di distanza di modifica in cui il numero di modifiche consentite cresce con la lunghezza della parola. La domanda aperta riguardava il passo di traduzione, quindi abbiamo misurato quanto costano gli errori e che cosa dà un meccanismo di ripiego.
Passo 1: errori e forme delle parole, parola per parola
Abbiamo ricostruito i dizionari delle nove lingue dai nostri nomi e abbiamo preso, dai nomi di verifica, le parole con una traduzione nota. A ciascuna è stata applicata una modifica casuale (una lettera cancellata, inserita, sostituita o due lettere vicine scambiate). Una ricerca entro la distanza di modifica consentita ha restituito la traduzione della parola originale per il 92.5% delle parole danneggiate, contro lo 0.3% della ricerca esatta. Se la prima lettera doveva corrispondere, come può richiedere la ricerca nella base locale, la percentuale è scesa al 77%, perché gli errori sulla prima lettera allora non vengono trovati.
Per le forme delle parole abbiamo preso le parole di verifica che il dizionario non conosce ma il cui stemma Snowball è uguale allo stemma di una parola nota (per lo più un altro caso o numero di una parola nota). La distanza di modifica ha dato una traduzione giusta per il 55% di esse, un inizio comune della parola per il 63%, e lo stesso stemma per il 69%. Le desinenze dei casi cambiano spesso più lettere, cosa che il limite di modifiche non consente. Le restanti parole sconosciute (marchi, parole rare, numeri) sono un rischio: la distanza di modifica risponde per un quarto di esse ed è giusta in un terzo delle risposte. Usiamo gli stemmi solo in fase di ricerca; durante l’addestramento abbassavano la qualità (sezione 6).
Passo 2: il ripiego sui dizionari reali
I dizionari dell’app tralasciano le parole che sono scritte allo stesso modo nelle due lingue, quindi una parola del genere è «sconosciuta» per il ripiego. Un ripiego semplice cambiava quindi parole che erano giuste: pizza diventava nicoise, pils diventava mushroom, il marchio Krönung diventava curd. Sulle query come scritte, l’F1 delle parole della traduzione scendeva di 3 punti. Tre protezioni eliminano la maggior parte del danno: una parola che è essa stessa una parola inglese del dizionario viene lasciata stare, le parole molto corte vengono lasciate stare, e la distanza di modifica consentita resta piccola. L’ordine è: ricerca esatta, stesso stemma, una modifica. Con le protezioni la perdita sulle query come scritte si riduce a 1.5 punti, e sulle query con un errore l’F1 sale di 30 punti.
Passo 3: l’intera ricerca
L’F1 delle parole confronta una traduzione con un riferimento, e una ricerca ha altre liste che possono assorbire una traduzione cattiva. Quindi abbiamo eseguito l’intera ricerca, come nella sezione 3, su 200 query (100 tedesche e 100 ucraine): come scritte, e con un errore di battitura casuale in una parola di ogni query (195 query modificate). Ogni query è stata tradotta in quattro modi: la traduzione corretta (un limite superiore), il dizionario così com’era, il dizionario con il ripiego semplice e il dizionario con le protezioni. Le quattro liste ordinate sono state fuse con i pesi dell’app, e un modello linguistico ha giudicato alla cieca i risultati raccolti.
| Traduzione | Query come scritte primo / primi cinque, punti | Un errore per query primo / primi cinque, punti |
|---|---|---|
| Corretta (limite superiore) | +0.5 / −1.0 | +15.0 / +11.5 |
| Dizionario, ripiego semplice | +1.5 / +1.0 | +8.5 / +4.5 |
| Dizionario, ripiego con protezioni | +2.0 / +0.5 | +7.5 / +4.0 |
Tabella 2. Variazione rispetto al dizionario com’era, in punti della quota di query con il prodotto giusto al primo posto e tra i primi cinque.
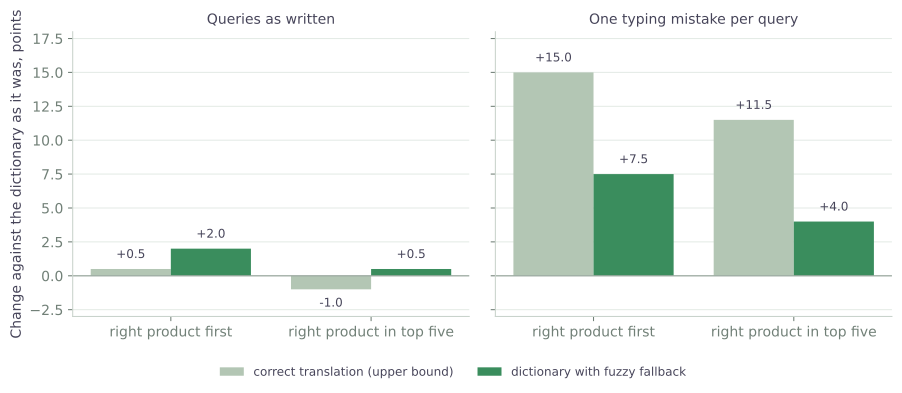
Sulle query come scritte il dizionario è buono quanto la traduzione corretta (mezzo punto indietro al primo posto, un punto avanti nei primi cinque), e il ripiego non cambia nulla che possiamo rilevare (4 query guadagnate e nessuna persa al primo posto, p = 0.13). Con un errore di battitura il dizionario così com’era perde 15 punti al primo posto; il ripiego con protezioni ne recupera 7.5 (30 query guadagnate, 15 perse, p = 0.04) e 4 degli 11.5 punti nei primi cinque (11 guadagnate, 3 perse, p = 0.06). La ricerca che usa solo la lista inglese di Open Food Facts guadagna molto di più, 22 punti al primo posto, perché non ha una lista nativa a cui appoggiarsi. Il ripiego semplice e quello con protezioni non si distinguono nell’intera ricerca; teniamo quello con protezioni perché cambia meno parole corrette. Il guadagno varia per lingua: l’ucraino guadagna 15 punti al primo posto, il tedesco nessuno, e non abbiamo indagato il perché.
Passo 4: limiti della misura
Gli errori sono sintetici: una modifica casuale in quasi ogni query, molto più spesso di quanto le persone sbaglino davvero, e senza gli errori di tasti vicini di una tastiera reale. Duecento query e un solo modello come giudice danno valori p intorno a 0.05, quindi il risultato sugli errori di battitura indica la direzione, mentre l’entità precisa richiede query reali. Il guadagno per ogni query reale è il guadagno sopra moltiplicato per la quota di query con un errore, che non conosciamo; con un costo sulle query corrette vicino a zero, anche una quota piccola ripaga.
10. Che cosa non ha funzionato o non era necessario
- Eliminare la lista inglese locale. Sul secondo insieme di query la versione senza di essa non era migliore di quella a quattro liste (primi cinque 2 punti in meno, MRR .015 in meno, entro il rumore), quindi abbiamo mantenuto la struttura.
- Stemming prima dell’allineamento. È un consiglio standard per le lingue con ricche desinenze; nelle nostre prove ha perso accuratezza. Le forme esatte più le frasi hanno funzionato meglio.
- Un peso molto grande per le coppie della tassonomia. Ha aiutato un po’ sulle parole sconosciute in due lingue e ha perso sulle parole note. L’intervallo utilizzabile è stretto, e restiamo al suo interno.
- La copertura della tassonomia come peso di una lista. Misura la qualità della traduzione in quella lingua, e il numero di prodotti che esistono in essa è una grandezza separata.
- Un test che non poteva vedere l’effetto. Il nostro primo test sulla tassonomia guardava parole che la base conosceva già e faceva sembrare inutile la tassonomia. La lezione è chiedersi che cosa un test può vedere prima di fidarsi di un risultato nullo.
Come usiamo tutto questo in MuscleTiger
La ricerca di alimenti in MuscleTiger funziona come descritto: la tua query va alla nostra base e a Open Food Facts, nella tua lingua e in inglese, la query viene tradotta da un dizionario che vive sul tuo telefono, e le quattro graduatorie vengono fuse con pesi che dipendono dalla tua lingua. I risultati sono mostrati nella lingua dell’interfaccia dell’app e i prodotti venduti nel tuo paese sono messi in classifica prima degli altri. Il dizionario funziona senza rete, quindi una query in palestra senza segnale trova comunque alimenti nella nostra base locale.
Conclusioni
- La ricerca trova l’alimento cercato per il 92% delle query. In un test della ricerca completa in nove lingue è tra i primi dieci risultati per il 90% e al primo posto per il 67%; i prodotti singoli vengono trovati un po’ più spesso dei piatti.
- Conta soprattutto la traduzione in inglese. Con traduzioni corrette, aggiungere la lista inglese ha alzato di 61 punti la quota di query ucraine con il prodotto giusto tra i primi cinque rispetto a Open Food Facts solo in ucraino; le altre lingue cambiavano poco e, oltre quattro, abbassavano i primi cinque.
- Per le query alimentari un piccolo dizionario può fare il lavoro del traduttore. L’allineamento delle parole sui nostri nomi paralleli dà un file di qualche centinaio di kilobyte per lingua, offline, e riproduce le nostre traduzioni di riferimento di query brevi con un F1 degli stemmi tra 0.94 e 0.96. È l’accuratezza nella traduzione di query semplici; l’accuratezza della ricerca è misurata a parte ed è più bassa.
- Le tassonomie pubbliche aiutano di più dove i nostri dati tacciono. Addestrare il dizionario su di esse ha migliorato la traduzione dei termini rari di verifica di due-cinque punti nelle lingue con una tassonomia ampia, con un piccolo costo sui termini comuni.
- Il peso di ciascuna lista può dipendere dalla dimensione della lingua in OFF. Per il tedesco il cambiamento ha alzato l’MRR di .062 sulle nostre query; per l’ucraino non è cambiato nulla.
- Un ripiego per gli errori di battitura conviene. Con un errore di battitura il primo posto cala di 15 punti quando il traduttore conosce solo le forme esatte, e un ripiego con protezioni (stesso stemma, poi una piccola distanza di modifica) ne recupera metà; per le query come scritte non costa nulla che possiamo misurare.
- Il matching contava più delle lingue. Pesare le parole in base alla rarità, lo stemming e un unico formato dei numeri hanno dato il guadagno maggiore dello studio.
Limiti. Le query sono state scritte da noi e giudicate da un modello linguistico, quindi i margini sono ampi (circa punti con 200 query). I numeri riguardano tedesco e ucraino; i pesi delle altre lingue sono estrapolati. Non abbiamo confrontato con il traduttore neurale né con altre app. Il prossimo passo è una verifica su query reali di utenti.
Dati e licenze
I dati dei prodotti e le tassonomie provengono da Open Food Facts, resi disponibili con la Open Database Licence (ODbL); i dizionari qui descritti derivano in parte dalle tassonomie OFF e riportano la stessa attribuzione. La nostra base locale è costruita a partire da tabelle nazionali di composizione degli alimenti aperte, pubblicate dalle autorità pubbliche; le loro fonti e licenze sono elencate nell’app. Ringraziamo i collaboratori di Open Food Facts e i responsabili delle tabelle nazionali.
Fonti
- Brown PF, Della Pietra SA, Della Pietra VJ, Mercer RL. The mathematics of statistical machine translation: parameter estimation. Computational Linguistics 1993;19(2):263–311. ACL Anthology
- Moore RC. Improving IBM word-alignment Model 1. Proceedings of ACL 2004:518–525. ACL Anthology
- Cormack GV, Clarke CLA, Büttcher S. Reciprocal rank fusion outperforms Condorcet and individual rank learning methods. Proceedings of SIGIR 2009. doi:10.1145/1571941.1572114
- Darwish K, Oard DW. Probabilistic structured query methods. Proceedings of SIGIR 2003.
- Dyer C, Chahuneau V, Smith NA. A simple, fast, and effective reparameterization of IBM Model 2. Proceedings of NAACL-HLT 2013:644–648. ACL Anthology
- Open Food Facts: taxonomies of ingredients and categories and product data, world.openfoodfacts.org, under the Open Database Licence (ODbL).
- Riley D, Gildea D. Improving the IBM alignment models using variational Bayes. Proceedings of ACL (short papers) 2012:306–310. ACL Anthology
- Östling R, Tiedemann J. Efficient word alignment with Markov chain Monte Carlo. The Prague Bulletin of Mathematical Linguistics 2016;106:125–146.
- Mermer C, Saraçlar M. Bayesian word alignment for statistical machine translation. Proceedings of ACL (short papers) 2011:182–187. ACL Anthology
- Jalili Sabet M, Dufter P, Yvon F, Schütze H. SimAlign: high quality word alignments without parallel training data using static and contextualized embeddings. Findings of EMNLP 2020.