Notes de recherche MuscleTiger · N° 5
Recherche d’aliments dans toutes les langues : traduction des requêtes, fusion des bases et résultats des mesures
Vous tapez « Spiegelei mit Speck » ou « борщ з м’ясом » dans un journal alimentaire et vous vous attendez à voir un produit avec ses calories et ses macronutriments. Les plus grandes bases de données alimentaires ouvertes sont surtout rédigées en anglais et en français, alors que les gens cherchent dans leur propre langue, avec des noms de marques, des terminaisons de mots et des fautes de frappe. Cette note décrit comment nous avons construit la recherche d’aliments dans MuscleTiger, ce que nous avons essayé, ce qui s’est révélé inutile et ce que nous avons mesuré.
En bref
Notre recherche d’aliments trouve l’aliment recherché pour 92 % des requêtes dans neuf langues (section 3). Nous interrogeons quatre listes à la fois (notre propre base d’aliments en anglais et dans la langue de l’utilisateur, et Open Food Facts dans la langue de l’utilisateur et en anglais) et nous fusionnons les classements par la fusion réciproque des rangs (reciprocal rank fusion). Une requête dans une autre langue est d’abord traduite en anglais. Nous avons d’abord utilisé un traducteur neuronal embarqué sur l’appareil, puis nous l’avons remplacé par un petit dictionnaire appris à partir de nos propres noms d’aliments parallèles, à l’aide d’un aligneur de mots de la famille IBM Model 2 avec un prior bayésien, et à partir des taxonomies d’Open Food Facts. Sur nos requêtes de test, le dictionnaire reproduit la traduction anglaise de référence avec une F1 des radicaux de mots de 0.94 (allemand) et 0.96 (ukrainien) ; cette mesure porte sur la traduction de requêtes courtes et simples. Avec des traductions correctes, l’ajout de la liste anglaise augmente de 61 points la part des requêtes ukrainiennes dont le bon produit figure dans le top cinq, et les autres langues n’apportent guère. Les poids des quatre listes, qui dépendent de la taille de la langue dans Open Food Facts, ont amélioré l’allemand et laissé l’ukrainien inchangé. Une solution de repli pour les fautes de frappe dans le traducteur récupère environ la moitié des 15 points que coûte une faute.
Nous expliquons l’approche et les familles de méthodes que nous avons envisagées.
1. Le problème : une requête dans une langue, des données dans plusieurs
Une recherche d’aliments doit bien faire trois choses à la fois. Elle doit comprendre une requête courte et désordonnée (« blanc de poulet 200g », « coca cola zero », « мигдальне молоко »). Elle doit trouver un produit dont les valeurs nutritionnelles sont complètes et plausibles. Et elle doit fonctionner dans la langue de la personne, sur un téléphone, rapidement et, idéalement, hors ligne.
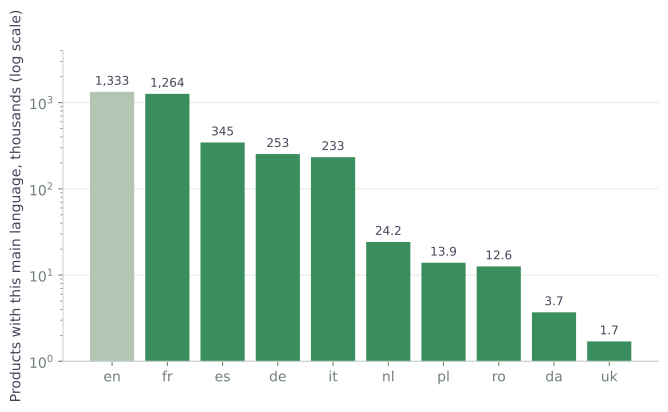
Les données dont nous disposons sont inégales. Open Food Facts (OFF) [6], la base de données ouverte des produits emballés, compte des millions de produits, mais la langue d’un produit suit le pays où il est vendu et les habitudes de ses contributeurs. Si l’on compte les produits selon leur langue principale (OFF, 15 novembre 2026), l’anglais et le français arrivent en tête avec environ 1.3 million de produits chacun, l’espagnol, l’allemand et l’italien suivent avec 230 à 350 mille, et les langues plus petites que nous prenons en charge en comptent entre 1.7 et 25 mille (Figure 1). Une requête en ukrainien peut donc être traitée en ukrainien par très peu de produits, alors qu’une requête en français rencontre une base de données déjà majoritairement française.
Notre propre base
La deuxième source est notre propre base d’aliments avec une énergie et des macronutriments complets. Il s’agit d’une fusion de plusieurs tables nationales de composition des aliments, choisies parce qu’elles sont ouvertes, mesurées en laboratoire et complètes en macronutriments. Beaucoup de ses aliments comportent des portions ménagères telles que « 1 tranche ». Un aliment est ignoré lorsqu’un aliment du même nom figure déjà dans la base, et les nouvelles lignes sont toujours ajoutées après les anciennes, de sorte que le numéro d’un produit et de ses traductions ne change jamais lorsqu’une table est ajoutée.
Lorsque nous avons ensuite ajouté trois tables supplémentaires, la part des requêtes de test dont le bon produit figure dans le top cinq a augmenté de 3 points, et celle de la première place de 2 points ; aucune de ces variations n’est significative. Le gain vient surtout de plats courants que les nouvelles tables décrivent en anglais simple, comme les lasagnes, le cappuccino ou le yaourt grec. Nous avons écarté une table candidate, car sa licence comporte une clause de partage à l’identique qui pourrait s’étendre à notre base fusionnée.
Les tables sont rédigées en anglais ou dans la langue de leur pays, si bien que les noms dans les autres langues ont dû être produits. Les noms anglais sont l’original ; les noms dans les autres langues ont été produits par traduction automatique, puis en partie refaits par des agents fondés sur des modèles de langage, avec des contrôles automatiques (un validateur rejette une réponse qui modifie les nombres, les unités ou la structure du nom). Dans les noms, les nombres utilisent un point décimal dans toutes les langues, dans la base comme dans la requête, afin qu’une requête avec un pourcentage de matières grasses puisse préférer le produit ayant ce pourcentage.
2. Quatre listes et un seul classement
Le principe que nous utilisons est simple à énoncer. Chaque requête est recherchée à quatre endroits :
- A : notre base locale, avec la requête traduite en anglais ;
- B : notre base locale, avec la requête telle que saisie dans la langue de l’utilisateur ;
- C : Open Food Facts, interrogée dans la langue de l’utilisateur ;
- D : Open Food Facts, interrogée avec la traduction anglaise.
Chaque liste renvoie son propre classement, et les classements sont fusionnés par la fusion réciproque des rangs (reciprocal rank fusion, RRF) [3]. Un produit qui apparaît en haut de plusieurs listes l’emporte sur un produit placé premier dans une seule liste :
où est la position du produit dans la liste , est un poids de la liste et est une petite constante qui empêche la première place de dominer tout. La méthode n’a besoin d’aucun score des listes, seulement de leur ordre, ce qui compte, car les listes proviennent de systèmes différents dont les scores ne sont pas comparables. C’est précisément pour cette raison que nous l’avons choisie ; Cormack et al. rapportent qu’elle est compétitive avec des méthodes d’apprentissage de classement plus élaborées dans leurs expériences [3].
La RRF est une méthode publiée, et notre contribution réside dans la mesure : quelles listes inclure, comment traduire la requête et quelle confiance accorder à chaque liste dans chaque langue.
3. Comment nous avons mesuré
Le protocole :
- Nous avons rédigé des ensembles de requêtes de plusieurs types : marque plus produit, plat, aliment courant, boisson, et formulations informelles ou mal orthographiées. Un ensemble compte 959 requêtes, dont 200 ont été jugées en détail ; un second ensemble compte 200 requêtes, 100 en allemand et 100 en ukrainien, avec 20 de chaque type. Un ensemble distinct de plats d’autres cuisines (par exemple un plat japonais demandé en allemand) teste si la langue de la requête doit suivre le plat.
- Pour chaque requête, nous avons regroupé les premiers résultats de chaque configuration, et un modèle de langage a jugé chaque candidat pertinent ou non, en voyant la requête et la traduction anglaise, mais sans savoir quelle configuration avait renvoyé le candidat. Le juge ne pouvait donc pas favoriser une méthode.
- Nous indiquons le top-1 (le bon produit est en premier), le top-5 (il figure parmi les cinq premiers) et le MRR, la moyenne de du premier résultat pertinent. Pour les comparaisons entre configurations, nous appairons les résultats par requête et utilisons des tests des signes et des intervalles de bootstrap.
Précision de la recherche complète
Le chiffre du résumé provient d’un test de la recherche telle qu’elle fonctionne dans l’application. Nous avons écrit dix requêtes dans chacune des neuf langues que l’application prend en charge en plus de l’anglais, deux de chaque type, soit 90 requêtes au total. Chaque requête a suivi les mêmes étapes que sur un téléphone : traduction par le dictionnaire, notre base en anglais et dans la langue de la requête, Open Food Facts dans les deux langues avec les produits vendus dans le pays de cette langue placés en tête, et la fusion avec les poids de l’application. Nous avons lu toute la liste fusionnée de chaque requête, une soixantaine de résultats en moyenne, et marqué à la main le premier résultat qu’un utilisateur accepterait comme l’aliment voulu, avec les mêmes règles que le juge à l’aveugle.
| L’aliment recherché est trouvé | Toutes les requêtes (90) | Produits simples (65) | Plats (25) |
|---|---|---|---|
| n’importe où dans la liste | 92.2% | 93.8% | 88.0% |
| parmi les dix premiers | 90.0% | 90.8% | 88.0% |
| parmi les cinq premiers | 85.6% | 86.2% | 84.0% |
| en première position | 66.7% | 67.7% | 64.0% |
Précision de la recherche complète. Dix requêtes dans chacune des neuf langues, recherchées comme dans l’application. Les produits simples sont des aliments, des produits emballés et des boissons ; les plats comprennent aussi des repas composés, comme un sandwich au fromage ou des flocons d’avoine au lait.
L’aliment recherché figure quelque part dans la liste pour 92 % des requêtes, parmi les dix premiers résultats pour 90 %, parmi les cinq premiers pour 86 % et en première position pour 67 %. Les produits simples sont trouvés un peu plus souvent que les plats (94 % contre 88 % n’importe où dans la liste). Les échecs concernent surtout des produits de marque qu’aucune liste ne contient, et des en-cas composés de plusieurs aliments, pour lesquels les listes proposent les ingrédients sans l’en-cas lui-même. Dix requêtes par langue, c’est une base réduite : une seule requête déplace le résultat d’une langue de dix points, donc ces chiffres décrivent la recherche dans son ensemble et disent peu de chose d’une langue en particulier. Les sections suivantes décomposent la recherche et mesurent chaque étape sur des ensembles de requêtes plus grands en allemand et en ukrainien.
4. Ce que fait une traduction correcte pour la recherche
Avant de décrire nos tentatives pour construire un bon traducteur, nous avons mesuré ce que vaut une bonne traduction. Nous avons rédigé 100 requêtes d’aliments en ukrainien (20 pour chacune des catégories : aliments courants, plats, boissons, marques et requêtes informelles) et nous les avons traduites à la main dans les neuf autres langues, de sorte que la traduction est correcte par construction. Pour chaque langue, nous avons interrogé Open Food Facts avec la requête dans cette langue et fusionné les listes par la fusion réciproque des rangs (équation 1, poids égaux). La première configuration est l’ukrainien seul, la deuxième ajoute l’anglais, puis nous avons ajouté le français, l’espagnol, l’allemand, l’italien, le néerlandais, le polonais, le roumain et le danois, dans l’ordre du nombre de produits que chaque langue compte dans OFF (Figure 2). La pertinence a été jugée à l’aveugle par un modèle de langage selon les règles de la section 3, sur les cinq premiers regroupés de chaque configuration.
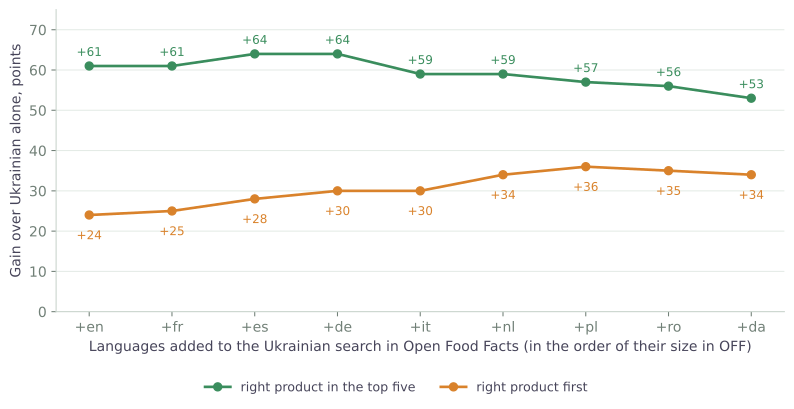
La première étape est de loin la plus grande. Une recherche dans OFF en ukrainien seul ne trouve souvent rien : OFF compte peu de produits en ukrainien (Figure 1), et pour 47 des 100 requêtes la liste ukrainienne était vide. L’ajout de la traduction anglaise augmente de 61 points la part des requêtes dont le bon produit figure dans le top cinq, et de 24 points celle de la première place, avec 61 requêtes gagnées et aucune perdue.
Les langues suivantes changent peu. Le français laisse le top cinq inchangé (5 requêtes gagnées, 5 perdues). L’espagnol et l’allemand ajoutent 3 points de plus, dans la marge d’erreur. Ensuite, le top cinq baisse, de 11 points par rapport à son maximum avec les dix langues, tandis que la première place progresse encore, de 10 à 12 points. La baisse du top cinq, de quatre à dix langues, est significative sur ces requêtes (2 gagnées, 13 perdues, test des signes p = 0.007) ; la hausse de la première place, de deux à dix langues, ne l’est pas (20 gagnées, 10 perdues, p = 0.10). Les marques se comportent autrement que les aliments courants : avec plus de listes, une requête de marque est trouvée plus souvent (15 points de plus dans le top cinq avec l’espagnol ajouté qu’avec l’anglais seul), tandis que les aliments courants sont trouvés moins souvent (25 points de moins avec dix langues qu’avec l’anglais). Vingt requêtes par type forment une base réduite, ces répartitions sont donc indicatives.
Une traduction correcte en anglais porte à elle seule cet effet. Chaque langue supplémentaire est une requête de plus adressée à OFF et, au-delà des premières, dilue le classement.
Plats d’une autre cuisine
Le passage à l’anglais compte le plus lorsque le plat vient d’une autre cuisine. Un ensemble distinct de 100 requêtes, dix dans chacune des dix langues, désignait un plat étranger bien connu comme un utilisateur le taperait : Borschtsch pour un utilisateur allemand, paella, pierogi, tiramisu, stroopwafel, sarmale. Il s’agit d’une expérience plus ancienne, et les requêtes ont été traduites par le traducteur neuronal que l’application utilisait alors (section 5). Pour les 90 requêtes non anglaises, traduire la requête en anglais a augmenté de 34 points la part des cas où le plat figure dans le top cinq, par rapport à une recherche dans Open Food Facts dans la langue propre de l’utilisateur (47 requêtes gagnées, aucune perdue, p < 0.001). Ajouter d’autres langues après l’anglais n’a rien changé dans le top cinq, même lorsque nous avons choisi à l’avance la langue du pays d’origine du plat.
Notre base locale a été utile ici : sans sa liste anglaise, la première place recule de 8 points sur ces requêtes (7 perdues, aucune gagnée, p = 0.016), car la base connaît la paella, la ratatouille ou les lasagnes et les classe en premier. Pour les aliments courants, elle n’a montré aucun avantage de ce type, mais la retirer n’a pas non plus amélioré la recherche (section 10), c’est pourquoi nous la conservons. Les échecs restants concernaient des plats qu’aucune liste d’OFF ne possède sous aucun nom, comme sarmale. L’ensemble ne compte qu’une vingtaine de plats distincts ; il décrit donc des plats bien connus et en dit peu sur les plats rares.
Le rapprochement des mots a compté plus que les langues
La plus grande amélioration unique de toute l’étude vient du rapprochement des mots dans la base locale, sans aucune traduction. La base locale est interrogée avec son propre appariement, et les mots-outils, les terminaisons de cas et les virgules décimales le faussaient : « soup with mushrooms » en ukrainien ne renvoyait rien, car l’appariement exigeait que chaque mot de la requête soit trouvé tel qu’il était saisi. Une pondération des mots de la requête selon leur rareté (IDF), un stemmer Snowball pour les langues qui en disposent et un seul format des nombres ont amélioré le top-5 sur l’ensemble standard d’environ 9 % depuis le début de l’étude (test des signes p = 0.008), et de près de 12 % sur les requêtes contenant des prépositions et des formes de mots.
5. Pourquoi nous avons remplacé le traducteur
Nous avons retiré ML Kit parce qu’il traduit mal les noms d’aliments. C’est un traducteur généraliste conçu pour des phrases, alors qu’un nom d’aliment se compose de quelques mots sans contexte : une marque, un état du produit, un plat qui porte le nom d’un lieu. Notre base a d’abord été traduite avec lui, et voici de vraies entrées (les traductions ukrainiennes et françaises, avec une glose pour les lecteurs qui ne parlent pas la langue) :
| Nom anglais | Résultat de ML Kit | Ce qui a mal tourné |
|---|---|---|
| plain, refrigerated | рівнина, холодильна (ukrainien) | « plain » signifie ici « nature », comme dans un yaourt nature, et il a été traduit par « plain », c’est-à-dire la plaine ; « refrigerated » est devenu un adjectif signifiant « de réfrigérateur » |
| boneless | безкімнатний (ukrainien) | signifie « sans pièces » ; le sens voulu est « sans os » |
| Pad Thai | Подушка тайська (ukrainien) | le nom du plat a été lu mot à mot : « coussin thaï » |
| Rice flour, brown | Рисова борошно, коричневий (ukrainien) | les adjectifs ne s’accordent pas avec le nom « flour », ce qui est agrammatical en ukrainien |
| Meringue with chocolate; Ham salad spread | laissé en partie ou entièrement non traduit (ukrainien) | les mots anglais restent dans le nom |
| bun | chignon (français) | un chignon (la coiffure), alors que le petit pain était visé |
| sauerkraut | chouchoune (français) | un autre mot ; le mot français pour « sauerkraut » est « choucroute » |
La même faiblesse touche les requêtes, où un mot faux équivaut à un produit manquant, et elle ne peut pas être corrigée localement : on ne peut pas corriger un seul mot dans un modèle neuronal. Il y avait deux raisons secondaires : les modèles pèsent environ 40 Mo par langue et le SDK est un composant tiers.
Les données que nous possédons désignent un meilleur outil. Notre base contient des paires d’un nom anglais et de son nom dans chaque langue, un corpus parallèle exactement dans le domaine dont nous avons besoin. Un dictionnaire peut être appris à partir d’un tel corpus.
6. Un dictionnaire appris par alignement de mots
Apprendre un dictionnaire à partir d’un texte parallèle relève du vieux problème de l’alignement de mots : décider quel mot d’une phrase correspond à quel mot de l’autre. La famille classique est celle des modèles IBM de traduction automatique statistique [1]. Le modèle 1, le plus simple et notre point de départ, traite un nom dans une langue comme engendré à partir des mots de l’autre, sans tenir compte de l’ordre. Pour un nom anglais et un nom dans une autre langue (avec un mot vide ajouté), la probabilité de la paire est
et la table des probabilités de traduction des mots , c’est-à-dire le dictionnaire, est estimée par l’algorithme espérance-maximisation : à chaque tour, chaque paire de mots d’une paire de noms reçoit une part du décompte proportionnelle à la probabilité courante, et ces parts sont normalisées en de nouvelles probabilités. Pour un nom d’aliment court, cela convient bien, car il y a peu d’ordre des mots à modéliser. Sa faiblesse connue a été décrite par Moore [2] : un mot rare peut prendre n’importe quelle probabilité qui convient à sa seule phrase, si bien que les mots rares deviennent des « ramasseurs de déchets » qui s’alignent sur trop de mots. Moore a proposé un lissage des décomptes et une meilleure initialisation ; un prior bayésien sur les probabilités de traduction, appliqué par inférence variationnelle, est un autre remède [7].
Ce que nous avons envisagé et mesuré
Nous avons comparé notre aligneur à ses versions amputées, à des implémentations de référence de deux aligneurs publiés et à une méthode qui n’a aucun modèle d’alignement. Chaque méthode a reçu les mêmes paires de noms, les mêmes 5 % retenus et la même manière de transformer les alignements en dictionnaire (une paire de mots compte si elle est liée au moins deux fois ; chaque mot reçoit sa traduction la plus fréquente). La qualité est la F1 des radicaux de mots entre la traduction par dictionnaire d’un nom retenu, mot à mot, et son nom anglais, moyennée sur neuf langues (Tableau 1). Les écarts étant faibles, nous indiquons aussi dans combien des neuf langues un écart est net (intervalle de bootstrap à 95 % de la différence appariée ne contenant pas zéro).
| Méthode | Ce que c’est | F1 moyenne | Par rapport à la nôtre |
|---|---|---|---|
| Coefficient de Dice | pas de modèle d’alignement, chaque mot est lié au mot avec lequel il cooccurre le plus | 0.812 | moins bonne dans 7 cas sur 9 |
| IBM Model 1 [1], EM | probabilités de traduction des mots, sans ordre des mots | 0.817 | moins bonne dans 6 cas sur 9 |
| Model 1 with a Dirichlet prior [7] | bayésien variationnel sur les probabilités de traduction | 0.822 | moins bonne dans 4 cas sur 9 |
| Diagonal alignment prior, EM | modèle 2 dans la paramétrisation de fast_align [5], sans prior bayésien | 0.822 | moins bonne dans 6 cas sur 9 |
| Notre méthode | prior diagonal et prior de Dirichlet, deux sens, intersection | 0.825 | – |
| Notre méthode, grow-diag-final-and | la même, liens des deux sens combinés par l’heuristique standard | 0.828 | meilleure dans 5 cas sur 9, moins bonne dans 1 |
| fast_align [5] | l’implémentation des auteurs, intersection / grow-diag-final-and | 0.826 / 0.831 | 3 meilleures, 2 moins bonnes / 7 meilleures |
| eflomal [8] | HMM avec fertilité, bayésien, échantillonnage MCMC ; intersection / grow-diag-final-and | 0.825 / 0.828 | 2 meilleures, 2 moins bonnes / 7 meilleures |
| SimAlign [10] | plongements BERT multilingues, sans entraînement sur nos noms ; trois méthodes d’appariement (meilleure / itérative / intersection) | 0.824 / 0.822 / 0.812 | 2 meilleures, 2 moins bonnes / 1 meilleure, 3 moins bonnes / moins bonne dans 8 |
Tableau 1. Aligneurs comparés sur des noms retenus de notre base, neuf langues. La dernière colonne compte les langues où l’écart avec le nôtre est net. fast_align et eflomal sont les implémentations des auteurs.
Le seul coefficient de Dice n’est qu’à 0.013 derrière le nôtre, et SimAlign, qui n’a pas besoin d’entraînement sur nos noms, fait jeu égal avec le nôtre dans son meilleur réglage. Sur des noms courts et presque parallèles, le choix de l’aligneur compte peu, et l’essentiel de la qualité vient des noms eux-mêmes. Chacun des ingrédients du nôtre ajoute un peu, et le vrai fast_align avec la même intersection donne le même résultat (0.826 contre 0.825), ce que nous attendons d’une méthode de même conception. Combiner les deux sens avec l’heuristique standard grow-diag-final-and au lieu de l’intersection apporte à peu près autant que le choix du modèle : entre un quart et un demi-point de F1 pour les trois. C’est un petit gain, net dans la plupart des langues, et nous prévoyons de l’utiliser la prochaine fois que les dictionnaires seront reconstruits.
Réduire les mots à leurs radicaux Snowball avant l’alignement fait baisser la F1 (0.818, moins bonne dans 6 langues sur 9), et ne garder que les quatre premières lettres de chaque mot, que Östling et Tiedemann présentent comme une racinisation approximative utile pour la traduction automatique [8], la fait baisser bien davantage (0.743). La tâche explique la différence : Östling et Tiedemann mesurent des systèmes de traduction construits sur les alignements, tandis que nous cherchons des mots isolés d’un nom d’aliment dans un dictionnaire, où fusionner des formes de mots fusionne des aliments différents.
Nous n’avons pas lancé l’échantillonneur de Gibbs de Mermer et Saraçlar [9] (un modèle 1 entièrement bayésien), les modèles IBM 3–5, ni les requêtes structurées probabilistes de Darwish et Oard [4], qui gardent plusieurs traductions par mot. La dernière est une suite possible, puisque notre dictionnaire ne garde que le meilleur candidat.
Ce qu’est notre aligneur
Notre aligneur est notre propre implémentation d’un modèle IBM 2 dans la paramétrisation de fast_align [5] : la probabilité qu’un mot soit aligné sur une position donnée décroît avec la distance à la diagonale (dans le modèle 1, elle est uniforme), car les noms d’aliments tendent à garder leur ordre des mots d’une langue à l’autre. À cela s’ajoute, pour les probabilités de traduction des mots, un prior de Dirichlet parcimonieux avec inférence variationnelle [7], comme dans fast_align, qui empêche les mots rares d’absorber la probabilité. Les constantes fixes (la probabilité d’aligner un mot sur rien, la force du prior et la pente initiale de la diagonale) sont celles que Dyer et al. rapportent ; fast_align réestime aussi la pente pendant l’entraînement, ce que nous ne faisons pas. Il est entraîné dans les deux sens, et seuls les liens sur lesquels les deux sens s’accordent sont conservés (intersection), ce qui augmente la précision au prix d’un peu de rappel. Les mots sont alignés sous leurs formes exactes, sans racinisation : réduire les mots à leurs radicaux, ce qui est habituel pour les langues à riche flexion, a fait perdre en précision dans nos premiers essais, si bien que les mots composés et les mots avec trait d’union sont traités par des groupes de mots.
Le résultat est un dictionnaire en trois couches que le traducteur applique à partir de la plus longue correspondance de trois mots au maximum : les entrées de taxonomie, les groupes de mots alignés dans notre base et les mots isolés alignés dans notre base. Un mot absent du dictionnaire, comme une marque ou une faute de frappe, est transmis inchangé, car OFF le connaît souvent. Chaque langue est un fichier de quelques centaines de kilo-octets, contre environ 40 Mo par langue pour les modèles neuronaux. Il fonctionne hors ligne et chaque traduction peut être retrouvée dans une ligne du dictionnaire et corrigée.
Quelle est la qualité de la traduction
Nous mesurons le traducteur de deux manières. Sur 5 % des paires de noms retenues hors de l’entraînement, la traduction du nom étranger mot à mot, comparée au nom anglais par radicaux de mots, donne une F1 entre 0.78 et 0.90 selon les neuf langues. Sur les requêtes d’évaluation, pour lesquelles nous avons rédigé une traduction anglaise de référence avec chaque requête, la F1 des radicaux de mots vaut 0.94 pour l’allemand (88 requêtes sur 100 identiques en radicaux) et 0.96 pour l’ukrainien (89 sur 100).
Ces chiffres décrivent la traduction de requêtes courtes et courantes vers l’anglais. La qualité de la recherche elle-même est plus basse et se mesure à part (sections 3 et 9). Nous n’avons pas fait passer l’ancien traducteur neuronal sur les mêmes requêtes, donc nous n’affirmons pas que le dictionnaire est meilleur que ML Kit ; il est assez précis sur ces requêtes, petit, hors ligne et corrigeable.
7. Les taxonomies d’Open Food Facts : ce qu’elles apportent et ce qu’elles coûtent
OFF tient à jour des taxonomies publiques d’ingrédients et de catégories : des listes hiérarchiques dont chaque entrée a un nom anglais, et des noms et synonymes dans de nombreuses langues, rédigés par des bénévoles. Elles comptent des milliers d’entrées ayant un nom anglais, et elles sont attirantes pour trois raisons : les traductions sont faites par des personnes et dans le domaine alimentaire, elles contiennent des mots que nos propres noms n’utilisent jamais (ingrédients rares), et elles sont indépendantes de la traduction automatique qui a produit nos noms.
Les difficultés :
- Couverture inégale. La part des entrées ayant un nom dans une langue donnée va de 1.6 % (catégories ukrainiennes) à 84.6 % (catégories françaises), si bien que la taxonomie ne peut pas être la seule source. Nous l’appliquons d’abord là où une entrée existe, et laissons le dictionnaire de notre base combler le reste.
- Noms de type catégorie et nombreux synonymes. Une entrée a un seul nom anglais et de nombreux synonymes dans une langue. Chaque synonyme est apparié au nom anglais principal, et les très longs noms anglais sont ignorés.
- Des groupes de mots autant que des mots. Les noms de taxonomie sont des groupes de mots ; le traducteur cherche donc, à chaque position, le groupe le plus long avant les mots isolés.
- Bruit. Lorsque la taxonomie sert aussi de données d’entraînement, ses groupes de type catégorie entrent en concurrence avec les groupes idiomatiques de notre base. Il a fallu mesurer un poids pour les paires de taxonomie. Un poids trop grand faisait perdre en précision sur les mots courants, et la plage qui fonctionne est étroite.
Entraînement sur la taxonomie : un test qui ne pouvait pas voir l’effet
Notre premier test de l’ajout de paires de taxonomie à l’entraînement de l’alignement n’a rien montré. Nous l’avons mesuré sur des noms retenus de notre propre base et sur nos requêtes, et la qualité de la traduction n’a bougé que de quelques millièmes au plus. Nous avons failli conclure que la taxonomie n’était utile que comme simple consultation. Ce test ne pouvait pas voir l’effet : les deux ensembles contiennent des mots que notre base connaît déjà, alors que l’intérêt de la taxonomie est d’ajouter des mots qu’elle ne connaît pas.
Le test équitable retire un dixième des entrées de taxonomie de la couche de consultation et de l’entraînement, construit le dictionnaire avec et sans entraînement sur la taxonomie, puis traduit les noms des entrées retirées. Pour les langues à grande taxonomie, l’entraînement apporte deux à quatre points de F1 sur l’ensemble des noms retenus et quatre à cinq points sur les noms contenant un mot qui manque à notre base, sans perte sur les noms faits de mots connus (Figure 3). Pour les langues à petite taxonomie, comme l’ukrainien et le roumain, rien ne change. Nous avons inversé notre recommandation initiale, et les dictionnaires de l’application sont construits avec l’entraînement sur la taxonomie.
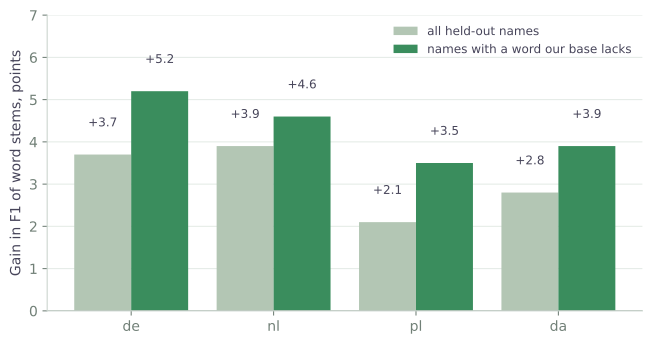
Où cela peut nuire. Les noms de taxonomie sont de type catégorie, et leurs synonymes peuvent supplanter un groupe idiomatique appris dans notre base (« home fries » pour un plat de pommes de terre frites). Sur les requêtes allemandes, cela a coûté environ un point de F1, et rien pour l’ukrainien, un prix que nous avons accepté pour le gain sur les mots rares.
8. Poids des quatre listes selon la langue
Dans l’équation (1), chaque liste a un poids. Nos premiers poids étaient les mêmes pour toutes les langues, réglés sur un seul ensemble de requêtes. Mais la qualité des listes varie d’une langue à l’autre. La liste native C d’OFF est riche en français ou en allemand et maigre en ukrainien, où la liste anglaise D porte davantage la charge. Donner à chaque langue ses propres poids est une idée naturelle, et la question est de savoir où les obtenir pour dix langues alors que nous avons des requêtes de test pour deux d’entre elles.
Nous avons envisagé deux mesures. La première était la part des entrées de taxonomie ayant un nom dans la langue. Elle est facile à calculer, mais elle mesure la qualité de la traduction du vocabulaire par les bénévoles, ce qui concerne le dictionnaire, et dit peu du nombre de produits portant un nom dans cette langue ; ses deux colonnes ne concordent même pas entre elles (italien : 75 % des ingrédients et 28 % des catégories). Nous ne l’avons pas utilisée. La seconde était le nombre de produits d’OFF par langue par rapport à l’anglais, disponible auprès du service de recherche (Figure 1). C’est un indicateur approximatif, car la langue principale d’un produit peut différer de la langue d’un champ de nom, mais il suit bien ce dont nous avons besoin : la probabilité que la liste native connaisse le produit. À partir de lui, nous dérivons un poids pour chaque langue par une formule lisse, qui donne davantage de poids à la liste native à mesure que la langue grandit, et nous fixons les valeurs dans une petite table de correspondance de l’application.
Sur les 200 requêtes allemandes et ukrainiennes jugées, l’effet est net pour l’allemand et absent pour l’ukrainien (Figure 4). Le MRR allemand augmente de .062 (intervalle de bootstrap à 95 % de la différence de +.030 à +.099) et la première place de 7 points, tandis que le top cinq gagne 3 points, ce qui reste dans la marge d’erreur. Le MRR ukrainien baisse de .002, car ses nouveaux poids sont proches des anciens poids communs. Le gain allemand se maintient dans les deux moitiés des requêtes, lorsqu’on les sépare en requêtes impaires et paires.
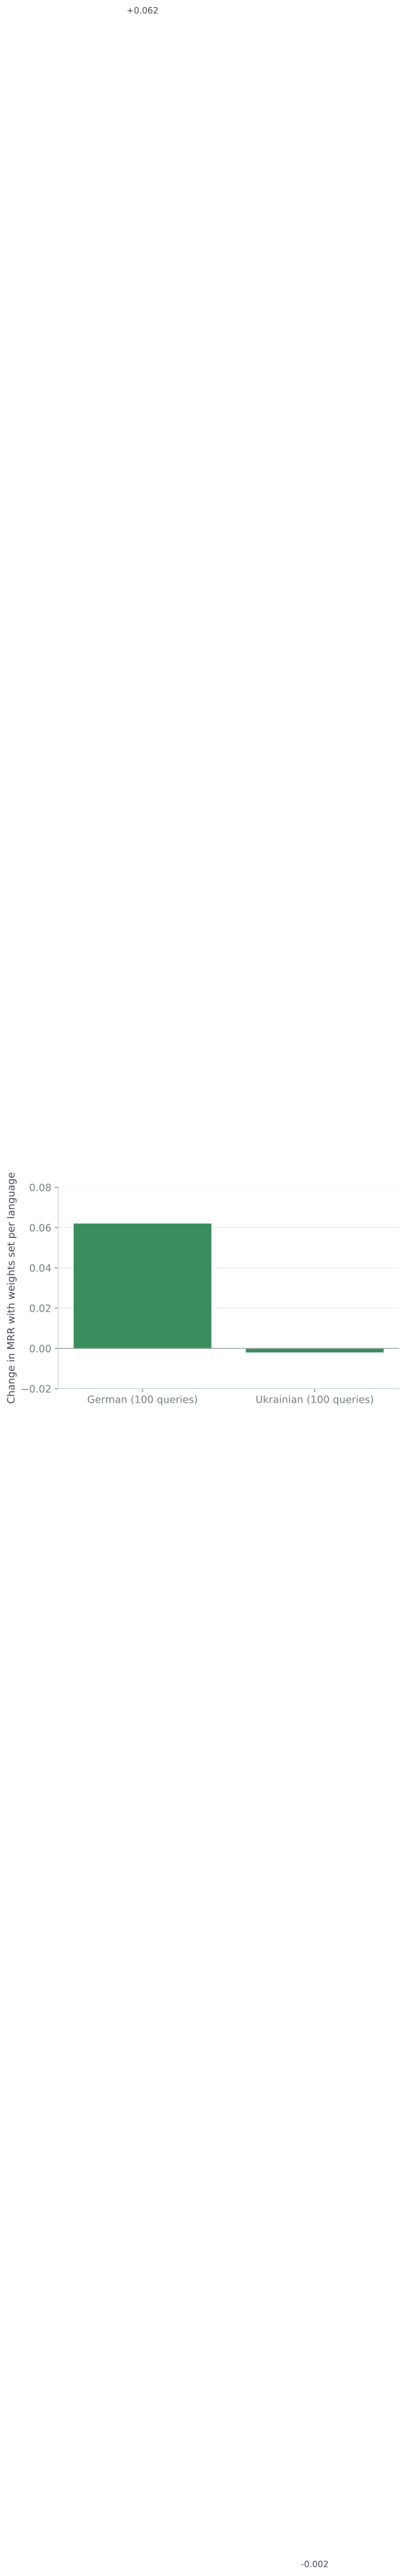
Les constantes de la formule ont été fixées sur ces mêmes requêtes, et les poids des autres langues découlent de la formule sans avoir été mesurés.
9. Fautes de frappe et formes de mots
Le dictionnaire connaît les formes exactes des mots. Un mot comportant une faute de frappe, ou une forme de cas qu’il n’a pas vue, passe inchangé et atteint les listes anglaises comme un mot qui n’y signifie rien. La recherche dans notre base locale corrige déjà les fautes grâce à un index SymSpell, un index de distance d’édition dans lequel le nombre de modifications permises croît avec la longueur du mot. La question ouverte concernait l’étape de traduction, nous avons donc mesuré ce que coûtent les fautes et ce qu’apporte une solution de repli.
Étape 1 : fautes et formes de mots, mot à mot
Nous avons reconstruit les dictionnaires des neuf langues à partir de nos noms et avons pris, parmi les noms retenus, les mots dont la traduction est connue. Chacun a reçu une modification aléatoire (une lettre supprimée, insérée, remplacée ou deux lettres voisines inversées). Une recherche dans la limite de distance d’édition permise a renvoyé la traduction du mot original pour 92.5 % des mots abîmés, contre 0.3 % pour la recherche exacte. Si la première lettre devait correspondre, comme peut l’exiger la recherche dans la base locale, le taux tombait à 77 %, car les fautes sur la première lettre sont alors manquées.
Pour les formes de mots, nous avons pris les mots retenus que le dictionnaire ne connaît pas, mais dont le radical Snowball est celui d’un mot connu (il s’agit surtout d’un autre cas ou d’un autre nombre d’un mot connu). La distance d’édition a donné une bonne traduction pour 55 % d’entre eux, un début de mot commun pour 63 %, et le même radical pour 69 %. Les terminaisons de cas changent souvent plusieurs lettres, ce que la limite d’édition ne permet pas. Les autres mots inconnus (marques, mots rares, nombres) constituent un risque : la distance d’édition répond pour un quart d’entre eux et a raison dans un tiers des réponses. Nous n’utilisons les radicaux qu’à la recherche ; pendant l’entraînement, ils ont fait baisser la qualité (section 6).
Étape 2 : la solution de repli sur les dictionnaires réels
Les dictionnaires de l’application omettent les mots qui s’écrivent de la même manière dans les deux langues, si bien qu’un tel mot est « inconnu » pour la solution de repli. Une solution de repli simple modifiait donc des mots qui étaient justes : pizza devenait nicoise, pils devenait mushroom, le nom de marque Krönung devenait curd. Sur les requêtes telles quelles, la F1 des mots de la traduction recule de 3 points. Trois garde-fous suppriment l’essentiel du mal : un mot qui est lui-même un mot anglais du dictionnaire est laissé tel quel, les mots très courts sont laissés tels quels, et la distance d’édition permise reste faible. L’ordre est le suivant : recherche exacte, même radical, puis une modification. Avec les garde-fous, la perte sur les requêtes telles quelles se réduit à 1.5 point, et sur les requêtes comportant une faute la F1 augmente de 30 points.
Étape 3 : la recherche complète
La F1 des mots compare une traduction à une référence, alors qu’une recherche possède d’autres listes qui peuvent absorber une mauvaise traduction. Nous avons donc fait tourner la recherche complète, comme à la section 3, sur 200 requêtes (100 allemandes et 100 ukrainiennes) : telles quelles, et avec une faute de frappe aléatoire dans un mot de chaque requête (195 requêtes modifiées). Chaque requête a été traduite de quatre façons : la traduction correcte (une borne supérieure), le dictionnaire tel qu’il était, le dictionnaire avec la solution de repli simple, et le dictionnaire avec les garde-fous. Les quatre listes classées ont été fusionnées avec les poids de l’application, et un modèle de langage a jugé à l’aveugle les résultats regroupés en tête.
| Traduction | Requêtes telles quelles premier / top cinq, points | Une faute par requête premier / top cinq, points |
|---|---|---|
| Correcte (borne supérieure) | +0.5 / −1.0 | +15.0 / +11.5 |
| Dictionnaire, solution de repli simple | +1.5 / +1.0 | +8.5 / +4.5 |
| Dictionnaire, solution de repli avec garde-fous | +2.0 / +0.5 | +7.5 / +4.0 |
Tableau 2. Variation par rapport au dictionnaire tel qu’il était, en points de la part des requêtes dont le bon produit figure en première place et dans le top cinq.
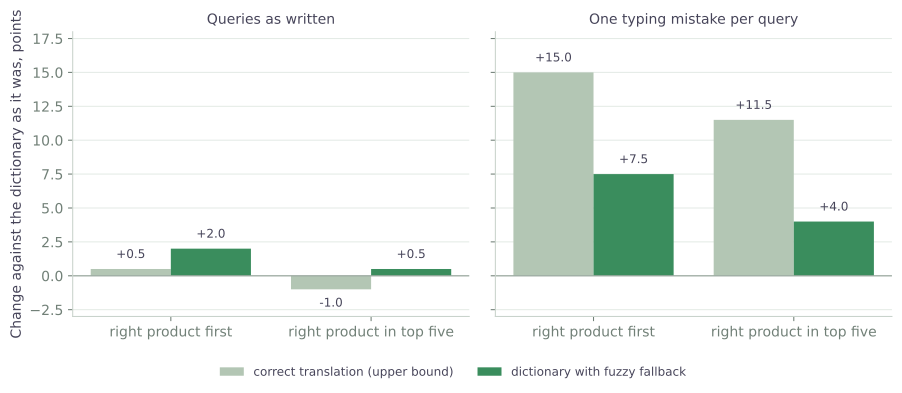
Sur les requêtes telles quelles, le dictionnaire vaut la traduction correcte (un demi-point de retard en première place, un point d’avance dans le top cinq), et la solution de repli ne modifie rien de détectable (4 requêtes gagnées et aucune perdue en première place, p = 0.13). Avec une faute de frappe, le dictionnaire tel qu’il était perd 15 points en première place ; la solution de repli avec garde-fous en récupère 7.5 (30 requêtes gagnées, 15 perdues, p = 0.04) et 4 des 11.5 points dans le top cinq (11 gagnées, 3 perdues, p = 0.06). La recherche qui n’utilise que la liste anglaise d’Open Food Facts gagne beaucoup plus, 22 points en première place, car elle n’a pas de liste native où se replier. La solution de repli simple et celle avec garde-fous ne peuvent pas être distinguées dans la recherche complète ; nous gardons celle avec garde-fous, car elle modifie moins de mots corrects. Le gain varie selon la langue : l’ukrainien gagne 15 points en première place, l’allemand aucun, et nous n’avons pas cherché à comprendre pourquoi.
Étape 4 : limites de la mesure
Les fautes sont synthétiques : une modification aléatoire dans presque chaque requête, bien plus souvent que les gens ne tapent réellement de travers, et sans les fautes de touches voisines d’un vrai clavier. Deux cents requêtes et un seul modèle comme juge donnent des valeurs de p voisines de 0.05 ; le résultat sur les fautes indique donc la direction, et la taille exacte exige de vraies requêtes. Le gain par vraie requête est le gain ci-dessus multiplié par la part des requêtes comportant une faute, que nous ne connaissons pas ; comme le coût sur les requêtes correctes est proche de zéro, même une petite part est rentable.
10. Ce qui n’a pas marché ou n’était pas nécessaire
- Retrait de la liste anglaise locale. Sur le second ensemble de requêtes, la version sans elle n’était pas meilleure que celle à quatre listes (le top cinq 2 points plus bas, MRR .015 plus bas, dans la marge d’erreur), nous avons donc gardé la structure.
- Racinisation avant l’alignement. Conseil courant pour les langues à riche flexion ; cela a fait perdre en précision dans nos essais. Les formes exactes et les groupes de mots ont mieux fonctionné.
- Un poids très élevé pour les paires de taxonomie. Il a un peu aidé sur les mots inconnus dans deux langues et perdu sur les mots connus. La plage utilisable est étroite, et nous restons dans cette plage.
- La couverture de la taxonomie comme poids d’une liste. Elle mesure la qualité de la traduction dans cette langue, alors que le nombre de produits qui existent dans cette langue est une quantité distincte.
- Un test qui ne pouvait pas voir l’effet. Notre premier test de taxonomie portait sur des mots que la base connaissait déjà et faisait paraître la taxonomie inutile. La leçon est de se demander ce qu’un test peut voir avant de faire confiance à un résultat nul.
Comment nous utilisons cela dans MuscleTiger
La recherche d’aliments de MuscleTiger fonctionne comme décrit : votre requête va vers notre propre base et vers Open Food Facts, dans votre langue et en anglais, la requête est traduite par un dictionnaire qui vit sur votre téléphone, et les quatre classements sont fusionnés avec des poids qui dépendent de votre langue. Les résultats sont affichés dans la langue de l’interface de l’application, et les produits vendus dans votre pays sont classés avant les autres. Le dictionnaire fonctionne sans réseau : une requête à la salle de sport, sans réseau, trouve donc quand même des aliments de notre base locale.
Conclusions
- La recherche trouve l’aliment recherché pour 92 % des requêtes. Dans un test de la recherche complète en neuf langues, il figure parmi les dix premiers résultats pour 90 % et en première position pour 67 % ; les produits simples sont trouvés un peu plus souvent que les plats.
- La traduction vers l’anglais est ce qui compte. Avec des traductions correctes, l’ajout de la liste anglaise a augmenté de 61 points la part des requêtes ukrainiennes dont le bon produit figure dans le top cinq, par rapport à Open Food Facts en ukrainien seul ; les autres langues ont peu changé et, au-delà de quatre, ont fait baisser le top cinq.
- Pour les requêtes d’aliments, un petit dictionnaire peut faire le travail du traducteur. L’alignement de mots sur nos propres noms parallèles donne un fichier de quelques centaines de kilo-octets par langue, hors ligne, et reproduit nos traductions de référence de requêtes courtes avec une F1 des radicaux de mots de 0.94 à 0.96. C’est la précision de la traduction de requêtes simples ; la précision de la recherche est mesurée à part et elle est plus basse.
- Les taxonomies publiques aident le plus là où nos propres données sont muettes. L’entraînement du dictionnaire sur elles a amélioré la traduction des termes rares retenus de deux à cinq points dans les langues à grande taxonomie, avec un petit coût sur les termes courants.
- Le poids de chaque liste peut dépendre de la taille de la langue dans OFF. Pour l’allemand, le changement a augmenté le MRR de .062 sur nos requêtes ; pour l’ukrainien, rien n’a changé.
- Une solution de repli pour les fautes de frappe est rentable. Avec une faute de frappe, la première place perd 15 points lorsque le traducteur ne connaît que les formes exactes, et une solution de repli avec garde-fous (même radical, puis une petite distance d’édition) en récupère la moitié ; pour les requêtes telles quelles, elle ne coûte rien de mesurable.
- Le rapprochement des mots a compté plus que les langues. La pondération des mots selon leur rareté, la racinisation et un seul format des nombres ont donné le plus grand gain de l’étude.
Limites. Les requêtes ont été rédigées par nous et jugées par un modèle de langage, si bien que les marges sont larges (environ points sur 200 requêtes). Les chiffres valent pour l’allemand et l’ukrainien ; les poids des autres langues sont extrapolés. Nous n’avons pas comparé à la traduction neuronale ni à d’autres applications. La prochaine étape est une vérification sur de vraies requêtes d’utilisateurs.
Données et licences
Les données produits et les taxonomies proviennent d’Open Food Facts, mises à disposition sous la licence Open Database Licence (ODbL) ; les dictionnaires décrits ici sont en partie dérivés des taxonomies d’OFF et portent la même attribution. Notre base locale est construite à partir de tables nationales ouvertes de composition des aliments publiées par des autorités publiques ; leurs sources et licences sont indiquées dans l’application. Nous remercions les contributeurs d’Open Food Facts et les responsables des tables nationales.
Sources
- Brown PF, Della Pietra SA, Della Pietra VJ, Mercer RL. The mathematics of statistical machine translation: parameter estimation. Computational Linguistics 1993;19(2):263–311. ACL Anthology
- Moore RC. Improving IBM word-alignment Model 1. Proceedings of ACL 2004:518–525. ACL Anthology
- Cormack GV, Clarke CLA, Büttcher S. Reciprocal rank fusion outperforms Condorcet and individual rank learning methods. Proceedings of SIGIR 2009. doi:10.1145/1571941.1572114
- Darwish K, Oard DW. Probabilistic structured query methods. Proceedings of SIGIR 2003.
- Dyer C, Chahuneau V, Smith NA. A simple, fast, and effective reparameterization of IBM Model 2. Proceedings of NAACL-HLT 2013:644–648. ACL Anthology
- Open Food Facts: taxonomies of ingredients and categories and product data, world.openfoodfacts.org, under the Open Database Licence (ODbL).
- Riley D, Gildea D. Improving the IBM alignment models using variational Bayes. Proceedings of ACL (short papers) 2012:306–310. ACL Anthology
- Östling R, Tiedemann J. Efficient word alignment with Markov chain Monte Carlo. The Prague Bulletin of Mathematical Linguistics 2016;106:125–146.
- Mermer C, Saraçlar M. Bayesian word alignment for statistical machine translation. Proceedings of ACL (short papers) 2011:182–187. ACL Anthology
- Jalili Sabet M, Dufter P, Yvon F, Schütze H. SimAlign: high quality word alignments without parallel training data using static and contextualized embeddings. Findings of EMNLP 2020.