MuscleTiger forskningsnoter · Nr. 5
Fødevaresøgning på ethvert sprog: oversættelse af forespørgsler, sammenlægning af databaser og hvad vi målte
Du skriver “Spiegelei mit Speck” eller “борщ з м’ясом” ind i en kostdagbog og forventer at se et produkt med kalorier og makronæringsstoffer. De største åbne fødevaredatabaser er for det meste skrevet på engelsk og fransk, mens folk søger på deres eget sprog, med mærkenavne, endelser og tastefejl. Denne note beskriver, hvordan vi byggede fødevaresøgningen i MuscleTiger, hvad vi prøvede, hvad der viste sig at være unødvendigt, og hvad vi målte.
Kort fortalt
Vores fødevaresøgning finder den fødevare, der blev søgt efter, for 92% af forespørgslerne på ni sprog (afsnit 3). Vi søger i fire lister på én gang (vores egen fødevarebase på engelsk og på brugerens sprog, og Open Food Facts på brugerens sprog og på engelsk) og slår rangeringerne sammen med reciprok rangfusion. En forespørgsel på et andet sprog oversættes først til engelsk. Vi brugte først en neural oversætter på enheden og erstattede den derefter med en lille ordbog, lært fra vores egne parallelle fødevarenavne med en ordjusterer af IBM Model 2-familien med en bayesiansk prior, og fra Open Food Facts-taksonomierne. På vores testforespørgsler gengiver ordbogen den engelske referenceoversættelse med en ordstamme-F1 på 0.94 (tysk) og 0.96 (ukrainsk). Dette måler oversættelsen af korte, enkle forespørgsler. Med korrekte oversættelser øger den engelske liste andelen af ukrainske forespørgsler med det rigtige produkt i top fem med 61 point, og yderligere sprog bidrager lidt. Vægtene for de fire lister, som afhænger af hvor stort sproget er i Open Food Facts, forbedrede det tyske og efterlod det ukrainske uændret. En reserveløsning for skrivefejl i oversætteren genvinder omkring halvdelen af de 15 point, en fejl koster.
Vi forklarer fremgangsmåden og de metodefamilier, vi overvejede.
1. Problemet: en forespørgsel på ét sprog, data på flere
En fødevaresøgning skal gøre tre ting godt på samme tid. Den skal forstå en kort og rodet forespørgsel (“chicken breast 200g”, “coca cola zero”, “мигдальне молоко”). Den skal finde et produkt, der har fuldstændige og plausible næringsværdier. Og den skal fungere på personens eget sprog, på en telefon, hurtigt og helst offline.
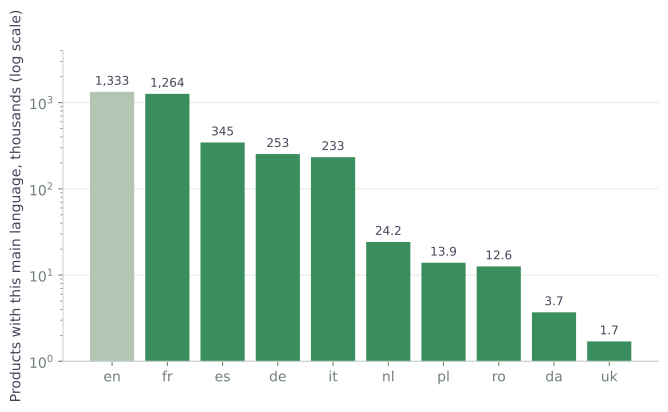
De data, vi kan bruge, er ujævne. Open Food Facts (OFF) [6], den åbne database over pakkede produkter, rummer millioner af produkter, men et produkts sprog følger det land, hvor det sælges, og bidragydernes vaner. Når man tæller produkter efter deres hovedsprog (OFF, 15. november 2026), fører engelsk og fransk med omkring 1.3 million produkter hver, spansk, tysk og italiensk følger med 230 til 350 tusind, og de mindre sprog, vi understøtter, har mellem 1.7 og 25 tusind (figur 1). En forespørgsel på ukrainsk kan derfor kun besvares på ukrainsk af meget få produkter, mens en forespørgsel på fransk møder en database, der allerede i udgangspunktet er mest fransk.
Vores egen base
Den anden kilde er vores egen base af fødevarer med fuldstændig energi og makronæringsstoffer. Den er en sammenlægning af flere nationale næringsstoftabeller, valgt fordi de er åbne, målt i laboratorier og komplette i makronæringsstoffer. Mange af dens fødevarer har husholdningsportioner som “1 slice”. En fødevare springes over, når en med samme navn allerede findes i basen, og nye rækker tilføjes altid efter de gamle, så et produkts nummer og dets oversættelser aldrig ændrer sig, når en tabel tilføjes.
Da vi senere tilføjede tre tabeller mere, steg andelen af testforespørgsler med det rigtige produkt i top fem med 3 point og på førstepladsen med 2 point; ingen af ændringerne er signifikante. Gevinsten kom hovedsageligt fra almindelige retter, som de nye tabeller beskriver på klart engelsk, såsom lasagne, cappuccino eller græsk yoghurt. Vi udelod én kandidattabel, fordi dens licens har en share-alike-betingelse, som kunne gælde for vores sammenlagte base.
Tabellerne er skrevet på engelsk eller på deres lands sprog, så navnene på de andre sprog måtte laves. De engelske navne er de oprindelige; navnene på de andre sprog blev skabt ved maskinoversættelse og delvist senere rettet af sprogmodel-agenter med automatiske kontroller (en validator afviser et svar, der ændrer tal, enheder eller navnets struktur). Tal i navne bruger et decimalpunktum på alle sprog, både i basen og i forespørgslen, så en forespørgsel med en fedtprocent kan foretrække produktet med netop den procent.
2. Fire lister og én rangering
Designet, vi bruger, er enkelt at beskrive. Hver forespørgsel søges i fire steder:
- A: vores lokale base, med forespørgslen oversat til engelsk;
- B: vores lokale base, med forespørgslen som skrevet på brugerens sprog;
- C: Open Food Facts, søgt på brugerens sprog;
- D: Open Food Facts, søgt med den engelske oversættelse.
Hver liste returnerer sin egen rangering, og rangeringerne slås sammen med reciprok rangfusion (RRF) [3]. Et produkt, der optræder højt på flere lister, slår et produkt, der kun er først på én liste:
hvor er produktets placering på listen , er listens vægt, og er en lille konstant, der forhindrer første plads i at dominere. Metoden kræver ingen scorer fra listerne, kun deres rækkefølge, hvilket betyder noget, fordi listerne kommer fra forskellige systemer med ikke-sammenlignelige scorer. Vi valgte den netop af den grund; Cormack et al. rapporterer, at den er konkurrencedygtig med mere avancerede rank-learning-metoder i deres eksperimenter [3].
RRF er en publiceret metode, og vores bidrag er målingen: hvilke lister der skal med, hvordan forespørgslen oversættes, og hvor meget hver liste skal stoles på i hvert sprog.
3. Sådan målte vi
Protokollen:
- Vi skrev forespørgselssæt af flere typer: mærke plus produkt, ret, almindelig fødevare, drik, og uformelle eller stavede forkert. Ét sæt har 959 forespørgsler, hvoraf 200 blev bedømt i detaljer; et andet sæt har 200 forespørgsler, 100 på tysk og 100 på ukrainsk, med 20 af hver type. Et særskilt sæt med retter fra udenlandske køkkener (for eksempel en japansk ret spurgt på tysk) tester, om forespørgslens sprog skal følge retten.
- For hver forespørgsel samlede vi de øverste resultater fra hver konfiguration, og en sprogmodel bedømte hver kandidat som relevant eller ikke relevant. Den så forespørgslen og den engelske oversættelse, men ikke hvilken konfiguration der havde returneret kandidaten. Bedømmeren kunne derfor ikke favorisere en metode.
- Vi rapporterer top-1 (det rigtige produkt er først), top-5 (det er blandt de første fem) og MRR, gennemsnittet af for det første relevante resultat. Til sammenligninger mellem konfigurationer parrer vi resultaterne efter forespørgsel og bruger fortegnstests og bootstrap-intervaller.
Nøjagtigheden af hele søgningen
Tallet i resuméet kommer fra en test af søgningen præcis, som den kører i appen. Vi skrev ti forespørgsler på hvert af de ni sprog, appen understøtter ud over engelsk, to af hver type, 90 forespørgsler i alt. Hver forespørgsel gik gennem de samme trin som på en telefon: oversættelse med ordbogen, vores database på engelsk og på forespørgslens sprog, Open Food Facts på begge sprog, hvor produkter, der sælges i landet for det sprog, rykkes frem, og fusionen med appens vægte. Vi læste hele den flettede liste for hver forespørgsel, i gennemsnit omkring tres resultater, og markerede i hånden det første resultat, som en bruger ville acceptere som den fødevare, de mente, efter de samme regler som den blinde bedømmer.
| Den søgte fødevare findes | Alle forespørgsler (90) | Enkelte produkter (65) | Retter (25) |
|---|---|---|---|
| et sted på listen | 92.2% | 93.8% | 88.0% |
| blandt de første ti | 90.0% | 90.8% | 88.0% |
| blandt de første fem | 85.6% | 86.2% | 84.0% |
| på førstepladsen | 66.7% | 67.7% | 64.0% |
Nøjagtigheden af hele søgningen. Ti forespørgsler på hvert af ni sprog, søgt som i appen. Enkelte produkter er fødevarer, emballerede produkter og drikkevarer; retter omfatter også sammensatte måltider som en ostemad eller havregryn med mælk.
Den søgte fødevare står et sted på listen for 92% af forespørgslerne, blandt de første ti resultater for 90%, blandt de første fem for 86% og på førstepladsen for 67%. Enkelte produkter findes lidt oftere end retter (94% mod 88% et sted på listen). Fejlene er mest mærkevarer, som ingen liste indeholder, og snacks af flere fødevarer, hvor listerne tilbyder ingredienserne men ikke selve snacken. Ti forespørgsler pr. sprog er et lille grundlag: én forespørgsel flytter resultatet for et sprog ti point, så tallene beskriver søgningen som helhed og siger lidt om det enkelte sprog. De følgende afsnit skiller søgningen ad og måler hvert trin på større sæt af forespørgsler på tysk og ukrainsk.
4. Hvad en korrekt oversættelse gør for søgningen
Før vi beskriver vores forsøg på at bygge en god oversætter, målte vi, hvad en god oversættelse er værd. Vi skrev 100 fødevareforespørgsler på ukrainsk (20 hver af almindelige fødevarer, retter, drikke, mærker og uformelle forespørgsler) og oversatte hver i hånden til de andre ni sprog, så oversættelsen er korrekt pr. konstruktion. For hvert sprog søgte vi i Open Food Facts med forespørgslen på det sprog og slog listerne sammen med reciprok rangfusion (ligning 1, lige vægte). Den første konfiguration er kun ukrainsk, den anden tilføjer engelsk, og derefter tilføjede vi fransk, spansk, tysk, italiensk, hollandsk, polsk, rumænsk og dansk, i rækkefølge efter hvor mange produkter sproget har i OFF (figur 2). Relevans blev bedømt blindt af en sprogmodel efter reglerne i afsnit 3, over de samlede top fem for hver konfiguration.
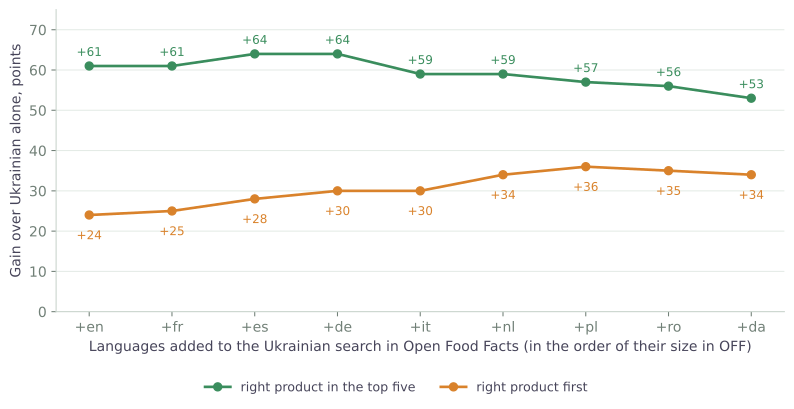
Det første trin er langt det største. Søgning i OFF kun på ukrainsk finder ofte intet: OFF har få ukrainsksprogede produkter (figur 1), og for 47 af de 100 forespørgsler var den ukrainske liste tom. Tilføjelse af den engelske oversættelse øger andelen af forespørgsler med det rigtige produkt i top fem med 61 point og på førstepladsen med 24 point, med 61 forespørgsler vundet og ingen tabt.
De næste sprog ændrer lidt. Fransk lader top fem være uændret (5 forespørgsler vundet, 5 tabt). Spansk og tysk lægger 3 point mere til, inden for støjen. Derefter falder top fem med 11 point fra toppen med alle ti sprog, mens førstepladsen kravler op med yderligere 10 til 12 point. Faldet fra fire til ti sprog i top fem er signifikant på disse forespørgsler (2 vundet, 13 tabt, fortegnstest p = 0.007); stigningen i førstepladsen fra to til ti sprog er ikke (20 vundet, 10 tabt, p = 0.10). Mærkenavne opfører sig anderledes end almindelige fødevarer: med flere lister findes en mærkeforespørgsel oftere (15 point mere i top fem med spansk tilføjet end med engelsk alene), mens almindelige fødevarer findes sjældnere (25 point færre med ti sprog end med engelsk). Tyve forespørgsler pr. type er et lille grundlag, så disse opdelinger er vejledende.
En korrekt oversættelse til engelsk bærer effekten. Hvert yderligere sprog er endnu en forespørgsel til OFF og fortynder, efter de første få, rangeringen.
Retter fra et andet køkken
Skridtet til engelsk betyder mest, når retten kommer fra et andet køkken. Et særskilt sæt med 100 forespørgsler, ti på hvert af de ti sprog, nævnte en velkendt udenlandsk ret, sådan som en bruger ville skrive den: Borschtsch for en tysk bruger, paella, pierogi, tiramisu, stroopwafel, sarmale. Dette er et ældre eksperiment, og forespørgslerne blev oversat af den neurale oversætter, appen dengang brugte (afsnit 5). For de 90 ikke-engelske forespørgsler øgede oversættelse af forespørgslen til engelsk andelen med retten i top fem med 34 point i forhold til en søgning i Open Food Facts på brugerens eget sprog (47 forespørgsler vundet, ingen tabt, p < 0.001). At tilføje flere sprog efter engelsk ændrede intet i top fem, selv når vi på forhånd valgte sproget i det land, retten stammer fra.
Vores lokale base hjalp her: uden dens engelske liste faldt førstepladsen med 8 point på disse forespørgsler (7 tabt, ingen vundet, p = 0.016), fordi basen kender paella, ratatouille eller lasagne og rangerer dem først. For almindelige fødevarer viste den ingen sådan fordel, men at fjerne den gjorde heller ikke søgningen bedre (afsnit 10), så vi beholder den. De resterende fejl var retter, som ingen OFF-liste har under noget navn, såsom sarmale. Sættet har kun omkring tyve forskellige retter, så det beskriver velkendte retter og siger lidt om sjældne.
Matchning betød mere end sprogene
Den enkeltstående største forbedring i hele studiet kom fra at matche ord i den lokale base, uden oversættelse involveret. Den lokale base søges med sin egen matchning, og funktionsord, kasusendelser og decimalkommaer ødelagde den: “soup with mushrooms” på ukrainsk gav intet resultat, fordi matchningen krævede, at hvert ord i forespørgslen blev fundet, som det var skrevet. Ved at vægte forespørgselsord efter hvor sjældne de er (IDF), en Snowball-stemmer for de sprog, der har en, og ét talformat forbedrede vi top-5 på standardsættet med omkring 9% siden studiets start (fortegnstest p = 0.008), og på forespørgsler med præpositioner og ordformer med omkring 12%.
5. Hvorfor vi udskiftede oversætteren
Vi fjernede ML Kit, fordi den oversætter fødevarenavne dårligt. Det er en generel oversætter bygget til sætninger, og et fødevarenavn er få ord uden kontekst: et mærke, en tilstand for produktet, en ret opkaldt efter et sted. Vores base blev først oversat med den, og disse er rigtige poster (de ukrainske og franske oversættelser, med en forklaring for læsere, der ikke taler sproget):
| Engelsk navn | ML Kit-output | Hvad gik galt |
|---|---|---|
| plain, refrigerated | рівнина, холодильна (ukrainsk) | “plain” betyder her usødet, som i plain yoghurt, og blev oversat som “plain” i betydningen landskab; “refrigerated” blev til et adjektiv, der betyder “af et køleskab” |
| boneless | безкімнатний (ukrainsk) | betyder “uden værelser”; den tilsigtede betydning er “uden ben” |
| Pad Thai | Подушка тайська (ukrainsk) | navnet på retten blev læst som ord: “Thai cushion” |
| Rice flour, brown | Рисова борошно, коричневий (ukrainsk) | adjektiverne stemmer ikke overens med substantivet “flour”, hvilket er ugrammatisk på ukrainsk |
| Meringue with chocolate; Ham salad spread | efterladt delvist eller helt uoversat (ukrainsk) | de engelske ord bliver i navnet |
| bun | chignon (fransk) | en hårknold (frisuren), hvor brødbollen var ment |
| sauerkraut | chouchoune (fransk) | et andet ord; det franske ord for sauerkraut er choucroute |
Den samme svaghed rammer forespørgsler, hvor et forkert ord betyder et manglende produkt, og den kan ikke rettes lokalt: man kan ikke rette ét ord i en neural model. Der var to mindre grunde: modellerne fylder omkring 40 MB pr. sprog, og SDK'en er en tredjepartskomponent.
De data, vi ejer, peger på et bedre værktøj. Vores base har par af et engelsk navn og dets navn på hvert sprog, en parallel korpus i netop det domæne, vi har brug for. En ordbog kan læres ud fra sådan et korpus.
6. En ordbog lært ved ordjustering
At lære en ordbog ud fra parallel tekst er det gamle problem med ordjustering: at afgøre hvilket ord i den ene sætning der svarer til hvilket ord i den anden. Den klassiske familie er IBM-modellerne fra statistisk maskinoversættelse [1]. Model 1, den simpleste og vores udgangspunkt, behandler et navn på ét sprog som genereret fra ordene i det andet, uden hensyn til rækkefølge. For et engelsk navn og et navn på et andet sprog (med et tomt ord tilføjet) er sandsynligheden for parret
og tabellen over ordoversættelsessandsynligheder , ordbogen, estimeres ved forventnings-maksimering: i hver runde får hvert ordpar i et navnepar en andel af tællingen proportional med den aktuelle sandsynlighed, og andelene normaliseres til nye sandsynligheder. For et kort fødevarenavn er dette en god pasform, fordi der er lidt ordrækkefølge at modellere. Dens kendte svaghed blev beskrevet af Moore [2]: et sjældent ord kan få enhver sandsynlighed, der passer til dets ene sætning, så sjældne ord bliver til “skraldeindsamlere”, der justeres til for mange ord. Moore foreslog at udjævne tællingerne og en bedre initialisering; en bayesiansk prior på oversættelsessandsynlighederne, anvendt ved variationel inferens, er et andet middel [7].
Hvad vi overvejede og målte
Vi sammenlignede vores aligner med dens ablationer, med referenceimplementeringer af to publicerede aligners og med en metode, der slet ingen justeringsmodel har. Hver metode fik de samme navnepar, de samme 5% holdout og den samme måde at gøre justeringer til en ordbog (et ordpar tæller, hvis det er forbundet mindst to gange; hvert ord får sin hyppigste oversættelse). Kvalitet er F1 af ordstammer mellem holdout-navnets ordbogsoversættelse, ord for ord, og dets engelske navn, gennemsnittet over ni sprog (tabel 1). Forskellene er små, så vi rapporterer også i hvor mange af de ni sprog en forskel er tydelig (95% bootstrap-interval af den parrede forskel udelukker nul).
| Metode | Hvad det er | Gennemsnitlig F1 | Mod vores |
|---|---|---|---|
| Dice-koefficient | ingen justeringsmodel, hvert ord forbindes med det ord, det oftest optræder sammen med | 0.812 | dårligere i 7 af 9 |
| IBM Model 1 [1], EM | ordoversættelsessandsynligheder, ingen ordrækkefølge | 0.817 | dårligere i 6 af 9 |
| Model 1 med en Dirichlet-prior [7] | variationel Bayes på oversættelsessandsynlighederne | 0.822 | dårligere i 4 af 9 |
| Diagonal justeringsprior, EM | Model 2 i fast_align-parameteriseringen [5], uden den bayesianske prior | 0.822 | dårligere i 6 af 9 |
| Vores | diagonal prior og Dirichlet-prior, to retninger, fællesmængde | 0.825 | – |
| Vores, grow-diag-final-and | den samme, forbindelser i begge retninger kombineret med den standardheuristik | 0.828 | bedre i 5 af 9, dårligere i 1 |
| fast_align [5] | forfatternes implementering, fællesmængde / grow-diag-final-and | 0.826 / 0.831 | 3 bedre, 2 dårligere / 7 bedre |
| eflomal [8] | HMM med fertilitet, bayesiansk, MCMC-sampling; fællesmængde / grow-diag-final-and | 0.825 / 0.828 | 2 bedre, 2 dårligere / 7 bedre |
| SimAlign [10] | flersproget BERT-indlejringer, ingen træning på vores navne; tre matchningsmetoder (bedste / iterativ / fællesmængde) | 0.824 / 0.822 / 0.812 | 2 bedre, 2 dårligere / 1 bedre, 3 dårligere / dårligere i 8 |
Tabel 1. Justeringsværktøjer sammenlignet på holdout-navne fra vores base, ni sprog. Den sidste kolonne tæller de sprog, hvor forskellen til vores er tydelig. fast_align og eflomal er forfatternes implementeringer.
Den bare Dice-koefficient ligger kun 0.013 bagefter vores, og SimAlign, som ikke kræver træning på vores navne, er på niveau med vores i sin bedste indstilling. På korte, næsten parallelle navne betyder valget af aligner lidt, og det meste af kvaliteten kommer fra selve navnene. Hver af vores ingredienser tilføjer lidt, og den rigtige fast_align med samme fællesmængde giver samme resultat (0.826 mod 0.825), hvilket vi forventer fra en metode med samme design. At kombinere de to retninger med den standardiserede grow-diag-final-and-heuristik i stedet for fællesmængden hjælper omtrent lige så meget som valget af model: mellem en fjerdedel og en halv F1-point for alle tre. Det er en lille gevinst, der er tydelig i de fleste sprog, og vi planlægger at bruge den, næste gang ordbøgerne genopbygges.
At reducere ord til Snowball-stammer før justering sænker F1 (0.818, dårligere i 6 af 9 sprog), og at beholde kun de første fire bogstaver i hvert ord, som Östling og Tiedemann rapporterer som en nyttig tilnærmet stammeføring til maskinoversættelse [8], sænker den langt mere (0.743). Opgaven forklarer forskellen: Östling og Tiedemann måler oversættelsessystemer bygget på justeringerne, mens vi slår enkelte ord i et fødevarenavn op i en ordbog, og her betyder sammenlægning af ordformer, at forskellige fødevarer bliver til én.
Vi kørte ikke Gibbs-samplet fra Mermer og Saraçlar [9] (en fuldt bayesiansk Model 1), IBM-modellerne 3–5, eller de probabilistiske strukturerede forespørgsler fra Darwish og Oard [4], som beholder flere oversættelser pr. ord. Den sidste er et muligt næste skridt, da vores ordbog kun beholder den bedste kandidat.
Hvad vores aligner er
Vores aligner er vores egen implementering af en IBM Model 2 i fast_align-parameteriseringen [5]: sandsynligheden for at et ord justeres til en given position falder med afstanden fra diagonalen (i Model 1 er den ensartet), fordi fødevarenavne har en tendens til at bevare deres ordrækkefølge mellem sprog. Oven på det får oversættelsessandsynlighederne for ord en sparsom Dirichlet-prior med variationel inferens [7], som i fast_align, hvilket forhindrer sjældne ord i at tage sandsynlighed til sig. De faste konstanter (sandsynligheden for at justere et ord til ingenting, styrken af prioren og den indledende stejlhed af diagonalen) er dem, som Dyer et al. rapporterer; fast_align estimerer også stejlheden igen under træningen, og det gør vi ikke. Den trænes i begge retninger, og kun de forbindelser, som begge retninger er enige om, beholdes (fællesmængde), hvilket hæver præcisionen på bekostning af recall. Ord justeres i deres nøjagtige former uden stammeføring: at reducere ord til stammer, hvilket er almindeligt for sprog med rige ordendelser, tabte præcision i vores første forsøg, så sammensatte ord og ord med bindestreg håndteres gennem fraser.
Resultatet er en ordbog i tre lag, som oversætteren anvender fra det længste match på op til tre ord: taksonomiposter, fraser justeret i vores base og enkeltord justeret i vores base. Et ord, der ikke er i ordbogen, såsom et mærke eller en tastefejl, sendes uændret videre, fordi OFF ofte kender det. Hvert sprog er en fil på nogle hundrede kilobyte, mod omkring 40 MB pr. sprog for de neurale modeller. Den virker offline, og hver oversættelse kan spores til en linje i ordbogen og rettes.
Hvor god er oversættelsen
Vi måler oversætteren på to måder. På 5% af navnepar holdt ude fra træningen, oversættes det udenlandske navn ord for ord, og resultatet sammenlignes med det engelske navn via ordstammer; det giver en F1 mellem 0.78 og 0.90 på tværs af de ni sprog. På evalueringsforespørgslerne, hvor vi skrev en engelsk referenceoversættelse sammen med hver forespørgsel, er F1 af ordstammer 0.94 for tysk (88 af 100 forespørgsler identiske i stammer) og 0.96 for ukrainsk (89 af 100).
Disse tal beskriver oversættelsen af korte, almindelige forespørgsler til engelsk. Søgningens egen kvalitet er lavere og måles separat (afsnit 3 og 9). Vi kørte ikke den gamle neurale oversætter på de samme forespørgsler, så vi påstår ikke, at ordbogen er bedre end ML Kit; den er nøjagtig nok på disse forespørgsler, lille, offline og kan rettes.
7. Open Food Facts-taksonomierne: hvad de giver, og hvad de koster
OFF vedligeholder offentlige taksonomier over ingredienser og kategorier: hierarkiske lister, hvor hver post har et engelsk navn og navne og synonymer på mange sprog, skrevet af frivillige. De rummer tusindvis af poster med et engelsk navn, og de er attraktive af tre grunde: oversættelserne er lavet af mennesker og i fødevaredomænet, de indeholder ord, som vores egne navne aldrig bruger (sjældne ingredienser), og de er uafhængige af den maskinoversættelse, der lavede vores navne.
Vanskelighederne:
- Ujævn dækning. Andelen af poster med et navn på et givet sprog spænder fra 1.6% (ukrainske kategorier) til 84.6% (franske kategorier), så taksonomien ikke kan være den eneste kilde. Vi anvender den først, hvor en post findes, og lader ordbogen fra vores base udfylde resten.
- Kategorilignende navne og mange synonymer. En post har ét engelsk navn og mange synonymer på et sprog. Hvert synonym parres med det engelske hovednavn, og meget lange engelske navne springes over.
- Fraser og ikke kun ord. Taksonominavne er fraser, så oversætteren matcher den længste frase på hver position, før enkeltord.
- Støj. Når taksonomien også bruges som træningsdata, konkurrerer dens kategorilignende fraser med de idiomatiske fraser i vores base. En vægt for taksonomiparrene måtte måles. For høj vægt kostede præcision på almindelige ord, og det interval, der virker, er smalt.
Træning på taksonomien: en test, der ikke kunne se effekten
Vores første test af at tilføje taksonomiparrene til justeringstræningen viste intet. Vi målte på holdout-navne fra vores egen base og på vores forespørgsler, og oversættelseskvaliteten bevægede sig højst et par tusindedele. Vi konkluderede næsten, at taksonomien kun var nyttig som opslag. Den test kunne ikke se effekten: begge sæt indeholder ord, som vores base allerede kender, mens pointen med taksonomien er at tilføje ord, den ikke har.
Den rimelige test fjerner en tiendedel af taksonomiposterne fra opslagslaget og fra træningen, bygger ordbogen med og uden taksonomitræning og oversætter navnene på de fjernede poster. For sprogene med en stor taksonomi giver træningen to til fire point F1 på alle holdout-navne og fire til fem point på navne med et ord, som vores base mangler, uden tab på navne bestående af kendte ord (figur 3). For sprogene med en lille taksonomi, såsom ukrainsk og rumænsk, ændrer intet sig. Vi tog vores tidlige anbefaling tilbage, og ordbøgerne i appen bygges med taksonomitræning.
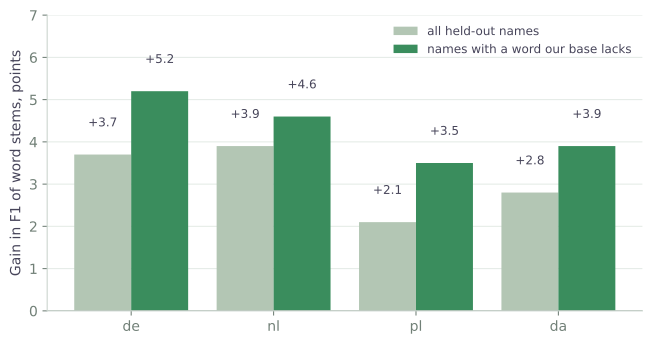
Hvor den kan skade. Taksonominavne er kategorilignende, og deres synonymer kan fortrænge en idiomatisk frase, lært fra vores base (“home fries” for en stegt kartoffelret). På de tyske forespørgsler kostede det omkring et point F1 og intet for ukrainsk, en pris vi accepterede for gevinsten på sjældne ord.
8. Vægte for de fire lister efter sprog
I ligning (1) har hver liste en vægt. Vores første vægte var ens for alle sprog, indstillet på ét forespørgselssæt. Men listernes kvalitet varierer mellem sprog. Den indbyggede OFF-liste C er rig på fransk eller tysk og tynd på ukrainsk, hvor den engelske liste D bærer mere af læsset. Det er en naturlig idé at give hvert sprog sine egne vægte, og spørgsmålet er, hvor vi skal få dem fra for ti sprog, når vi har testforespørgsler for to.
Vi overvejede to mål. Det første var andelen af taksonomiposter, der har et navn på sproget. Det er let at beregne, men det måler, hvor godt frivillige har oversat ordforrådet, hvilket påvirker ordbogen, og siger lidt om, hvor mange produkter der har et navn på sproget; dets to kolonner er endda uenige med hinanden (italiensk: 75% af ingredienserne og 28% af kategorierne). Vi brugte det ikke. Det andet var antallet af OFF-produkter pr. sprog i forhold til engelsk, tilgængeligt fra søgetjenesten (figur 1). Det er en proxy, fordi et produkts hovedsprog kan afvige fra sproget i et navnefelt, og det følger stadig det, vi har brug for: hvor sandsynligt det er, at den indbyggede liste kender produktet. Ud fra det udleder vi en vægt for hvert sprog med en glat formel, der giver den indbyggede liste mere vægt, efterhånden som sproget vokser, og vi fastlægger værdierne i en lille opslagstabel i appen.
På de 200 bedømte tyske og ukrainske forespørgsler er effekten tydelig for tysk og fraværende for ukrainsk (figur 4). Tysk MRR stiger med .062 (95% bootstrap-interval af forskellen +.030 til +.099), og førstepladsen med 7 point, mens top fem stiger med 3 point, hvilket er inden for støjen. Ukrainsk MRR falder med .002, fordi de nye vægte ligger tæt på de gamle fælles vægte. Gevinsten for tysk holder i begge halvdele af forespørgslerne, når de deles i ulige og lige.
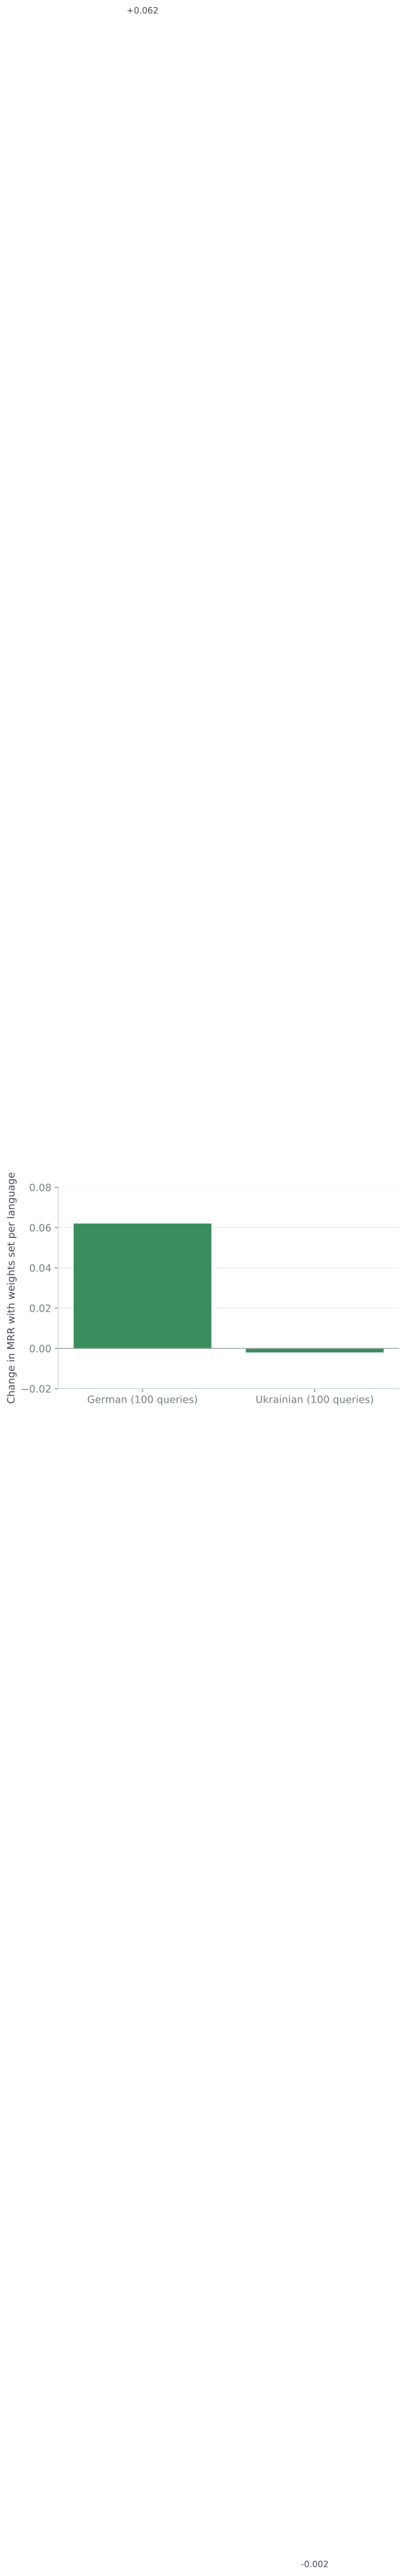
Formlens konstanter blev sat på netop disse forespørgsler, og vægtene for de andre sprog følger af formlen og er ikke blevet målt.
9. Skrivefejl og ordformer
Ordbogen kender de nøjagtige former af ord. Et ord med en skrivefejl, eller en kasusform den ikke har set, passerer uændret og når de engelske lister som et ord, der ikke betyder noget der. Søgningen i vores lokale base reparerer allerede fejl med et SymSpell-indeks, et indeks over redigeringsafstand, hvor antallet af tilladte rettelser vokser med ordets længde. Det åbne spørgsmål var oversættelsestrinnet, så vi målte, hvad fejlene koster, og hvad en reserveløsning giver.
Trin 1: fejl og ordformer, ord for ord
Vi genopbyggede ordbøgerne for de ni sprog ud fra vores navne og tog fra holdout-navnene de ord, der har en kendt oversættelse. Hvert fik én tilfældig rettelse (et bogstav slettet, indsat, erstattet eller to nabobogstaver byttet). Et opslag inden for den tilladte redigeringsafstand gav oversættelsen af det oprindelige ord for 92.5% af de beskadigede ord, mod 0.3% for det nøjagtige opslag. Hvis det første bogstav skulle matche, som søgningen i den lokale base kan kræve, faldt det til 77%, fordi fejl på første bogstav så overses.
For ordformer tog vi de holdout-ord, som ordbogen ikke kender, og hvis Snowball-stamme er lig med stammen af et kendt ord (for det meste en anden kasus eller et andet tal for et kendt ord). Redigeringsafstand gav en rigtig oversættelse for 55% af dem, en fælles begyndelse af ordet for 63%, og samme stamme for 69%. Kasusendelser ændrer ofte flere bogstaver, hvilket redigeringsgrænsen ikke tillader. De resterende ukendte ord (mærker, sjældne ord, tal) er en risiko: redigeringsafstand svarer for en fjerdedel af dem og har ret i en tredjedel af svarene. Vi bruger kun stammer ved opslag; under træningen sænkede de kvaliteten (afsnit 6).
Trin 2: reserveløsningen på de rigtige ordbøger
Ordbøgerne i appen udelader ord, der skrives ens på begge sprog, så et sådant ord er “ukendt” for reserveløsningen. En simpel reserveløsning ændrede derfor ord, der var rigtige: pizza blev til nicoise, pils blev til mushroom, mærkeordet Krönung blev til curd. På forespørgsler som skrevet faldt ordets F1 for oversættelsen med 3 point. Tre vagter fjerner det meste af skaden: et ord, der selv er et engelsk ord i ordbogen, lades urørt; meget korte ord lades urørt; og den tilladte redigeringsafstand holdes lille. Rækkefølgen er: nøjagtigt opslag, samme stamme, én redigering. Med vagterne skrumper tabet på forespørgsler som skrevet til 1.5 point, og på forespørgsler med en fejl stiger F1 med 30 point.
Trin 3: hele søgningen
Ord-F1 sammenligner en oversættelse med en reference, men en søgning har andre lister, der kan opfange en dårlig oversættelse. Vi kørte derfor hele søgningen, som i afsnit 3, på 200 forespørgsler (100 tyske og 100 ukrainske): som skrevet, og med én tilfældig tastefejl i et ord i hver forespørgsel (195 forespørgsler ændret). Hver forespørgsel blev oversat på fire måder: den korrekte oversættelse (en øvre grænse), ordbogen som den var, ordbogen med den simple reserveløsning og ordbogen med vagterne. De fire rangerede lister blev slået sammen med appens vægte, og en sprogmodel bedømte blindt de samlede øverste resultater.
| Oversættelse | Forespørgsler som skrevet første / top fem, point | En fejl pr. forespørgsel første / top fem, point |
|---|---|---|
| Korrekt (øvre grænse) | +0.5 / −1.0 | +15.0 / +11.5 |
| Ordbog, simpel reserveløsning | +1.5 / +1.0 | +8.5 / +4.5 |
| Ordbog, reserveløsning med vagter | +2.0 / +0.5 | +7.5 / +4.0 |
Tabel 2. Ændring i forhold til ordbogen som den var, i point af andelen af forespørgsler med det rigtige produkt først og i top fem.
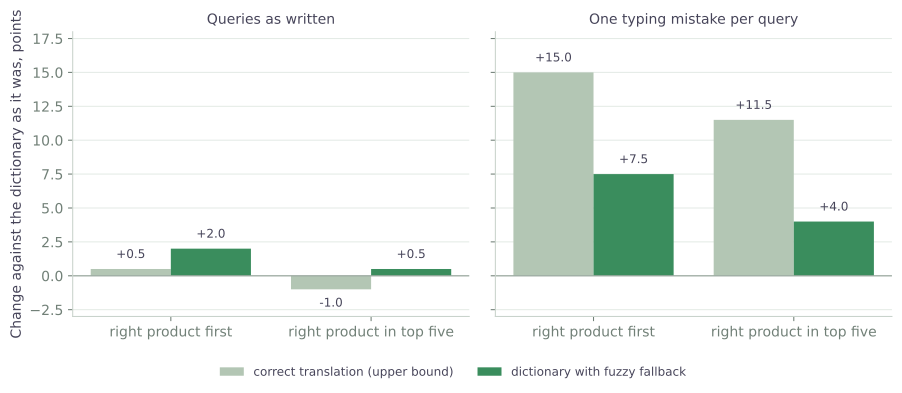
På forespørgsler som skrevet er ordbogen lige så god som den korrekte oversættelse (et halvt point bagud på førstepladsen, et point foran i top fem), og reserveløsningen ændrer ikke noget, vi kan måle (4 forespørgsler vundet og ingen tabt på førstepladsen, p = 0.13). Med en tastefejl taber ordbogen som den var 15 point på førstepladsen; reserveløsningen med vagter genvinder 7.5 af dem (30 forespørgsler vundet, 15 tabt, p = 0.04) og 4 af de 11.5 point i top fem (11 vundet, 3 tabt, p = 0.06). Søgningen, der kun bruger den engelske liste i Open Food Facts, vinder langt mere, 22 point på førstepladsen, fordi den ikke har en indbygget liste at falde tilbage på. Den simple og den vagtede reserveløsning kan ikke skelnes i hele søgningen; vi beholder den vagtede, fordi den ændrer færre korrekte ord. Gevinsten varierer efter sprog: ukrainsk giver 15 point på førstepladsen, tysk ingen, og vi undersøgte ikke, hvorfor.
Trin 4: målingens begrænsninger
Fejlene er syntetiske: én tilfældig redigering i næsten hver forespørgsel, langt oftere end folk faktisk skriver forkert, og uden nabotast-fejlene fra et rigtigt tastatur. To hundrede forespørgsler og én model som dommer giver p-værdier omkring 0.05, så resultatet med tastefejl viser retningen, og den præcise størrelse kræver rigtige forespørgsler. Gevinsten pr. rigtig forespørgsel er gevinsten ovenfor ganget med andelen af forespørgsler med en fejl, som vi ikke kender; med omkostningen på korrekte forespørgsler tæt på nul betaler selv en lille andel sig.
10. Hvad der ikke virkede, eller ikke var nødvendigt
- Fjernelse af den lokale engelske liste. På det andet forespørgselssæt var versionen uden den ikke bedre end firelistevarianten (top fem 2 point lavere, MRR .015 lavere, inden for støjen), så vi beholdt strukturen.
- Stammeføring før justering. Standardråd for sprog med rige ordendelser; det tabte præcision i vores forsøg. Nøjagtige former plus fraser virkede bedre.
- En meget stor vægt for taksonomiparrene. Det hjalp en lille smule på ukendte ord i to sprog og tabte på kendte ord. Det brugbare område er smalt, og vi holder os inden for det.
- Taksonomidækning som vægt for en liste. Den måler oversættelseskvaliteten på det sprog, og antallet af produkter, der findes på det, er en særskilt størrelse.
- En test, der ikke kunne se effekten. Vores første taksonomitest så på ord, basen allerede kendte, og fik taksonomien til at se ubrugelig ud. Lektionen er at spørge, hvad en test kan se, før man stoler på et nul-resultat.
Sådan bruger vi det i MuscleTiger
Fødevaresøgningen i MuscleTiger virker som beskrevet: din forespørgsel går til vores egen base og til Open Food Facts, på dit sprog og på engelsk; forespørgslen oversættes af en ordbog, der ligger på din telefon, og de fire rangeringer slås sammen med vægte, der afhænger af dit sprog. Resultaterne vises på appens grænsefladesprog, og produkter, der sælges i dit land, rangeres foran resten. Ordbogen virker uden netværk, så en forespørgsel i fitnesscentret uden signal finder stadig fødevarer i vores lokale base.
Konklusioner
- Søgningen finder den søgte fødevare for 92% af forespørgslerne. I en test af hele søgningen på ni sprog er den blandt de første ti resultater for 90% og på førstepladsen for 67%; enkelte produkter findes lidt oftere end retter.
- Oversættelse til engelsk er det, der betyder noget. Med korrekte oversættelser øgede den engelske liste andelen af ukrainske forespørgsler med det rigtige produkt i top fem med 61 point i forhold til Open Food Facts kun på ukrainsk; yderligere sprog ændrede lidt og sænkede, efter fire, top fem.
- Til fødevareforespørgsler kan en lille ordbog gøre oversætterens arbejde. Ordjustering på vores egne parallelle navne giver en fil på nogle hundrede kilobyte pr. sprog, offline, og gengiver vores referenceoversættelser af korte forespørgsler med en ordstamme-F1 på 0.94 til 0.96. Det er nøjagtigheden ved oversættelse af enkle forespørgsler; søgningens nøjagtighed måles særskilt og er lavere.
- De offentlige taksonomier hjælper mest, hvor vores egne data er tavse. Træning af ordbogen på dem forbedrede oversættelsen af holdout-sjældne termer med to til fem point i de sprog med en stor taksonomi, til en lille pris for almindelige ord.
- Vægten af hver liste kan afhænge af, hvor stort sproget er i OFF. For tysk hævede ændringen MRR med .062 på vores forespørgsler; for ukrainsk ændrede intet sig.
- En reserveløsning for skrivefejl betaler sig. Med en tastefejl falder førstepladsen med 15 point, når oversætteren kun kender nøjagtige former, og en reserveløsning med vagter (samme stamme, derefter en lille redigeringsafstand) genvinder halvdelen af det; for forespørgsler som skrevet koster den intet, vi kan måle.
- Matchning betød mere end sprogene. Vægtning af ord efter sjældenhed, stammeføring og ét talformat gav den største gevinst i studiet.
Begrænsninger. Forespørgslerne blev skrevet af os og bedømt af en sprogmodel, så marginerne er brede (omkring point ved 200 forespørgsler). Tallene gælder for tysk og ukrainsk; vægtene for de andre sprog er ekstrapoleret. Vi sammenlignede ikke med den neurale oversætter eller med andre apps. Næste skridt er en kontrol mod rigtige brugerforespørgsler.
Data og licenser
Produktdata og taksonomier kommer fra Open Food Facts, stillet til rådighed under Open Database Licence (ODbL); ordbøgerne beskrevet her er delvist afledt af OFF-taksonomierne og bærer samme tilskrivning. Vores lokale base er bygget på åbne nationale næringsstoftabeller, udgivet af offentlige myndigheder; deres kilder og licenser er angivet i appen. Vi takker Open Food Facts-bidragyderne og vedligeholderne af de nationale tabeller.
Kilder
- Brown PF, Della Pietra SA, Della Pietra VJ, Mercer RL. The mathematics of statistical machine translation: parameter estimation. Computational Linguistics 1993;19(2):263–311. ACL Anthology
- Moore RC. Improving IBM word-alignment Model 1. Proceedings of ACL 2004:518–525. ACL Anthology
- Cormack GV, Clarke CLA, Büttcher S. Reciprocal rank fusion outperforms Condorcet and individual rank learning methods. Proceedings of SIGIR 2009. doi:10.1145/1571941.1572114
- Darwish K, Oard DW. Probabilistic structured query methods. Proceedings of SIGIR 2003.
- Dyer C, Chahuneau V, Smith NA. A simple, fast, and effective reparameterization of IBM Model 2. Proceedings of NAACL-HLT 2013:644–648. ACL Anthology
- Open Food Facts: taxonomies of ingredients and categories and product data, world.openfoodfacts.org, under the Open Database Licence (ODbL).
- Riley D, Gildea D. Improving the IBM alignment models using variational Bayes. Proceedings of ACL (short papers) 2012:306–310. ACL Anthology
- Östling R, Tiedemann J. Efficient word alignment with Markov chain Monte Carlo. The Prague Bulletin of Mathematical Linguistics 2016;106:125–146.
- Mermer C, Saraçlar M. Bayesian word alignment for statistical machine translation. Proceedings of ACL (short papers) 2011:182–187. ACL Anthology
- Jalili Sabet M, Dufter P, Yvon F, Schütze H. SimAlign: high quality word alignments without parallel training data using static and contextualized embeddings. Findings of EMNLP 2020.