MuscleTiger onderzoeksnotities · Nr. 5
Voedsel zoeken in elke taal: zoekopdrachten vertalen, databases samenvoegen en wat we hebben gemeten
Je typt “Spiegelei mit Speck” of “борщ з м’ясом” in een voedingsdagboek en verwacht een product met calorieën en macro’s te zien. De grootste open voedingsdatabases zijn grotendeels in het Engels en Frans geschreven, terwijl mensen zoeken in hun eigen taal, met merknamen, woordeindes en typefouten. Deze notitie beschrijft hoe we de voedselzoekfunctie in MuscleTiger hebben gebouwd, wat we hebben geprobeerd, wat onnodig bleek en wat we hebben gemeten.
Kort samengevat
Onze voedselzoekfunctie vindt het bedoelde voedingsmiddel bij 92% van de zoekopdrachten in negen talen (sectie 3). We doorzoeken vier lijsten tegelijk (onze eigen voedingsbasis in het Engels en in de taal van de gebruiker, en Open Food Facts in de taal van de gebruiker en in het Engels) en voegen de ranglijsten samen met reciprocal rank fusion. Een zoekopdracht in een andere taal wordt eerst naar het Engels vertaald. Eerst gebruikten we een neurale vertaler op het apparaat, daarna vervingen we die door een klein woordenboek dat we leerden uit onze eigen parallelle voedselnamen, met een woordaligner uit de familie van IBM Model 2 met een Bayesiaanse prior, en uit de taxonomieën van Open Food Facts. Op onze testzoekopdrachten reproduceert het woordenboek de referentievertaling in het Engels met een woordstam-F1 van 0.94 (Duits) en 0.96 (Oekraïens). Dit meet de vertaling van korte, eenvoudige zoekopdrachten. Met correcte vertalingen verhoogt het toevoegen van de Engelse lijst het aandeel Oekraïense zoekopdrachten met het juiste product in de top vijf met 61 procentpunten, en verdere talen voegen weinig toe. De gewichten van de vier lijsten, die afhangen van hoe groot een taal is in Open Food Facts, verbeterden het Duits en lieten het Oekraïens ongewijzigd. Een terugvaloptie voor typefouten in de vertaler herstelt ongeveer de helft van de 15 procentpunten die een fout kost.
We leggen de aanpak uit en de families van methoden die we hebben overwogen.
1. Het probleem: een zoekopdracht in één taal, data in meerdere
Een voedselzoekfunctie moet drie dingen tegelijk goed doen. Ze moet een korte en rommelige zoekopdracht begrijpen (“chicken breast 200g”, “coca cola zero”, “мигдальне молоко”). Ze moet een product vinden dat volledige en plausibele voedingswaarden heeft. En ze moet werken in de taal van de persoon, op een telefoon, snel en idealiter offline.
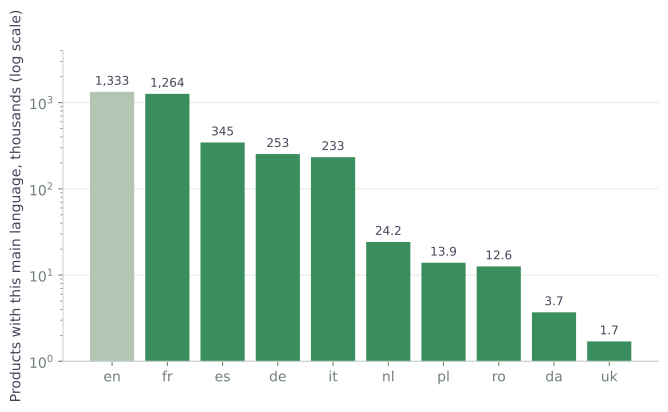
De data die we kunnen gebruiken zijn ongelijk verdeeld. Open Food Facts (OFF) [6], de open database van verpakte producten, bevat miljoenen producten, maar de taal van een product volgt het land waar het wordt verkocht en de gewoonten van de bijdragers. Als we producten tellen op hun hoofdtaal (OFF, 15 november 2026), lopen Engels en Frans voorop met elk ongeveer 1.3 miljoen producten, gevolgd door Spaans, Duits en Italiaans met 230 tot 350 duizend, en de kleinere talen die we ondersteunen hebben er tussen 1.7 en 25 duizend (figuur 1). Een zoekopdracht in het Oekraïens kan daarom in het Oekraïens door heel weinig producten worden beantwoord, terwijl een zoekopdracht in het Frans een database treft die van nature grotendeels Frans is.
Onze eigen basis
De tweede bron is onze eigen basis van voedingsmiddelen met volledige energie en macronutriënten. Het is een samenvoeging van meerdere nationale voedingssamenstellingstabellen, gekozen omdat ze open zijn, in laboratoria gemeten en volledig voor macronutriënten. Veel van de voedingsmiddelen hebben huishoudelijke porties zoals “1 slice”. Een voedingsmiddel wordt overgeslagen als er al een met dezelfde naam in de basis zit, en nieuwe rijen komen altijd na de oude, zodat het nummer van een product en zijn vertalingen nooit verandert wanneer er een tabel wordt toegevoegd.
Toen we later drie tabellen aan de basis toevoegden, steeg het aandeel testzoekopdrachten met het juiste product in de top vijf met 3 procentpunten en op de eerste plaats met 2 procentpunten; geen van beide verschillen is significant. De winst kwam vooral van veelgebruikte gerechten die de nieuwe tabellen in gewoon Engels beschrijven, zoals lasagna, cappuccino of Griekse yoghurt. We hebben één kandidaat-tabel weggelaten, omdat de licentie een share-alike-voorwaarde heeft die zich zou kunnen uitstrekken tot onze samengevoegde basis.
De tabellen zijn geschreven in het Engels of in de taal van hun land, dus de namen in de andere talen moesten worden gemaakt. De Engelse namen zijn het origineel; de namen in de andere talen zijn door machinevertaling geproduceerd en deels later opnieuw gemaakt door taalmodel-agenten met automatische controles (een validator wijst een antwoord af dat getallen, eenheden of de structuur van de naam verandert). Getallen in namen gebruiken in elke taal een decimale punt, zowel in de basis als in de zoekopdracht, zodat een zoekopdracht met een vetpercentage het product met dat percentage kan voorkeur geven.
2. Vier lijsten en één rangschikking
Het ontwerp dat we gebruiken is eenvoudig te beschrijven. Elke zoekopdracht wordt op vier plaatsen doorzocht:
- A: onze lokale basis, met de zoekopdracht vertaald naar het Engels;
- B: onze lokale basis, met de zoekopdracht zoals de gebruiker die in zijn taal heeft getypt;
- C: Open Food Facts, doorzocht in de taal van de gebruiker;
- D: Open Food Facts, doorzocht met de Engelse vertaling.
Elke lijst levert zijn eigen rangschikking, en de rangschikkingen worden samengevoegd via reciprocal rank fusion (RRF) [3]. Een product dat bovenaan in meerdere lijsten staat, wint van een product dat alleen in één lijst op de eerste plaats staat:
waarin de positie van product in lijst is, een gewicht van de lijst is en een kleine constante die voorkomt dat de eerste plaats alles overheerst. De methode heeft geen scores van de lijsten nodig, alleen hun volgorde, wat belangrijk is omdat de lijsten uit verschillende systemen komen met onvergelijkbare scores. We hebben haar daarom gekozen; Cormack en collega’s melden dat ze in hun experimenten concurrerend is met uitgebreidere methoden voor het leren van rangschikkingen [3].
RRF is een gepubliceerde methode, en onze bijdrage is de meting: welke lijsten we opnemen, hoe we de zoekopdracht vertalen, en hoeveel we elke lijst in elke taal vertrouwen.
3. Hoe we hebben gemeten
De werkwijze:
- We hebben zoekopdrachten geschreven in verschillende typen: merk plus product, gerecht, alledaags voedsel, drank, en informeel of met spelfouten. Eén set heeft 959 zoekopdrachten, waarvan er 200 in detail zijn beoordeeld; een tweede set heeft 200 zoekopdrachten, 100 in het Duits en 100 in het Oekraïens, met 20 van elk type. Een aparte set gerechten uit andere keukens (bijvoorbeeld een Japans gerecht gevraagd in het Duits) test of de taal van de zoekopdracht moet volgen op het gerecht.
- Voor elke zoekopdracht hebben we de bovenste resultaten van elke configuratie samengevoegd, en een taalmodel beoordeelde elke kandidaat als relevant of niet. Het zag de zoekopdracht en de Engelse vertaling, maar niet welke configuratie de kandidaat had teruggegeven. De beoordelaar kon dus geen methode bevoordelen.
- We rapporteren top-1 (het juiste product staat eerst), top-5 (het staat bij de eerste vijf) en MRR, het gemiddelde van van het eerste relevante resultaat. Voor vergelijkingen tussen configuraties koppelen we de resultaten per zoekopdracht en gebruiken we tekentoetsen en bootstrap-intervallen.
Nauwkeurigheid van de hele zoekfunctie
Het getal in de samenvatting komt uit een test van de zoekfunctie precies zoals die in de app werkt. We schreven tien zoekopdrachten in elk van de negen talen die de app naast Engels ondersteunt, twee van elk type, 90 zoekopdrachten in totaal. Elke zoekopdracht doorliep dezelfde stappen als op een telefoon: vertaling met het woordenboek, onze database in het Engels en in de taal van de zoekopdracht, Open Food Facts in beide talen waarbij producten die in het land van die taal worden verkocht naar voren schuiven, en de fusie met de gewichten van de app. We lazen de hele samengevoegde lijst van elke zoekopdracht, gemiddeld zo’n zestig resultaten, en markeerden met de hand het eerste resultaat dat een gebruiker als het bedoelde voedingsmiddel zou accepteren, met dezelfde regels als de blinde beoordelaar.
| Het bedoelde voedingsmiddel wordt gevonden | Alle zoekopdrachten (90) | Losse producten (65) | Gerechten (25) |
|---|---|---|---|
| ergens in de lijst | 92.2% | 93.8% | 88.0% |
| bij de eerste tien | 90.0% | 90.8% | 88.0% |
| bij de eerste vijf | 85.6% | 86.2% | 84.0% |
| op de eerste plaats | 66.7% | 67.7% | 64.0% |
Nauwkeurigheid van de hele zoekfunctie. Tien zoekopdrachten in elk van negen talen, gezocht zoals in de app. Losse producten zijn voedingsmiddelen, verpakte producten en dranken; gerechten omvatten ook samengestelde maaltijden, zoals een boterham met kaas of havermout met melk.
Het bedoelde voedingsmiddel staat bij 92% van de zoekopdrachten ergens in de lijst, bij 90% bij de eerste tien resultaten, bij 86% bij de eerste vijf en bij 67% op de eerste plaats. Losse producten worden iets vaker gevonden dan gerechten (94% tegenover 88% ergens in de lijst). De missers zijn vooral merkproducten die in geen enkele lijst staan, en snacks van meerdere voedingsmiddelen, waarvoor de lijsten wel de ingrediënten bieden maar niet de snack zelf. Tien zoekopdrachten per taal is een kleine basis: één zoekopdracht verschuift de uitkomst van een taal met tien punten, dus de getallen beschrijven de zoekfunctie als geheel en zeggen weinig over een afzonderlijke taal. De volgende secties halen de zoekfunctie uit elkaar en meten elke stap op grotere sets zoekopdrachten in het Duits en het Oekraïens.
4. Wat een correcte vertaling voor de zoekfunctie doet
Voordat we beschrijven hoe we een goede vertaler probeerden te bouwen, hebben we gemeten wat een correcte vertaling waard is. We schreven 100 voedselzoekopdrachten in het Oekraïens (elk 20 van alledaags voedsel, gerechten, dranken, merken en informele zoekopdrachten) en vertaalden elk met de hand naar de andere negen talen, zodat de vertaling correct is per constructie. Voor elke taal hebben we Open Food Facts doorzocht met de zoekopdracht in die taal, en de lijsten samengevoegd met reciprocal rank fusion (vergelijking 1, gelijke gewichten). De eerste configuratie is alleen het Oekraïens, de tweede voegt het Engels toe, en daarna voegden we Frans, Spaans, Duits, Italiaans, Nederlands, Pools, Roemeens en Deens toe, in de volgorde van het aantal producten van elke taal in OFF (figuur 2). De relevantie is blind beoordeeld door een taalmodel met de regels van sectie 3, over de samengevoegde top vijf van elke configuratie.
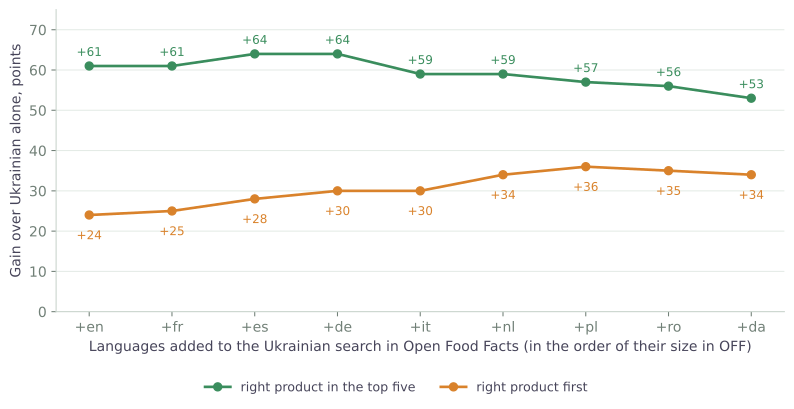
De eerste stap is verreweg de grootste. Zoeken in OFF alleen in het Oekraïens levert vaak niets op: OFF heeft weinig Oekraïenstalige producten (figuur 1), en voor 47 van de 100 zoekopdrachten was de Oekraïense lijst leeg. Het toevoegen van de Engelse vertaling verhoogt het aandeel zoekopdrachten met het juiste product in de top vijf met 61 procentpunten en op de eerste plaats met 24 procentpunten, met 61 zoekopdrachten erbij en geen enkele verloren.
De volgende talen veranderen weinig. Frans laat de top vijf ongewijzigd (5 zoekopdrachten erbij, 5 verloren). Spaans en Duits voegen er nog 3 procentpunten aan toe, binnen de ruis. Daarna daalt de top vijf met 11 procentpunten vanaf het hoogste punt met alle tien talen, terwijl de eerste plaats nog eens 10 tot 12 procentpunten stijgt. De daling van vier naar tien talen in de top vijf is significant bij deze zoekopdrachten (2 erbij, 13 verloren, tekentoets p = 0.007); de stijging van de eerste plaats van twee naar tien talen is dat niet (20 erbij, 10 verloren, p = 0.10). Merken gedragen zich anders dan alledaags voedsel: met meer lijsten wordt een merkzoekopdracht vaker gevonden (15 procentpunten meer in de top vijf met Spaans erbij dan met alleen het Engels), terwijl alledaags voedsel minder vaak wordt gevonden (25 procentpunten minder met tien talen dan met het Engels). Twintig zoekopdrachten per type is een kleine basis, dus deze verschillen zijn indicatief.
Een correcte vertaling naar het Engels draagt het effect. Elke verdere taal is een extra verzoek aan OFF en verdunt, na de eerste paar, de rangschikking.
Gerechten uit een andere keuken
De stap naar het Engels is het belangrijkst wanneer het gerecht uit een andere keuken komt. Een aparte set van 100 zoekopdrachten, tien in elk van de tien talen, noemde een bekend buitenlands gerecht zoals een gebruiker het zou typen: Borschtsch voor een Duitse gebruiker, paella, pierogi, tiramisu, stroopwafel, sarmale. Dit is een oudere test, en de zoekopdrachten zijn vertaald door de neurale vertaler die de app toen gebruikte (sectie 5). Voor de 90 niet-Engelse zoekopdrachten verhoogde het vertalen van de zoekopdracht naar het Engels het aandeel met het gerecht in de top vijf met 34 procentpunten ten opzichte van een zoekopdracht in Open Food Facts in de eigen taal van de gebruiker (47 zoekopdrachten erbij, geen verloren, p < 0.001). Meer talen na het Engels veranderden niets in de top vijf, ook niet wanneer we vooraf de taal van het land waar het gerecht vandaan komt kozen.
Onze lokale basis hielp hier: zonder de Engelse lijst daarvan daalde de eerste plaats met 8 procentpunten bij deze zoekopdrachten (7 verloren, geen erbij, p = 0.016), omdat de basis paella, ratatouille of lasagna kent en ze op de eerste plaats zet. Bij alledaags voedsel toonde ze geen zo’n voordeel. Het verwijderen ervan maakte de zoekfunctie echter ook niet beter (sectie 10), dus we houden haar. De overgebleven missers waren gerechten die geen OFF-lijst onder enige naam heeft, zoals sarmale. De set heeft slechts ongeveer twintig verschillende gerechten, dus hij beschrijft bekende gerechten en zegt weinig over zeldzame.
Matching was belangrijker dan talen
De grootste enkele verbetering van de hele studie kwam van het matchen van woorden in de lokale basis, zonder vertaling. De lokale basis wordt doorzocht met haar eigen matching, en functiewoorden, naamvallen en decimale komma’s braken die: “soup with mushrooms” in het Oekraïens gaf niets terug, omdat de matching vereiste dat elk woord van de zoekopdracht gevonden werd zoals getypt. Door zoekwoorden te wegen naar hoe zeldzaam ze zijn (IDF), een Snowball-stemmer voor de talen die er een hebben en één getalnotatie, verbeterde de top-5 op de standaardset met ongeveer 9% sinds het begin van de studie (tekentoets p = 0.008), en bij zoekopdrachten met voorzetsels en woordvormen met ongeveer 12%.
5. Waarom we de vertaler hebben vervangen
We hebben ML Kit verwijderd omdat het voedselnamen slecht vertaalt. Het is een algemene vertaler die voor zinnen is gebouwd, en een voedselnaam is een paar woorden zonder context: een merk, een toestand van het product, een gerecht dat naar een plaats is genoemd. Onze basis is eerst met de vertaler vertaald, en dit zijn echte items (de Oekraïense en Franse vertalingen, met een verklaring voor lezers die de taal niet spreken):
| Engelse naam | Uitvoer van ML Kit | Wat ging er mis |
|---|---|---|
| plain, refrigerated | рівнина, холодильна (Oekraïens) | “plain” betekent hier ongezoet, zoals in plain yoghurt, maar werd vertaald als “vlakte” (het landschap); “refrigerated” werd een bijvoeglijk naamwoord met de betekenis “van een koelkast” |
| boneless | безкімнатний (Oekraïens) | betekent “zonder kamers”; de bedoelde betekenis is “zonder botten” |
| Pad Thai | Подушка тайська (Oekraïens) | de naam van het gerecht werd als woorden gelezen: “Thaise kussen” |
| Rice flour, brown | Рисова борошно, коричневий (Oekraïens) | de bijvoeglijke naamwoorden komen niet overeen met het zelfstandig naamwoord “flour”, wat in het Oekraïens ongrammaticaal is |
| Meringue with chocolate; Ham salad spread | deels of volledig niet vertaald (Oekraïens) | de Engelse woorden blijven in de naam staan |
| bun | chignon (Frans) | een haarknot (het kapsel), terwijl het broodje werd bedoeld |
| sauerkraut | chouchoune (Frans) | een ander woord; het Franse woord voor zuurkool is choucroute |
Dezelfde zwakte speelt bij zoekopdrachten, waar een verkeerd woord een ontbrekend product betekent, en die kan lokaal niet worden verholpen: je kunt één woord in een neuraal model niet corrigeren. Er waren twee mindere redenen: de modellen nemen ongeveer 40 MB per taal in beslag, en de SDK is een component van een derde partij.
De data die we bezitten wijst naar een beter hulpmiddel. Onze basis heeft paren van een Engelse naam en de naam in elke taal, een parallel corpus precies in het domein dat we nodig hebben. Een woordenboek kan uit zo’n corpus worden geleerd.
6. Een woordenboek geleerd via woordalignering
Een woordenboek leren uit parallelle tekst is het oude probleem van woordalignering: bepalen welk woord van de ene zin overeenkomt met welk woord van de andere. De klassieke familie is de IBM-modellen van statistische machinevertaling [1]. Model 1, het eenvoudigste en ons startpunt, behandelt een naam in de ene taal als gegenereerd uit de woorden van de andere, zonder rekening te houden met de volgorde. Voor een Engelse naam en een naam in een andere taal (met een leeg woord toegevoegd) is de kans op het paar
en de tabel van woordvertaalkansen , het woordenboek, wordt geschat met expectation–maximisation: in elke ronde krijgt elk woordpaar in een naampaar een deel van de telling, evenredig met de huidige kans, en de delen worden genormaliseerd tot nieuwe kansen. Voor een korte voedselnaam past dit goed, omdat er weinig woordvolgorde is om te modelleren. De bekende zwakte beschreef Moore [2]: een zeldzaam woord kan elke kans aannemen die past bij zijn ene zin, dus zeldzame woorden worden “vuilnisophalers” die met te veel woorden uitlijnen. Moore stelde voor de tellingen te gladstrijken en een betere initialisatie te gebruiken; een Bayesiaanse prior op de vertaalkansen, toegepast via variational inference, is een andere remedie [7].
Wat we hebben overwogen en gemeten
We hebben onze aligner vergeleken met zijn ablaties, met referentie-implementaties van twee gepubliceerde aligners en met een methode die helemaal geen alignatiemodel heeft. Elke methode kreeg dezelfde naamparen, dezelfde afgehouden 5% en dezelfde manier om alignaties in een woordenboek om te zetten (een woordpaar telt als het minstens twee keer is gekoppeld; elk woord krijgt zijn meest frequente vertaling). De kwaliteit is de F1 van woordstammen tussen de woordenboekvertaling van een afgehouden naam, woord voor woord, en zijn Engelse naam, gemiddeld over negen talen (tabel 1). De verschillen zijn klein, dus rapporteren we ook in hoeveel van de negen talen een verschil duidelijk is (het 95% bootstrap-interval van het gepaarde verschil sluit nul niet in).
| Methode | Wat het is | Gemiddelde F1 | Tegenover ons |
|---|---|---|---|
| Dice-coëfficiënt | geen alignatiemodel, elk woord koppelt aan het woord waarmee het het vaakst samen voorkomt | 0.812 | slechter in 7 van 9 |
| IBM Model 1 [1], EM | woordvertaalkansen, geen woordvolgorde | 0.817 | slechter in 6 van 9 |
| Model 1 met een Dirichlet-prior [7] | variational Bayes op de vertaalkansen | 0.822 | slechter in 4 van 9 |
| Diagonale alignatieprior, EM | Model 2 in de fast_align-parameterisatie [5], zonder de Bayesiaanse prior | 0.822 | slechter in 6 van 9 |
| Ons | diagonale prior en Dirichlet-prior, twee richtingen, doorsnede | 0.825 | – |
| Ons, grow-diag-final-and | hetzelfde, met de koppelingen van beide richtingen gecombineerd via de standaardheuristiek | 0.828 | beter in 5 van 9, slechter in 1 |
| fast_align [5] | de implementatie van de auteurs, doorsnede / grow-diag-final-and | 0.826 / 0.831 | 3 beter, 2 slechter / 7 beter |
| eflomal [8] | HMM met vruchtbaarheid, Bayesiaans, MCMC-sampling; doorsnede / grow-diag-final-and | 0.825 / 0.828 | 2 beter, 2 slechter / 7 beter |
| SimAlign [10] | meertalige BERT-embeddings, geen training op onze namen; drie matchingmethoden (beste / iteratief / doorsnede) | 0.824 / 0.822 / 0.812 | 2 beter, 2 slechter / 1 beter, 3 slechter / slechter in 8 |
Tabel 1. Aligners vergeleken op afgehouden namen uit onze basis, negen talen. De laatste kolom telt de talen waarin het verschil met ons duidelijk is. fast_align en eflomal zijn de implementaties van de auteurs.
De kale Dice-coëfficiënt ligt maar 0.013 achter op de onze, en SimAlign, dat geen training op onze namen nodig heeft, staat op gelijke hoogte met de onze bij zijn beste instelling. Bij korte, bijna parallelle namen maakt de keuze van de aligner weinig uit, en het grootste deel van de kwaliteit komt van de namen zelf. Elk ingrediënt van ons voegt een beetje toe, en de echte fast_align met dezelfde doorsnede geeft hetzelfde resultaat (0.826 tegenover 0.825), wat we verwachten van een methode met hetzelfde ontwerp. Het combineren van de twee richtingen met de standaardheuristiek grow-diag-final-and levert ongeveer net zoveel op als de keuze van het model: tussen een kwart en een halve punt F1 voor alle drie, ten opzichte van de doorsnede. Het is een kleine winst die in de meeste talen duidelijk is, en we zijn van plan die te gebruiken de volgende keer dat de woordenboeken worden herbouwd.
Het terugbrengen van woorden tot Snowball-stammen vóór de alignatie verlaagt de F1 (0.818, slechter in 6 van 9 talen). Het houden van alleen de eerste vier letters van elk woord, wat Östling en Tiedemann als bruikbare benaderende stemming voor machinevertaling melden [8], verlaagt hem veel meer (0.743). De taak verklaart het verschil: Östling en Tiedemann meten vertaalsystemen die op de alignaties zijn gebouwd, en wij zoeken losse woorden van een voedselnaam op in een woordenboek, waar het samenvoegen van woordvormen verschillende voedingsmiddelen samenvoegt.
We hebben de Gibbs-sampler van Mermer en Saraçlar [9] (een volledig Bayesiaanse Model 1), IBM-modellen 3–5 of de probabilistische gestructureerde zoekopdrachten van Darwish en Oard [4], die meerdere vertalingen per woord bewaren, niet gedraaid. Die laatste is een mogelijke volgende stap, omdat ons woordenboek alleen de beste kandidaat bewaart.
Wat onze aligner is
Onze aligner is onze eigen implementatie van een IBM Model 2 in de fast_align-parameterisatie [5]: de kans dat een woord aan een bepaalde positie wordt gekoppeld, daalt met de afstand tot de diagonaal (in Model 1 is die uniform), omdat voedselnamen de woordvolgorde tussen talen geneigd zijn te behouden. Daarbovenop krijgen de woordvertaalkansen een schaarse Dirichlet-prior met variational inference [7], zoals in fast_align, wat voorkomt dat zeldzame woorden de kans opslokken. De vaste constanten (de kans om een woord aan niets te koppelen, de sterkte van de prior en de beginsteilheid van de diagonaal) zijn die welke Dyer en collega’s rapporteren; fast_align schat de steilheid ook tijdens de training opnieuw, wij niet. Het wordt in beide richtingen getraind, en alleen de koppelingen waarop beide richtingen het eens zijn worden bewaard (doorsnede), wat de precisie verhoogt ten koste van de recall. Woorden worden in hun exacte vorm uitgelijnd zonder stemming: het terugbrengen van woorden tot stammen, wat gebruikelijk is voor talen met rijke woordeindes, verloor nauwkeurigheid in onze eerste proeven, dus samenstellingen en woorden met koppelteken worden via frasen behandeld.
Het resultaat is een woordenboek in drie lagen dat de vertaler toepast vanaf de langste match van maximaal drie woorden: taxonomie-items, frasen uitgelijnd in onze basis, en losse woorden uitgelijnd in onze basis. Een woord dat niet in het woordenboek staat, zoals een merk of een spelfout, wordt ongewijzigd doorgegeven, omdat OFF het vaak wel kent. Elke taal is een bestand van enkele honderden kilobytes, tegenover ongeveer 40 MB per taal voor de neurale modellen. Het werkt offline en elke vertaling is terug te voeren op een regel van het woordenboek en is te corrigeren.
Hoe goed is de vertaling
We meten de vertaler op twee manieren. Op 5% van de naamparen die van de training zijn afgehouden, geeft het woord voor woord vertalen van de vreemde naam en het vergelijken van het resultaat met de Engelse naam op woordstammen een F1 tussen 0.78 en 0.90 over de negen talen. Op de evaluatiezoekopdrachten, waarbij we bij elke zoekopdracht een referentie-Engelse vertaling hebben geschreven, is de F1 van woordstammen 0.94 voor het Duits (88 van 100 zoekopdrachten identiek in stammen) en 0.96 voor het Oekraïens (89 van 100).
Deze getallen beschrijven de vertaling van korte, veelvoorkomende zoekopdrachten naar het Engels. De kwaliteit van de zoekfunctie zelf is lager en wordt apart gemeten (secties 3 en 9). We hebben de oude neurale vertaler niet op dezelfde zoekopdrachten gedraaid, dus we beweren niet dat het woordenboek beter is dan ML Kit; het is nauwkeurig genoeg voor deze zoekopdrachten, klein, offline en corrigeerbaar.
7. De Open Food Facts-taxonomieën: wat ze geven en wat ze kosten
OFF onderhoudt openbare taxonomieën van ingrediënten en categorieën: hiërarchische lijsten waarin elk item een Engelse naam heeft, en namen en synoniemen in vele talen, geschreven door vrijwilligers. Ze bevatten duizenden items met een Engelse naam, en ze zijn om drie redenen aantrekkelijk: de vertalingen zijn door mensen gemaakt en in het voedseldomein, ze bevatten woorden die onze eigen namen nooit gebruiken (zeldzame ingrediënten), en ze zijn onafhankelijk van de machinevertaling die onze namen heeft geproduceerd.
De moeilijkheden:
- Ongelijke dekking. Het aandeel items met een naam in een bepaalde taal loopt van 1.6% (Oekraïense categorieën) tot 84.6% (Franse categorieën), dus de taxonomie kan niet de enige bron zijn. We passen haar eerst toe, waar een item bestaat, en laten het woordenboek uit onze basis de rest aanvullen.
- Categorie-achtige namen en veel synoniemen. Een item heeft één Engelse naam en veel synoniemen in een taal. Elk synoniem wordt gekoppeld aan de hoofdnaam in het Engels, en zeer lange Engelse namen worden overgeslagen.
- Frasen en woorden. Taxonomienamen zijn frasen, dus de vertaler zoekt op elke positie eerst de langste fras voordat hij losse woorden probeert.
- Ruis. Wanneer de taxonomie ook als trainingsdata wordt gebruikt, concurreren de categorie-achtige frasen met de idiomatische frasen van onze basis. Een gewicht voor de taxonomieparen moest worden gemeten. Een te groot gewicht kostte nauwkeurigheid bij veelvoorkomende woorden, en het bruikbare bereik is smal.
Trainen op de taxonomie: een test die het effect niet kon zien
Onze eerste test van het toevoegen van taxonomieparen aan de alignatietraining liet niets zien. We hebben het gemeten op afgehouden namen uit onze eigen basis en op onze zoekopdrachten, en de vertaalkwaliteit veranderde met hooguit een paar duizendsten. We concludeerden bijna dat de taxonomie alleen bruikbaar was als opzoeklijst. Die test kon het effect niet zien: beide sets bevatten woorden die onze basis al kent, terwijl het doel van de taxonomie is woorden toe te voegen die zij niet heeft.
De eerlijke test verwijdert een tiende van de taxonomie-items uit de opzoeklaag en uit de training, bouwt het woordenboek met en zonder taxonomietraining, en vertaalt de namen van de verwijderde items. Voor de talen met een grote taxonomie voegt de training twee tot vier punten F1 toe op alle afgehouden namen en vier tot vijf punten op namen met een woord dat onze basis mist, zonder verlies bij namen die uit bekende woorden bestaan (figuur 3). Voor de talen met een kleine taxonomie, zoals het Oekraïens en het Roemeens, verandert niets. We hebben onze vroege aanbeveling herzien, en de woordenboeken in de app zijn gebouwd met taxonomietraining.
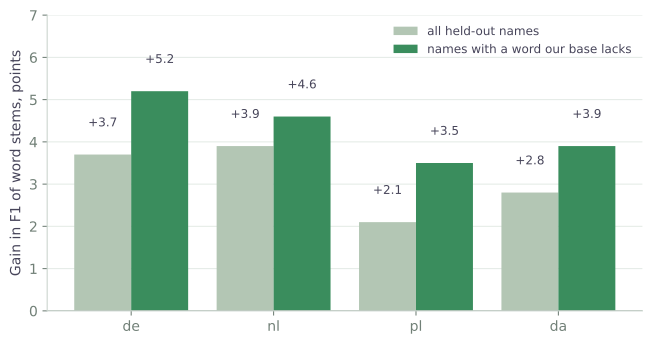
Waar het kan schaden. Taxonomienamen zijn categorie-achtig, en hun synoniemen kunnen een idiomatische fras die we uit onze basis hebben geleerd verdringen (“home fries” voor een gerecht van gebakken aardappel). Bij de Duitse zoekopdrachten kostte dit ongeveer één punt F1, en bij het Oekraïens niets, een prijs die we accepteerden voor de winst op zeldzame woorden.
8. Gewichten van de vier lijsten per taal
In vergelijking (1) heeft elke lijst een gewicht. Onze eerste gewichten waren voor alle talen gelijk, afgesteld op één zoekset. Maar de kwaliteit van de lijsten verschilt per taal. De eigen OFF-lijst C is rijk in het Frans of Duits en dun in het Oekraïens, waar de Engelse lijst D meer van de last draagt. Een eigen set gewichten per taal is een natuurlijk idee, en de vraag is waar we die vandaan halen voor tien talen, terwijl we testzoekopdrachten voor twee hebben.
We overwogen twee maten. De eerste was het aandeel taxonomie-items dat een naam in de taal heeft. Het is makkelijk te berekenen, maar het meet hoe goed vrijwilligers de woordenschat hebben vertaald, wat het woordenboek beïnvloedt, en zegt weinig over hoeveel producten een naam in die taal dragen; de twee kolommen spreken elkaar zelfs tegen (Italiaans: 75% van de ingrediënten en 28% van de categorieën). We hebben die niet gebruikt. De tweede was het aantal OFF-producten per taal ten opzichte van het Engels, beschikbaar via de zoekdienst (figuur 1). Het is een benadering, omdat de hoofdtaal van een product kan verschillen van de taal van een naamveld, en toch volgt het wat we nodig hebben: hoe waarschijnlijk de eigen lijst het product kent. Daaruit leiden we met een vloeiende formule een gewicht per taal af, dat meer gewicht geeft aan de eigen lijst naarmate de taal groeit, en we leggen de waarden vast in een kleine opzoektabel in de app.
Bij de 200 beoordeelde Duitse en Oekraïense zoekopdrachten is het effect duidelijk voor het Duits en afwezig voor het Oekraïens (figuur 4). De MRR van het Duits stijgt met .062 (95% bootstrap-interval van het verschil +.030 tot +.099) en de eerste plaats met 7 procentpunten, terwijl de top vijf er 3 procentpunten bij krijgt, wat binnen de ruis valt. De MRR van het Oekraïens daalt met .002, omdat de nieuwe gewichten dicht bij de oude gemeenschappelijke gewichten liggen. De winst voor het Duits geldt in beide helften van de zoekopdrachten, wanneer je ze in oneven en even splitst.
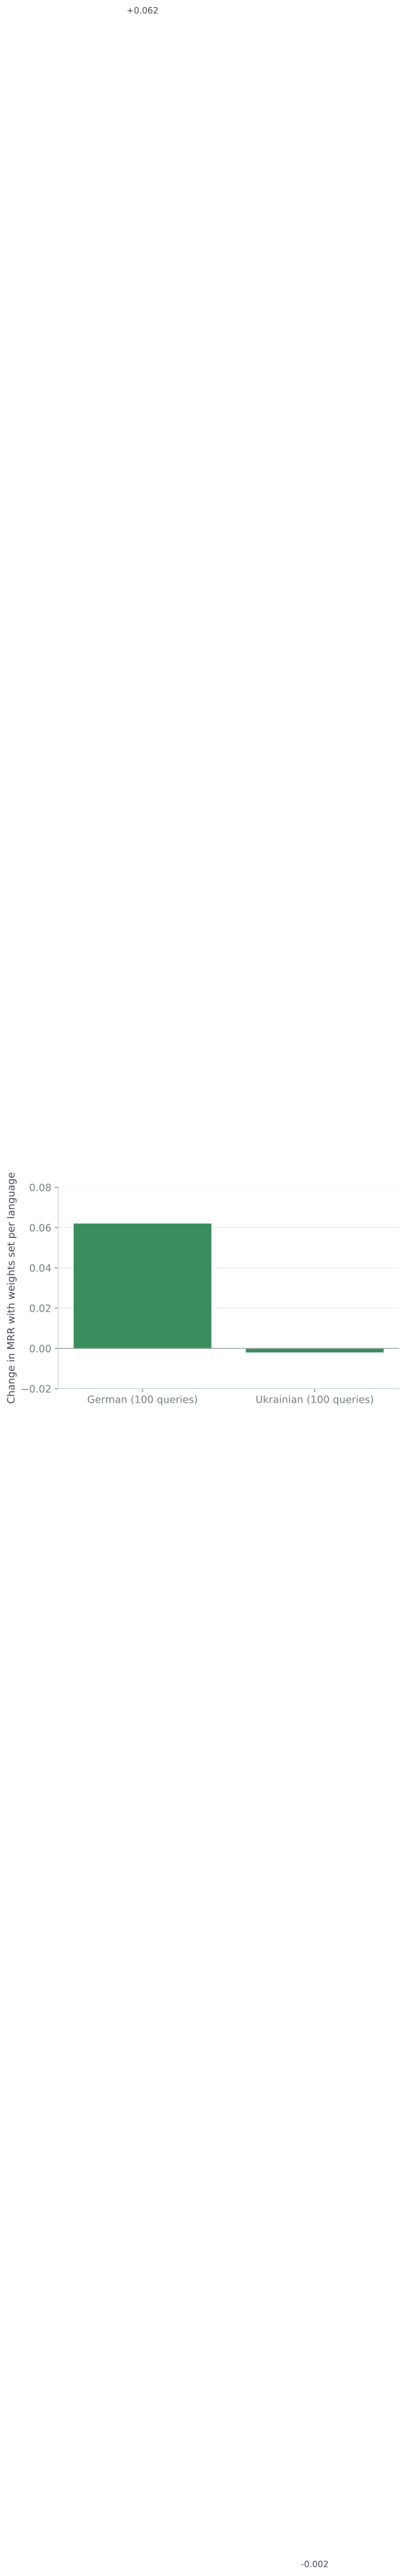
De constanten van de formule zijn op dezelfde zoekopdrachten vastgesteld, en de gewichten van de andere talen volgen uit de formule en zijn niet gemeten.
9. Typefouten en woordvormen
Het woordenboek kent exacte vormen van woorden. Een woord met een typefout, of een naamval die het niet heeft gezien, gaat ongewijzigd door en bereikt de Engelse lijsten als een woord dat daar niets betekent. De zoekfunctie in onze lokale basis repareert fouten al met een SymSpell-index, een index van bewerkingsafstand waarin het aantal toegestane bewerkingen groeit met de lengte van het woord. De open vraag was de vertaalstap, dus hebben we gemeten wat fouten kosten en wat een terugvaloptie oplevert.
Stap 1: fouten en woordvormen, woord voor woord
We hebben de woordenboeken van de negen talen opnieuw gebouwd uit onze namen, en uit de afgehouden namen de woorden met een bekende vertaling genomen. Elk kreeg één willekeurige bewerking (een letter verwijderd, ingevoegd of vervangen, of twee naburige letters omgewisseld). Een opzoeking binnen de toegestane bewerkingsafstand gaf de vertaling van het oorspronkelijke woord voor 92.5% van de beschadigde woorden, tegenover 0.3% voor de exacte opzoeking. Als de eerste letter moest kloppen, zoals de zoekfunctie in de lokale basis kan vereisen, daalde dat tot 77%, omdat fouten op de eerste letter dan worden gemist.
Voor woordvormen namen we de afgehouden woorden die het woordenboek niet kent, maar waarvan de Snowball-stam gelijk is aan de stam van een bekend woord (meestal een andere naamval of een ander getal van een bekend woord). Bewerkingsafstand gaf een juiste vertaling voor 55% ervan, een gemeenschappelijk begin van het woord voor 63%, en dezelfde stam voor 69%. Naamvalsuitgangen veranderen vaak meerdere letters, wat de bewerkingslimiet niet toelaat. De overige onbekende woorden (merken, zeldzame woorden, getallen) vormen een risico: bewerkingsafstand geeft voor een kwart ervan een antwoord, en dat antwoord is in een derde van de gevallen juist. We gebruiken stammen alleen bij het opzoeken; tijdens de training verlaagden ze de kwaliteit (sectie 6).
Stap 2: de terugvaloptie op de echte woordenboeken
De woordenboeken in de app laten woorden weg die in beide talen hetzelfde worden geschreven, dus zo’n woord is “onbekend” voor de terugvaloptie. Een gewone terugvaloptie veranderde daarom woorden die juist waren: pizza werd nicoise, pils werd mushroom, het merkwoord Krönung werd curd. Op zoekopdrachten zoals geschreven daalde de woord-F1 van de vertaling met 3 procentpunten. Drie waarborgen verwijderen het grootste deel van de schade: een woord dat zelf een Engels woord in het woordenboek is, blijft met rust; zeer korte woorden blijven met rust; en de toegestane bewerkingsafstand blijft klein. De volgorde is: exacte opzoeking, zelfde stam, dan één bewerking. Met de waarborgen krimpt het verlies op zoekopdrachten zoals geschreven tot 1.5 procentpunten, en op zoekopdrachten met een fout stijgt de F1 met 30 procentpunten.
Stap 3: de hele zoekfunctie
Woord-F1 vergelijkt een vertaling met een referentie, en een zoekfunctie heeft andere lijsten die een slechte vertaling kunnen opvangen. Daarom hebben we de hele zoekfunctie gedraaid, zoals in sectie 3, op 200 zoekopdrachten (100 Duits en 100 Oekraïens): zoals geschreven, en met één willekeurige typefout in een woord van elke zoekopdracht (195 zoekopdrachten veranderd). Elke zoekopdracht werd op vier manieren vertaald: de correcte vertaling (een bovengrens), het woordenboek zoals het was, het woordenboek met de eenvoudige terugvaloptie, en het woordenboek met de waarborgen. De vier gerangschikte lijsten werden samengevoegd met de gewichten van de app, en een taalmodel beoordeelde blind de samengevoegde topresultaten.
| Vertaling | Zoekopdrachten zoals geschreven eerste / top vijf, procentpunten | Eén typefout per zoekopdracht eerste / top vijf, procentpunten |
|---|---|---|
| Correct (bovengrens) | +0.5 / −1.0 | +15.0 / +11.5 |
| Woordenboek, eenvoudige terugvaloptie | +1.5 / +1.0 | +8.5 / +4.5 |
| Woordenboek, terugvaloptie met waarborgen | +2.0 / +0.5 | +7.5 / +4.0 |
Tabel 2. Verandering ten opzichte van het woordenboek zoals het was, in procentpunten van het aandeel zoekopdrachten met het juiste product eerst en in de top vijf.
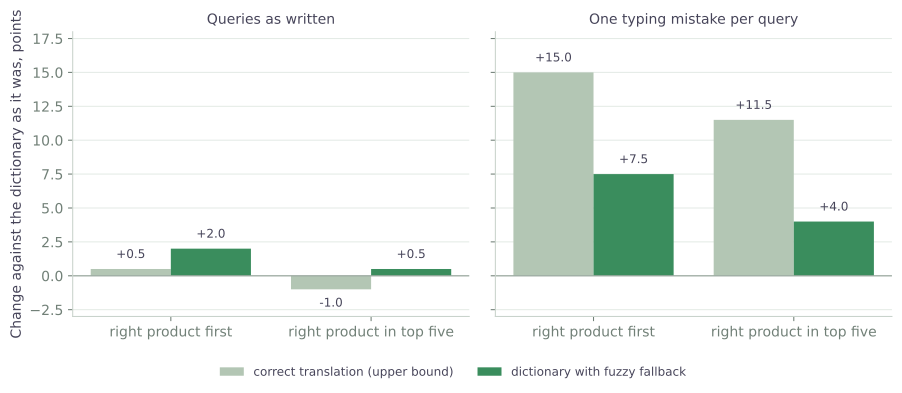
Op zoekopdrachten zoals geschreven is het woordenboek net zo goed als de correcte vertaling (een half procentpunt achter op de eerste plaats, een procentpunt voor in de top vijf), en de terugvaloptie verandert niets dat we kunnen detecteren (4 zoekopdrachten erbij en geen verloren op de eerste plaats, p = 0.13). Met een typefout verliest het woordenboek zoals het was 15 punten op de eerste plaats; de terugvaloptie met waarborgen herstelt er 7.5 van (30 erbij, 15 verloren, p = 0.04) en 4 van de 11.5 punten in de top vijf (11 erbij, 3 verloren, p = 0.06). De zoekfunctie die alleen de Engelse lijst van Open Food Facts gebruikt, wint veel meer, 22 procentpunten op de eerste plaats, omdat die geen eigen lijst heeft om op terug te vallen. De eenvoudige en de bewaakte terugvaloptie zijn in de hele zoekfunctie niet van elkaar te onderscheiden; we houden de bewaakte aan, omdat die minder juiste woorden verandert. De winst verschilt per taal: het Oekraïens wint 15 procentpunten op de eerste plaats, het Duits niets, en we hebben niet onderzocht waarom.
Stap 4: beperkingen van de meting
De fouten zijn synthetisch: één willekeurige bewerking in bijna elke zoekopdracht, veel vaker dan mensen werkelijk typefouten maken, en zonder de fouten van naburige toetsen op een echt toetsenbord. Tweehonderd zoekopdrachten en één model als beoordelaar geven p-waarden rond 0.05, dus het typefoutresultaat geeft de richting aan, maar de exacte grootte vraagt om echte zoekopdrachten. De winst per echte zoekopdracht is de bovenstaande winst maal het aandeel zoekopdrachten met een fout, dat we niet kennen; omdat de kosten voor correcte zoekopdrachten nagenoeg nul zijn, loont zelfs een klein aandeel.
10. Wat niet werkte, of niet nodig was
- Het verwijderen van de lokale Engelse lijst. Bij de tweede zoekset was de versie zonder die lijst niet beter dan de versie met vier lijsten (de top vijf 2 procentpunten lager, MRR .015 lager, binnen de ruis), dus hebben we de structuur behouden.
- Stemming vóór alignatie. Standaardadvies voor talen met rijke woordeindes; het verloor nauwkeurigheid in onze proeven. Exacte vormen plus frasen werkten beter.
- Een zeer groot gewicht voor taxonomieparen. Het hielp een beetje bij onbekende woorden in twee talen en verloor bij bekende woorden. Het bruikbare bereik is smal, en we blijven erbinnen.
- Taxonomiedekking als gewicht van een lijst. Ze meet de vertaalkwaliteit in die taal, en het aantal producten dat in die taal bestaat is een afzonderlijke grootheid.
- Een test die het effect niet kon zien. Onze eerste taxonomietest keek naar woorden die de basis al kende en liet de taxonomie nutteloos lijken. De les is te vragen wat een test kan zien, voordat je een nulresultaat vertrouwt.
Zo gebruiken we dit in MuscleTiger
De voedselzoekfunctie in MuscleTiger werkt zoals beschreven: je zoekopdracht gaat naar onze eigen basis en naar Open Food Facts, in jouw taal en in het Engels. De zoekopdracht wordt vertaald door een woordenboek dat op je telefoon staat, en de vier rangschikkingen worden samengevoegd met gewichten die van je taal afhangen. Resultaten worden getoond in de interfacetaal van de app, en producten die in jouw land worden verkocht worden vooraan gezet. Het woordenboek werkt zonder netwerk, dus een zoekopdracht in de sportschool zonder bereik vindt nog steeds voedingsmiddelen in onze lokale basis.
Conclusies
- De zoekfunctie vindt het bedoelde voedingsmiddel bij 92% van de zoekopdrachten. In een test van de hele zoekfunctie in negen talen staat het bij 90% in de eerste tien resultaten en bij 67% op de eerste plaats; losse producten worden iets vaker gevonden dan gerechten.
- Vertaling naar het Engels is wat telt. Met correcte vertalingen verhoogde het toevoegen van de Engelse lijst het aandeel Oekraïense zoekopdrachten met het juiste product in de top vijf met 61 procentpunten ten opzichte van Open Food Facts alleen in het Oekraïens; verdere talen veranderden weinig en verlaagden, na vier, de top vijf.
- Voor voedselzoekopdrachten kan een klein woordenboek het werk van de vertaler doen. Woordalignering op onze eigen parallelle namen levert een bestand van enkele honderden kilobytes per taal, offline, en reproduceert onze referentievertalingen van korte zoekopdrachten met een woordstam-F1 van 0.94 tot 0.96. Dat is de nauwkeurigheid van het vertalen van eenvoudige zoekopdrachten; de nauwkeurigheid van de zoekfunctie wordt apart gemeten en is lager.
- De openbare taxonomieën helpen het meest waar onze eigen data zwijgen. Het trainen van het woordenboek erop verbeterde de vertaling van afgehouden zeldzame termen met twee tot vijf punten in de talen met een grote taxonomie, tegen een kleine prijs bij veelvoorkomende termen.
- Het gewicht van elke lijst kan afhangen van hoe groot de taal is in OFF. Voor het Duits verhoogde de wijziging de MRR met .062 op onze zoekopdrachten; voor het Oekraïens veranderde niets.
- Een terugvaloptie voor typefouten loont. Met een typefout daalt de eerste plaats met 15 punten wanneer de vertaler alleen exacte vormen kent, en een terugvaloptie met waarborgen (zelfde stam, daarna een kleine bewerkingsafstand) herstelt de helft ervan; voor zoekopdrachten zoals geschreven kost het niets dat we kunnen meten.
- Matching was belangrijker dan talen. Woorden wegen naar zeldzaamheid, stemming en één getalnotatie gaf de grootste winst van de studie.
Beperkingen. De zoekopdrachten zijn door ons geschreven en door een taalmodel beoordeeld, dus de marges zijn breed (ongeveer punten bij 200 zoekopdrachten). De getallen gelden voor het Duits en het Oekraïens; de gewichten van de andere talen zijn geëxtrapoleerd. We hebben niet vergeleken met de neurale vertaler of met andere apps. De volgende stap is een controle op echte zoekopdrachten van gebruikers.
Gegevens en licenties
Productgegevens en taxonomieën komen van Open Food Facts, beschikbaar gesteld onder de Open Database Licence (ODbL); de woordenboeken die hier worden beschreven zijn deels afgeleid van de OFF-taxonomieën en dragen dezelfde naamsvermelding. Onze lokale basis is gebouwd uit open nationale voedingssamenstellingstabellen die door overheidsinstanties zijn gepubliceerd; hun bronnen en licenties staan in de app. We danken de bijdragers aan Open Food Facts en de beheerders van de nationale tabellen.
Bronnen
- Brown PF, Della Pietra SA, Della Pietra VJ, Mercer RL. The mathematics of statistical machine translation: parameter estimation. Computational Linguistics 1993;19(2):263–311. ACL Anthology
- Moore RC. Improving IBM word-alignment Model 1. Proceedings of ACL 2004:518–525. ACL Anthology
- Cormack GV, Clarke CLA, Büttcher S. Reciprocal rank fusion outperforms Condorcet and individual rank learning methods. Proceedings of SIGIR 2009. doi:10.1145/1571941.1572114
- Darwish K, Oard DW. Probabilistic structured query methods. Proceedings of SIGIR 2003.
- Dyer C, Chahuneau V, Smith NA. A simple, fast, and effective reparameterization of IBM Model 2. Proceedings of NAACL-HLT 2013:644–648. ACL Anthology
- Open Food Facts: taxonomies of ingredients and categories and product data, world.openfoodfacts.org, under the Open Database Licence (ODbL).
- Riley D, Gildea D. Improving the IBM alignment models using variational Bayes. Proceedings of ACL (short papers) 2012:306–310. ACL Anthology
- Östling R, Tiedemann J. Efficient word alignment with Markov chain Monte Carlo. The Prague Bulletin of Mathematical Linguistics 2016;106:125–146.
- Mermer C, Saraçlar M. Bayesian word alignment for statistical machine translation. Proceedings of ACL (short papers) 2011:182–187. ACL Anthology
- Jalili Sabet M, Dufter P, Yvon F, Schütze H. SimAlign: high quality word alignments without parallel training data using static and contextualized embeddings. Findings of EMNLP 2020.