Notatki badawcze MuscleTiger · Nr 5
Wyszukiwanie jedzenia w każdym języku: tłumaczenie zapytań, łączenie baz i wyniki pomiarów
Wpisujesz w dzienniku posiłków „Spiegelei mit Speck” albo „борщ з м’ясом” i spodziewasz się zobaczyć produkt z kaloriami i makroskładnikami. Największe otwarte bazy produktów spożywczych są w większości po angielsku i po francusku, a ludzie szukają w swoim języku, z nazwami marek, różnymi końcówkami wyrazów i literówkami. Ta notatka opisuje, jak zbudowaliśmy wyszukiwanie jedzenia w MuscleTiger, co wypróbowaliśmy, co okazało się niepotrzebne i co zmierzyliśmy.
W skrócie
Nasza wyszukiwarka żywności znajduje szukany produkt dla 92% zapytań w dziewięciu językach (sekcja 3). Przeszukujemy naraz cztery listy (naszą bazę produktów po angielsku i w języku użytkownika oraz Open Food Facts w języku użytkownika i po angielsku) i łączymy rankingi metodą reciprocal rank fusion. Zapytanie w innym języku najpierw tłumaczymy na angielski. Najpierw używaliśmy neuronowego tłumacza działającego na urządzeniu, potem zastąpiliśmy go małym słownikiem nauczonym z naszych równoległych nazw produktów, za pomocą aligneru słów z rodziny IBM Model 2 z bayesowskim priorem, oraz z taksonomii Open Food Facts. Na naszych zapytaniach testowych słownik odtwarza referencyjne angielskie tłumaczenie z wynikiem F1 na rdzeniach wyrazów 0.94 (niemiecki) i 0.96 (ukraiński). To mierzy tłumaczenie krótkich, prostych zapytań. Przy poprawnych tłumaczeniach dodanie listy angielskiej podnosi o 61 punktów udział zapytań ukraińskich, w których właściwy produkt jest w pierwszej piątce, a kolejne języki dokładają niewiele. Wagi czterech list, zależne od tego, jak duży jest dany język w Open Food Facts, poprawiły wynik dla niemieckiego i nie zmieniły ukraińskiego. Zapasowe dopasowanie dla literówek w tłumaczu odzyskuje około połowy z 15 punktów, które kosztuje błąd.
Wyjaśniamy podejście i rodziny metod, które rozważaliśmy.
1. Problem: zapytanie w jednym języku, dane w kilku
Wyszukiwanie jedzenia musi dobrze robić trzy rzeczy naraz. Musi zrozumieć krótkie i niechlujne zapytanie („chicken breast 200g”, „coca cola zero”, „мигдальне молоко”). Musi znaleźć produkt, który ma pełne i wiarygodne wartości odżywcze. I musi działać w języku człowieka, na telefonie, szybko, najlepiej offline.
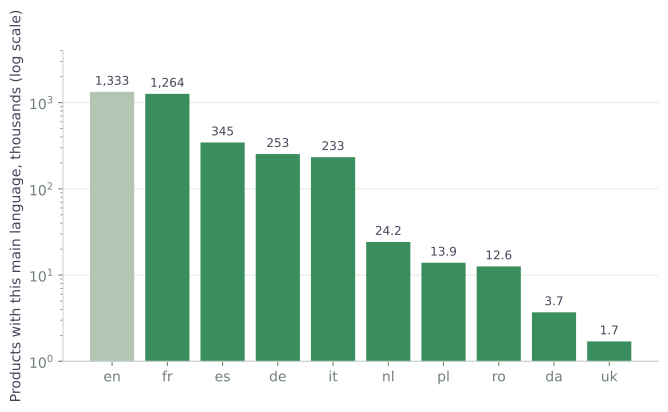
Dane, z których możemy korzystać, są nierówne. Open Food Facts (OFF) [6], otwarta baza produktów pakowanych, ma miliony produktów, ale język produktu zależy od kraju sprzedaży i od nawyków osób, które dodają dane. Liczone według głównego języka produktu (OFF, 15 listopada 2026), angielski i francuski prowadzą z około 1.3 miliona produktów każdy, hiszpański, niemiecki i włoski mają od 230 do 350 tysięcy, a mniejsze języki, które obsługujemy, mają od 1.7 do 25 tysięcy (rysunek 1). Zapytanie po ukraińsku może więc mieć odpowiedź w tym języku od bardzo niewielu produktów, podczas gdy zapytanie po francusku trafia w bazę, która od początku jest w większości francuska.
Nasza własna baza
Drugim źródłem jest nasza baza produktów spożywczych z pełną energią i makroskładnikami. Powstała jako połączenie kilku narodowych tabel składu żywności, wybranych dlatego, że są otwarte, mierzone w laboratoriach i kompletne pod względem makroskładników. Wiele jej produktów ma porcje domowe, takie jak „1 slice”. Produkt jest pomijany, gdy o tej samej nazwie jest już w bazie, a nowe wiersze zawsze dopisujemy na końcu, więc numer produktu i jego tłumaczeń nigdy się nie zmienia, gdy dodajemy tabelę.
Gdy później dodaliśmy trzy kolejne tabele, udział zapytań testowych, w których właściwy produkt jest w pierwszej piątce, wzrósł o 3 punkty, a na pierwszym miejscu o 2 punkty; żadna z tych zmian nie jest istotna. Zysk pochodził głównie z popularnych dań, które nowe tabele opisują prostym angielskim, jak lasagna, cappuccino czy Greek yoghurt. Pominęliśmy jedną z rozważanych tabel, bo jej licencja zawiera klauzulę share-alike, która mogłaby objąć naszą scaloną bazę.
Tabele są napisane po angielsku albo w języku swojego kraju, więc nazwy w pozostałych językach trzeba było wytworzyć. Nazwy angielskie są oryginałem; nazwy w innych językach powstały w tłumaczeniu maszynowym i częściowo zostały później poprawione przez agentów opartych na modelach językowych, z automatycznymi kontrolami (walidator odrzuca odpowiedź, która zmienia liczby, jednostki lub strukturę nazwy). Liczby w nazwach używają kropki dziesiętnej we wszystkich językach, zarówno w bazie, jak i w zapytaniu, dzięki czemu zapytanie z procentem tłuszczu może preferować produkt o tym procencie.
2. Cztery listy i jeden ranking
Zasada, której używamy, jest prosta do opisania. Każde zapytanie szukamy w czterech miejscach:
- A: nasza baza lokalna, z zapytaniem przetłumaczonym na angielski;
- B: nasza baza lokalna, z zapytaniem wpisanym w języku użytkownika;
- C: Open Food Facts, przeszukiwane w języku użytkownika;
- D: Open Food Facts, przeszukiwane z angielskim tłumaczeniem.
Każda lista zwraca własny ranking, a rankingi łączymy metodą reciprocal rank fusion (RRF) [3]. Produkt, który pojawia się blisko szczytu w kilku listach, wygrywa z produktem, który jest pierwszy tylko na jednej liście:
gdzie to pozycja produktu na liście , to waga listy, a to mała stała, która nie pozwala, by pierwsze miejsce zdominowało wynik. Metoda nie potrzebuje wyników z list, tylko ich kolejności, co ma znaczenie, bo listy pochodzą z różnych systemów o nieporównywalnych wynikach. Wybraliśmy ją właśnie z tego powodu; Cormack i in. podają, że w ich eksperymentach jest konkurencyjna wobec bardziej złożonych metod uczenia rankingu [3].
RRF to opublikowana metoda, a nasz wkład to pomiar: które listy włączyć, jak tłumaczyć zapytanie i jak bardzo ufać każdej liście w każdym języku.
3. Jak mierzyliśmy
Protokół:
- Przygotowaliśmy zbiory zapytań w kilku typach: marka plus produkt, danie, codzienne jedzenie, napój, a także zapytania nieformalne i z błędami. Jeden zbiór ma 959 zapytań, z których 200 oceniono szczegółowo; drugi ma 200 zapytań, 100 po niemiecku i 100 po ukraińsku, po 20 w każdym typie. Osobny zbiór dań z kuchni zagranicznych (na przykład japońskie danie pytane po niemiecku) sprawdza, czy język zapytania ma iść za daniem.
- Dla każdego zapytania zebraliśmy najlepsze wyniki każdej konfiguracji, a model językowy ocenił każdego kandydata jako trafnego albo nietrafnego. Model widział zapytanie i angielskie tłumaczenie, a konfiguracji, która zwróciła kandydata, nie znał. Nie mógł więc faworyzować żadnej metody.
- Raportujemy top-1 (właściwy produkt jest pierwszy), top-5 (jest wśród pierwszych pięciu) i MRR, czyli średnią z pierwszego trafnego wyniku. Porównania konfiguracji robimy, parując wyniki według zapytania, i używamy testu znaków oraz przedziałów bootstrapowych.
Dokładność całego wyszukiwania
Liczba z podsumowania pochodzi z testu wyszukiwania dokładnie w takiej postaci, w jakiej działa w aplikacji. Napisaliśmy po dziesięć zapytań w każdym z dziewięciu języków, które aplikacja obsługuje poza angielskim, po dwa z każdego typu, razem 90 zapytań. Każde zapytanie przeszło te same kroki co na telefonie: tłumaczenie słownikiem, nasza baza po angielsku i w języku zapytania, Open Food Facts w obu językach, gdzie produkty sprzedawane w kraju tego języka trafiają na początek, oraz fuzja z wagami aplikacji. Przeczytaliśmy całą scaloną listę każdego zapytania, średnio około sześćdziesięciu wyników, i ręcznie zaznaczyliśmy pierwszy wynik, który użytkownik przyjąłby jako szukany produkt, według tych samych zasad co ślepy sędzia.
| Szukany produkt znaleziono | Wszystkie zapytania (90) | Pojedyncze produkty (65) | Dania (25) |
|---|---|---|---|
| gdziekolwiek na liście | 92.2% | 93.8% | 88.0% |
| wśród pierwszych dziesięciu | 90.0% | 90.8% | 88.0% |
| wśród pierwszych pięciu | 85.6% | 86.2% | 84.0% |
| na pierwszym miejscu | 66.7% | 67.7% | 64.0% |
Dokładność całego wyszukiwania. Po dziesięć zapytań w każdym z dziewięciu języków, wyszukiwanych jak w aplikacji. Pojedyncze produkty to żywność, produkty pakowane i napoje; do dań należą też posiłki złożone, takie jak kanapka z serem czy płatki owsiane z mlekiem.
Szukany produkt jest gdzieś na liście dla 92% zapytań, wśród pierwszych dziesięciu wyników dla 90%, wśród pierwszych pięciu dla 86% i na pierwszym miejscu dla 67%. Pojedyncze produkty są znajdowane nieco częściej niż dania (94% wobec 88% gdziekolwiek na liście). Chybienia to głównie produkty markowe, których nie ma na żadnej liście, oraz przekąski z kilku produktów, dla których listy podają składniki, ale nie samą przekąskę. Dziesięć zapytań na język to mała podstawa: jedno zapytanie przesuwa wynik języka o dziesięć punktów, więc liczby opisują wyszukiwanie jako całość i niewiele mówią o pojedynczym języku. Kolejne sekcje rozkładają wyszukiwanie na części i mierzą każdy krok na większych zestawach zapytań po niemiecku i ukraińsku.
4. Co daje poprawne tłumaczenie wyszukiwaniu
Zanim opiszemy próby zbudowania dobrego tłumacza, zmierzyliśmy, ile warte jest dobre tłumaczenie. Napisaliśmy 100 zapytań o jedzenie po ukraińsku (po 20 z każdej kategorii: codzienne produkty, dania, napoje, marki i zapytania nieformalne) i przetłumaczyliśmy każde ręcznie na pozostałe dziewięć języków, tak że tłumaczenie jest poprawne z założenia. Dla każdego języka przeszukiwaliśmy Open Food Facts zapytaniem w tym języku i łączyliśmy listy metodą reciprocal rank fusion (równanie 1, równe wagi). Pierwsza konfiguracja to sam ukraiński, druga dodaje angielski, a potem dokładaliśmy francuski, hiszpański, niemiecki, włoski, niderlandzki, polski, rumuński i duński, w kolejności liczby produktów w OFF (rysunek 2). Trafność oceniał model językowy w ślepej próbie, według zasad z sekcji 3, na połączonej puli pierwszych pięciu wyników każdej konfiguracji.
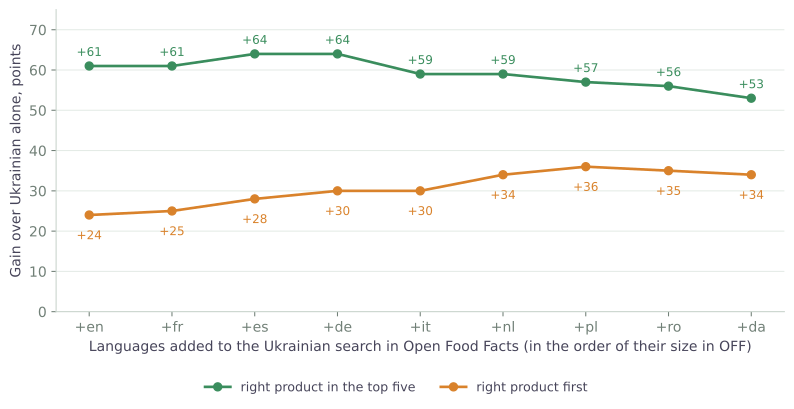
Pierwszy krok jest zdecydowanie największy. Samo przeszukiwanie OFF po ukraińsku często nie znajduje niczego: OFF ma niewiele produktów z ukraińskim opisem (rysunek 1), a dla 47 z 100 zapytań lista ukraińska była pusta. Dodanie angielskiego tłumaczenia podnosi udział zapytań z właściwym produktem w pierwszej piątce o 61 punktów, a na pierwszym miejscu o 24 punkty, przy 61 zapytaniach zyskanych i żadnym straconym.
Kolejne języki zmieniają niewiele. Francuski nie zmienia pierwszej piątki (5 zapytań zyskanych, 5 straconych). Hiszpański i niemiecki dodają jeszcze 3 punkty, w granicach szumu. Potem pierwsza piątka spada o 11 punktów od szczytu przy wszystkich dziesięciu językach, podczas gdy pierwsze miejsce rośnie jeszcze o 10 do 12 punktów. Spadek z czterech do dziesięciu języków w pierwszej piątce jest istotny na tych zapytaniach (2 zyskane, 13 straconych, test znaków p = 0.007); wzrost pierwszego miejsca z dwóch do dziesięciu języków nie jest istotny (20 zyskanych, 10 straconych, p = 0.10). Marki zachowują się inaczej niż codzienne produkty: przy większej liczbie list zapytania o markę są znajdowane częściej (o 15 punktów więcej w pierwszej piątce po dodaniu hiszpańskiego niż samym angielskim), a codzienne produkty rzadziej (o 25 punktów mniej przy dziesięciu językach niż z angielskim). Dwadzieścia zapytań na typ to mała próba, więc te podziały są orientacyjne.
Poprawne tłumaczenie na angielski niesie ten efekt. Każdy kolejny język to kolejne zapytanie do OFF i, poza pierwszymi kilkoma, rozmywa ranking.
Dania z innej kuchni
Krok do angielskiego ma największe znaczenie, gdy danie pochodzi z innej kuchni. Osobny zbiór 100 zapytań, po dziesięć w każdym z dziesięciu języków, nazywał znane zagraniczne danie tak, jak wpisałby je użytkownik: Borschtsch dla użytkownika niemieckiego, paella, pierogi, tiramisu, stroopwafel, sarmale. To starszy eksperyment, a zapytania tłumaczył neuronowy tłumacz, którego aplikacja używała wtedy (sekcja 5). Dla 90 zapytań nieangielskich tłumaczenie na angielski podnosiło udział zapytań z daniem w pierwszej piątce o 34 punkty względem wyszukiwania w Open Food Facts w języku użytkownika (47 zapytań zyskanych, żadnego straconego, p < 0.001). Dodawanie kolejnych języków po angielskim nie zmieniało pierwszej piątki, nawet gdy język kraju pochodzenia dania wybieraliśmy z góry.
Nasza baza lokalna pomagała tutaj: bez jej listy angielskiej pierwsze miejsce spadało o 8 punktów na tych zapytaniach (7 straconych, żadne zyskane, p = 0.016), bo baza zna paellę, ratatouille czy lasagnę i ustawia je na pierwszym miejscu. Przy codziennych produktach nie wykazała takiej korzyści, ale jej usunięcie też nie poprawiało wyszukiwania (sekcja 10), więc ją zachowujemy. Pozostałe chybienia to dania, których żadna lista OFF nie ma pod żadną nazwą, jak sarmale. Zbiór ma tylko około dwudziestu różnych dań, więc opisuje dobrze znane dania i niewiele mówi o rzadkich.
Dopasowanie słów ważyło więcej niż języki
Najważniejsze pojedyncze ulepszenie całego badania wzięło się z dopasowywania słów w lokalnej bazie, bez żadnego tłumaczenia. Lokalna baza jest przeszukiwana własnym dopasowaniem, a słowa funkcyjne, końcówki przypadków i przecinki dziesiętne psuły je: „soup with mushrooms” po ukraińsku nie zwracało niczego, bo dopasowanie wymagało, by każde słowo zapytania zostało znalezione dokładnie tak, jak wpisano. Ważenie słów zapytania ich rzadkością (IDF), stemmer Snowball dla języków, które go mają, i jeden format liczb poprawiły top-5 w standardowym zbiorze o około 9% od początku badania (test znaków p = 0.008), a na zapytaniach z przyimkami i formami wyrazów o około 12%.
5. Dlaczego wymieniliśmy tłumacza
Usunęliśmy ML Kit, bo słabo tłumaczy nazwy produktów. To tłumacz ogólnego przeznaczenia, zbudowany do zdań, a nazwa produktu to kilka słów bez kontekstu: marka, stan produktu, danie nazwane od miejsca. Najpierw przetłumaczyliśmy nim naszą bazę, a oto prawdziwe wpisy (tłumaczenia ukraińskie i francuskie, z objaśnieniem dla czytelników, którzy nie znają tych języków):
| Nazwa angielska | Wynik ML Kit | Co poszło źle |
|---|---|---|
| plain, refrigerated | рівнина, холодильна (ukraiński) | „plain” znaczy tu niedoprawiony, jak w plain yoghurt, a tłumacz oddał je jako „рівнина” (równina); „refrigerated” stało się przymiotnikiem znaczącym „z lodówki” |
| boneless | безкімнатний (ukraiński) | znaczy „bez pokojów”; zamierzone znaczenie to „bez kości” |
| Pad Thai | Подушка тайська (ukraiński) | nazwę dania odczytano jako słowa: „tajska poduszka” |
| Rice flour, brown | Рисова борошно, коричневий (ukraiński) | przymiotniki nie zgadzają się z rzeczownikiem „mąka”, co w ukraińskim jest błędem gramatycznym |
| Meringue with chocolate; Ham salad spread | pozostawione częściowo lub w całości nieprzetłumaczone (ukraiński) | angielskie słowa zostają w nazwie |
| bun | chignon (francuski) | upięcie włosów (fryzura), a chodziło o bułkę |
| sauerkraut | chouchoune (francuski) | inne słowo; francuskie słowo na kapustę kiszoną to choucroute |
Ta sama słabość uderza w zapytania, gdzie złe słowo oznacza brak produktu, i nie da się jej naprawić lokalnie: w modelu neuronowym nie poprawi się jednego słowa. Były też dwa mniejsze powody: modele zajmują około 40 MB na język, a SDK to komponent zewnętrznego dostawcy.
Dane, które posiadamy, wskazują lepsze narzędzie. Nasza baza ma pary angielskiej nazwy i jej nazwy w każdym języku, czyli równoległy korpus dokładnie w naszej dziedzinie. Słownik można nauczyć się z takiego korpusu.
6. Słownik nauczony przez dopasowanie słów
Nauczenie słownika z tekstu równoległego to dawny problem dopasowywania słów (word alignment): ustalenia, które słowo jednego zdania odpowiada któremu słowu drugiego. Klasyczną rodziną są modele IBM ze statystycznego tłumaczenia maszynowego [1]. Model 1, najprostszy i nasz punkt wyjścia, traktuje nazwę w jednym języku jako wygenerowaną ze słów drugiego, bez względu na kolejność. Dla angielskiej nazwy i nazwy w innym języku (z dodanym pustym słowem) prawdopodobieństwo pary wynosi
a tablica prawdopodobieństw tłumaczenia słów , czyli słownik, jest szacowana algorytmem EM (oczekiwanie–maksymalizacja): w każdej rundzie każda para słów w parze nazw dostaje udział w liczniku proporcjonalny do bieżącego prawdopodobieństwa, a udziały są normalizowane do nowych prawdopodobieństw. Dla krótkiej nazwy produktu to dobre dopasowanie, bo jest tu mało kolejności słów do modelowania. Jego znaną słabość opisał Moore [2]: rzadkie słowo może przyjąć dowolne prawdopodobieństwo, które pasuje do jego jednego zdania, więc rzadkie słowa stają się „zbieraczami śmieci” dopasowanymi do zbyt wielu słów. Moore zaproponował wygładzanie liczników i lepszą inicjalizację; bayesowski prior na prawdopodobieństwach tłumaczenia, stosowany wariacyjną inferencją, to kolejne lekarstwo [7].
Co rozważaliśmy i zmierzyliśmy
Porównaliśmy nasz aligner z jego wariantami z wyłączonymi elementami, z implementacjami referencyjnymi dwóch opublikowanych alignerów oraz z metodą bez żadnego modelu dopasowania. Każda metoda dostała te same pary nazw, te same 5% danych odłożonych do testu i ten sam sposób zamiany dopasowań na słownik (para słów liczy się, gdy jest połączona co najmniej dwa razy; każde słowo dostaje swoje najczęstsze tłumaczenie). Jakość to F1 rdzeni wyrazów między tłumaczeniem słownikowym odłożonej nazwy, słowo po słowie, a jej angielską nazwą, uśredniona po dziewięciu językach (tabela 1). Różnice są małe, więc podajemy też, w ilu z dziewięciu języków różnica jest wyraźna (95% przedział bootstrapowy różnicy sparowanej nie obejmuje zera).
| Metoda | Co to jest | Średnie F1 | Względem naszej |
|---|---|---|---|
| Dice coefficient | bez modelu dopasowania, każde słowo łączy się z tym słowem, z którym najczęściej współwystępuje | 0.812 | gorsza w 7 z 9 |
| IBM Model 1 [1], EM | prawdopodobieństwa tłumaczenia słów, bez kolejności słów | 0.817 | gorsza w 6 z 9 |
| Model 1 z priorem Dirichleta [7] | wariacyjny Bayes na prawdopodobieństwach tłumaczenia | 0.822 | gorsza w 4 z 9 |
| Prior dyagonalny w wyrównaniu, EM | Model 2 w parametryzacji fast_align [5], bez bayesowskiego priora | 0.822 | gorsza w 6 z 9 |
| Nasza | prior dyagonalny i prior Dirichleta, dwa kierunki, przecięcie | 0.825 | – |
| Nasza, grow-diag-final-and | to samo, z połączeniami obu kierunków złączonymi standardową heurystyką | 0.828 | lepsza w 5 z 9, gorsza w 1 |
| fast_align [5] | implementacja autorów, przecięcie / grow-diag-final-and | 0.826 / 0.831 | 3 lepsze, 2 gorsze / 7 lepszych |
| eflomal [8] | HMM z płodnością, bayesowski, próbkowanie MCMC; przecięcie / grow-diag-final-and | 0.825 / 0.828 | 2 lepsze, 2 gorsze / 7 lepszych |
| SimAlign [10] | wielojęzyczne osadzenia BERT, bez treningu na naszych nazwach; trzy metody dopasowania (najlepsza / iteracyjna / przecięcie) | 0.824 / 0.822 / 0.812 | 2 lepsze, 2 gorsze / 1 lepsza, 3 gorsze / gorsza w 8 |
Tabela 1. Aligner porównane na odłożonych nazwach naszej bazy, dziewięć języków. Ostatnia kolumna liczy języki, w których różnica względem naszego jest wyraźna. fast_align i eflomal to implementacje autorów.
Sam współczynnik Dice jest tylko o 0.013 poniżej naszego, a SimAlign, który nie wymaga treningu na naszych nazwach, dorównuje nam w najlepszym ustawieniu. Przy krótkich, prawie równoległych nazwach wybór alignera ma niewielkie znaczenie, a większość jakości pochodzi z samych nazw. Każdy nasz składnik dodaje trochę, a prawdziwy fast_align z tym samym przecięciem daje ten sam wynik (0.826 wobec 0.825), czego się spodziewamy od metody o tej samej konstrukcji. Łączenie obu kierunków standardową heurystyką grow-diag-final-and, w porównaniu z przecięciem, pomaga mniej więcej tak samo jak wybór modelu: między ćwiartką a połową punktu F1 we wszystkich trzech wariantach. To mały zysk, wyraźny w większości języków, i planujemy go użyć przy następnej przebudowie słowników.
Redukowanie wyrazów do rdzeni Snowball przed dopasowaniem obniża F1 (0.818, gorsza w 6 z 9 języków), a zachowanie tylko pierwszych czterech liter każdego wyrazu, które Östling i Tiedemann opisują jako użyteczne przybliżone stemmowanie w tłumaczeniu maszynowym [8], obniża go znacznie bardziej (0.743). Zadanie tłumaczy tę różnicę: Östling i Tiedemann mierzą systemy tłumaczenia zbudowane na dopasowaniach, a my sprawdzamy w słowniku pojedyncze słowa nazwy produktu, gdzie łączenie form wyrazów łączy różne produkty.
Nie uruchamialiśmy próbnika Gibbsa Mermera i Saraçlara [9] (w pełni bayesowski Model 1), modeli IBM 3–5 ani probabilistycznych zapytań strukturalnych Darwisha i Oarda [4], które zachowują kilka tłumaczeń dla każdego słowa. Ostatnie z nich to możliwy kolejny krok, bo nasz słownik zachowuje tylko najlepszego kandydata.
Czym jest nasz aligner
Nasz aligner to własna implementacja modelu IBM 2 w parametryzacji fast_align [5]: prawdopodobieństwo, że słowo jest dopasowane do danej pozycji, maleje z odległością od przekątnej (w Modelu 1 jest jednakowe), bo nazwy produktów zwykle zachowują kolejność słów między językami. Ponadto prawdopodobieństwa tłumaczenia słów dostają rzadki prior Dirichleta z wnioskowaniem wariacyjnym [7], jak w fast_align, co nie pozwala rzadkim słowom pochłaniać prawdopodobieństwa. Stałe (prawdopodobieństwo dopasowania słowa do niczego, siła priora i początkowa stromość przekątnej) to wartości, które podają Dyer i in.; fast_align dodatkowo ponownie szacuje stromość w trakcie treningu, a my tego nie robimy. Model trenujemy w obu kierunkach i zachowujemy tylko połączenia, na które zgadzają się oba kierunki (przecięcie), co podnosi precyzję kosztem czułości. Słowa dopasowujemy w ich dokładnych formach, bez stemmowania: redukcja do rdzeni, typowa dla języków z bogatą fleksją, obniżyła dokładność w naszych pierwszych próbach, więc złożenia i słowa z łącznikiem obsługujemy przez frazy.
Wynikiem jest słownik w trzech warstwach, które tłumacz stosuje od najdłuższego dopasowania do trzech słów: wpisy taksonomii, frazy dopasowane w naszej bazie i pojedyncze słowa dopasowane w naszej bazie. Słowo, którego nie ma w słowniku, jak marka czy literówka, przechodzi bez zmian, bo OFF często je zna. Każdy język to plik o rozmiarze kilkuset kilobajtów, wobec około 40 MB na język dla modeli neuronowych. Działa offline, a każde tłumaczenie można prześledzić do wiersza słownika i poprawić.
Jak dobre jest tłumaczenie
Mierzymy tłumacza na dwa sposoby. Na 5% par nazw odłożonych z treningu tłumaczenie obcej nazwy słowo po słowie i porównanie z angielską nazwą przez rdzenie wyrazów daje F1 między 0.78 a 0.90 w dziewięciu językach. Na zapytaniach ewaluacyjnych, do których napisaliśmy angielskie tłumaczenie referencyjne, F1 rdzeni wyrazów wynosi 0.94 dla niemieckiego (88 z 100 zapytań identycznych po rdzeniach) i 0.96 dla ukraińskiego (89 z 100).
Te liczby opisują tłumaczenie krótkich, popularnych zapytań na angielski. Jakość samego wyszukiwania jest niższa i mierzymy ją osobno (sekcje 3 i 9). Nie uruchamialiśmy starego neuronowego tłumacza na tych samych zapytaniach, więc nie twierdzimy, że słownik jest lepszy niż ML Kit; jest wystarczająco dokładny na tych zapytaniach, mały, działa offline i można go poprawić.
7. Taksonomie Open Food Facts: co dają i co kosztują
OFF utrzymuje publiczne taksonomie składników i kategorii: hierarchiczne listy, w których każdy wpis ma angielską nazwę oraz nazwy i synonimy w wielu językach, pisane przez wolontariuszy. Mają tysiące wpisów z angielską nazwą i są atrakcyjne z trzech powodów: tłumaczenia wykonują ludzie i w dziedzinie żywności, zawierają słowa, których nasze nazwy nigdy nie używają (rzadkie składniki), i są niezależne od tłumaczenia maszynowego, które wytworzyło nasze nazwy.
Trudności:
- Nierówne pokrycie. Udział wpisów z nazwą w danym języku waha się od 1.6% (kategorie ukraińskie) do 84.6% (kategorie francuskie), więc taksonomia nie może być jedynym źródłem. Stosujemy ją najpierw, tam gdzie wpis istnieje, a słownik z naszej bazy uzupełnia resztę.
- Nazwy w stylu kategorii i wiele synonimów. Wpis ma jedną angielską nazwę i wiele synonimów w danym języku. Każdy synonim jest parowany z główną nazwą angielską, a bardzo długie nazwy angielskie są pomijane.
- Frazy, a nie tylko słowa. Nazwy w taksonomii to frazy, więc tłumacz na każdej pozycji dopasowuje najdłuższą frazę przed pojedynczymi słowami.
- Szum. Gdy taksonomia jest także danymi treningowymi, jej frazy kategorii konkurują z idiomatycznymi frazami z naszej bazy. Wagę par z taksonomii trzeba było zmierzyć: zbyt duża waga obniżała dokładność na częstych słowach, a zakres, który działa, jest wąski.
Trening na taksonomii: test, który nie widział efektu
Nasz pierwszy test dodania par z taksonomii do treningu dopasowań nie pokazał nic. Mierzyliśmy go na odłożonych nazwach z naszej bazy i na naszych zapytaniach, a jakość tłumaczenia zmieniała się najwyżej o kilka tysięcznych. Prawie uznaliśmy, że taksonomia jest przydatna tylko jako wyszukiwanie. Ten test jednak nie mógł zobaczyć efektu: oba zbiory zawierają słowa, które nasza baza już zna, a sens taksonomii polega na dodawaniu słów, których ona nie zna.
Uczciwy test usuwa co dziesiąty wpis taksonomii z warstwy wyszukiwania i z treningu, buduje słownik z treningiem na taksonomii i bez niego, i tłumaczy nazwy usuniętych wpisów. Dla języków z dużą taksonomią trening dodaje od dwóch do czterech punktów F1 na wszystkich odłożonych nazwach i od czterech do pięciu punktów na nazwach ze słowem, którego nasza baza nie ma, bez straty na nazwach złożonych ze znanych słów (rysunek 3). Dla języków z małą taksonomią, jak ukraiński i rumuński, nic się nie zmienia. Odwróciliśmy nasze wczesne zalecenie i słowniki w aplikacji są budowane z treningiem na taksonomii.
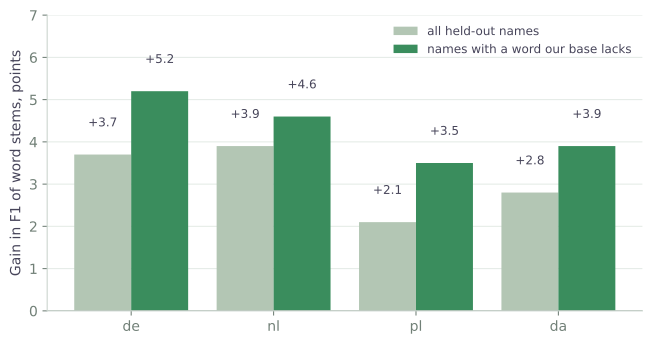
Gdzie może zaszkodzić. Nazwy z taksonomii są w stylu kategorii, a ich synonimy mogą wyprzeć idiomatyczną frazę nauczoną z naszej bazy („home fries” dla dania z smażonych ziemniaków). Dla zapytań niemieckich kosztowało to około jednego punktu F1, a dla ukraińskich nic, i przyjęliśmy tę cenę za zysk na rzadkich słowach.
8. Wagi czterech list według języka
W równaniu (1) każda lista ma wagę. Nasze pierwsze wagi były takie same dla wszystkich języków, dostrojone na jednym zbiorze zapytań. Jakość list różni się jednak między językami. Natywna lista C w OFF jest bogata we francuskie czy niemieckie produkty, a uboga w ukraińskie, gdzie większy ciężar niesie lista angielska D. Nadanie każdemu językowi własnych wag to naturalny pomysł, a pytanie brzmi, skąd je wziąć dla dziesięciu języków, skoro zapytania testowe mamy dla dwóch.
Rozważaliśmy dwie miary. Pierwsza to udział wpisów taksonomii, które mają nazwę w danym języku. Łatwo ją policzyć, ale mierzy, jak dobrze wolontariusze przetłumaczyli słownictwo, co wpływa na słownik, a niewiele mówi o tym, ile produktów ma nazwę w tym języku; jej dwie kolumny nawet nie zgadzają się ze sobą (włoski: 75% składników i 28% kategorii). Nie użyliśmy jej. Druga to liczba produktów OFF w danym języku względem angielskiego, dostępna w usłudze wyszukiwania (rysunek 1). To przybliżenie, bo główny język produktu może różnić się od języka pola nazwy, ale śledzi to, czego potrzebujemy: jak prawdopodobne jest, że natywna lista zna produkt. Na jej podstawie wyprowadzamy wagę dla każdego języka gładką formułą, dając natywnej liście więcej wagi, im większy jest język, i zapisujemy wartości w małej tabeli w aplikacji.
Na 200 ocenionych zapytaniach niemieckich i ukraińskich efekt jest wyraźny dla niemieckiego, a dla ukraińskiego go nie ma (rysunek 4). MRR dla niemieckiego rośnie o .062 (95% przedział bootstrapowy różnicy +.030 do +.099), a pierwsze miejsce o 7 punktów, podczas gdy pierwsza piątka zyskuje 3 punkty, co mieści się w szumie. Ukraiński MRR spada o .002, bo jego nowe wagi są zbliżone do dawnych wspólnych. Zysk dla niemieckiego utrzymuje się w obu połowach zapytań, podzielonych na nieparzyste i parzyste.
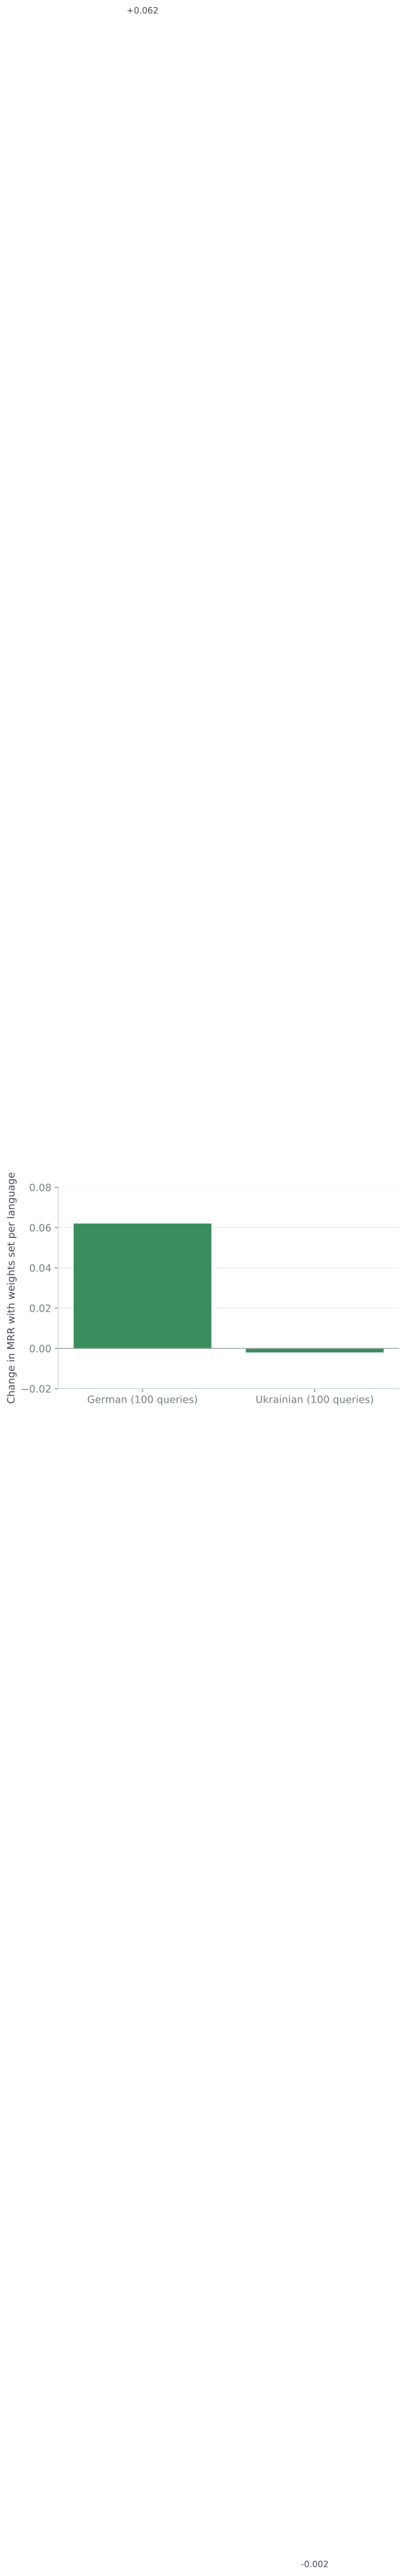
Stałe formuły ustawiono na tych samych zapytaniach, a wagi pozostałych języków wynikają z formuły i nie zostały zmierzone.
9. Literówki i formy wyrazów
Słownik zna dokładne formy wyrazów. Wyraz z literówką albo formę przypadka, której nie widział, przechodzi bez zmian i trafia do list angielskich jako słowo, które tam nic nie znaczy. Wyszukiwanie w naszej bazie lokalnej już naprawia literówki za pomocą indeksu SymSpell, czyli indeksu odległości edycyjnej, w którym dopuszczalna liczba edycji rośnie z długością wyrazu. Otwartym pytaniem był krok tłumaczenia, więc zmierzyliśmy, ile kosztują literówki i co daje zapasowe dopasowanie.
Krok 1: literówki i formy wyrazów, słowo po słowie
Przebudowaliśmy słowniki dziewięciu języków z naszych nazw i wzięliśmy z nazw odłożonych te wyrazy, których tłumaczenie jest znane. Każdy dostał jedną losową edycję (usunięta, wstawiona lub zamieniona litera albo zamiana dwóch sąsiednich liter). Wyszukiwanie w dopuszczalnej odległości edycji zwróciło tłumaczenie oryginalnego wyrazu dla 92.5% uszkodzonych wyrazów, wobec 0.3% dla dokładnego wyszukiwania. Gdy pierwsza litera musiała się zgadzać, jak może wymagać wyszukiwanie w lokalnej bazie, spadało to do 77%, bo błędy w pierwszej literze wtedy nie są wyłapywane.
Dla form wyrazów wzięliśmy odłożone wyrazy, których słownik nie zna, ale których rdzeń Snowball jest równy rdzeniowi znanego wyrazu (to głównie inny przypadek lub liczba znanego wyrazu). Odległość edycji dała poprawne tłumaczenie dla 55% z nich, wspólny początek wyrazu dla 63%, a ten sam rdzeń dla 69%. Końcówki przypadków często zmieniają kilka liter, czego limit edycji nie dopuszcza. Pozostałe nieznane wyrazy (marki, rzadkie słowa, liczby) są ryzykiem: odległość edycji odpowiada na jedną czwartą z nich i ma rację w jednej trzeciej odpowiedzi. Rdzeni używamy tylko przy wyszukiwaniu; w treningu obniżały jakość (sekcja 6).
Krok 2: zapasowe dopasowanie na prawdziwych słownikach
Słowniki w aplikacji pomijają słowa, które w obu językach są napisane tak samo, więc taki wyraz jest dla zapasowego dopasowania „nieznany”. Proste zapasowe dopasowanie zmieniało więc słowa, które były poprawne: pizza stawało się nicoise, pils stawało się mushroom, a marka Krönung stawała się curd. Na zapytaniach w zapisanej formie F1 słów tłumaczenia spadło o 3 punkty. Trzy zabezpieczenia usuwają większość szkód: słowo, które samo jest angielskim słowem słownika, zostaje bez zmian; bardzo krótkie wyrazy zostają bez zmian; a dopuszczalna odległość edycji jest mała. Kolejność jest taka: dokładne wyszukiwanie, ten sam rdzeń, jedna edycja. Z zabezpieczeniami strata na zapytaniach w zapisanej formie zmniejsza się do 1.5 punktu, a na zapytaniach z błędem F1 rośnie o 30 punktów.
Krok 3: całe wyszukiwanie
F1 słów porównuje tłumaczenie z wzorcem, a wyszukiwanie ma inne listy, które mogą pochłonąć złe tłumaczenie. Dlatego uruchomiliśmy całe wyszukiwanie, jak w sekcji 3, na 200 zapytaniach (100 niemieckich i 100 ukraińskich): w zapisanej formie oraz z jednym losowym błędem literowym w jednym wyrazie każdego zapytania (zmieniło się 195 zapytań). Każde zapytanie przetłumaczono na cztery sposoby: poprawnym tłumaczeniem (górna granica), słownikiem w dotychczasowej postaci, słownikiem z prostym zapasowym dopasowaniem i słownikiem z zabezpieczeniami. Cztery rankingi połączono wagami z aplikacji, a model językowy w ślepej próbie ocenił połączoną pulę najlepszych wyników.
| Tłumaczenie | Zapytania w zapisanej formie pierwsze / pierwsza piątka, punkty | Jeden błąd na zapytanie pierwsze / pierwsza piątka, punkty |
|---|---|---|
| Poprawne (górna granica) | +0.5 / −1.0 | +15.0 / +11.5 |
| Słownik, proste zapasowe dopasowanie | +1.5 / +1.0 | +8.5 / +4.5 |
| Słownik, zapasowe dopasowanie z zabezpieczeniami | +2.0 / +0.5 | +7.5 / +4.0 |
Tabela 2. Zmiana względem słownika w dotychczasowej postaci, w punktach udziału zapytań, w których właściwy produkt jest na pierwszym miejscu i w pierwszej piątce.
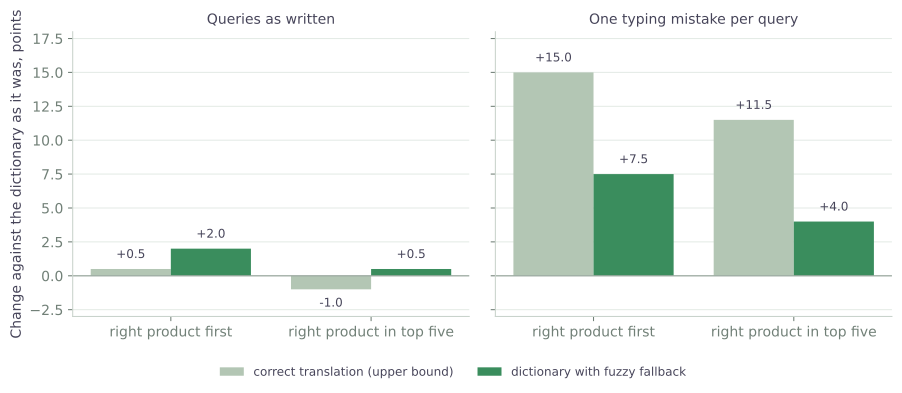
Przy zapytaniach w zapisanej formie słownik jest tak dobry jak poprawne tłumaczenie (o pół punktu za nim na pierwszym miejscu, o punkt przed nim w pierwszej piątce), a zapasowe dopasowanie nie zmienia niczego, co dałoby się wykryć (4 zapytania zyskane i żadne stracone na pierwszym miejscu, p = 0.13). Przy błędzie literowym słownik w dotychczasowej postaci traci 15 punktów na pierwszym miejscu; zapasowe dopasowanie z zabezpieczeniami odzyskuje 7.5 z nich (30 zapytań zyskanych, 15 straconych, p = 0.04) i 4 z 11.5 punktów w pierwszej piątce (11 zyskanych, 3 stracone, p = 0.06). Wyszukiwanie korzystające tylko z angielskiej listy Open Food Facts zyskuje znacznie więcej, o 22 punkty na pierwszym miejscu, bo nie ma natywnej listy, na którą mogłoby się oprzeć. Prosta i zabezpieczona wersja zapasowego dopasowania nie dają się rozróżnić w całym wyszukiwaniu; zostawiamy zabezpieczoną, bo zmienia mniej poprawnych słów. Zysk różni się między językami: ukraiński zyskuje 15 punktów na pierwszym miejscu, niemiecki żadnego, a nie sprawdzaliśmy dlaczego.
Krok 4: ograniczenia pomiaru
Błędy są syntetyczne: jedna losowa edycja w prawie każdym zapytaniu, znacznie częściej niż ludzie naprawdę się mylą, i bez błędów na sąsiednich klawiszach prawdziwej klawiatury. Dwieście zapytań i jeden model jako sędzia dają wartości p około 0.05, więc wynik dla literówek pokazuje kierunek, a dokładną wielkość trzeba zmierzyć na prawdziwych zapytaniach. Zysk na prawdziwe zapytanie to powyższy zysk razy udział zapytań z błędem, którego nie znamy; przy koszcie dla poprawnych zapytań bliskim zeru nawet niewielki udział się opłaca.
10. Co nie zadziałało albo nie było potrzebne
- Usunięcie lokalnej listy angielskiej. Na drugim zbiorze zapytań wersja bez niej nie była lepsza od wersji z czterema listami (pierwsza piątka o 2 punkty niższa, MRR o .015 niższy, w szumie), więc zachowaliśmy strukturę.
- Stemmowanie przed dopasowaniem. Standardowa rada dla języków z bogatą fleksją; w naszych testach obniżyło dokładność. Dokładne formy plus frazy działały lepiej.
- Bardzo duża waga par z taksonomii. Pomagała trochę na nieznanych słowach w dwóch językach, a traciła na znanych. Użyteczny zakres jest wąski i trzymamy się w nim.
- Pokrycie taksonomii jako waga listy. Mierzy jakość tłumaczenia w danym języku, a liczba produktów istniejących w tym języku to odrębna wielkość.
- Test, który nie widział efektu. Nasz pierwszy test taksonomii patrzył na słowa, które baza już znała, i sprawił, że taksonomia wyglądała na bezużyteczną. Wniosek: zanim zaufamy wynikowi zerowemu, pytamy, co dany test w ogóle może zobaczyć.
Jak używamy tego w MuscleTiger
Wyszukiwarka jedzenia w MuscleTiger działa tak, jak opisano: twoje zapytanie idzie do naszej bazy i do Open Food Facts, w twoim języku i po angielsku, tłumaczy je słownik, który znajduje się w telefonie, a cztery rankingi łączymy wagami zależnymi od twojego języka. Wyniki pokazujemy w języku interfejsu aplikacji, a produkty sprzedawane w twoim kraju są przed resztą. Słownik działa bez sieci, więc zapytanie na siłowni bez zasięgu nadal znajdzie jedzenie z naszej bazy lokalnej.
Wnioski
- Wyszukiwarka znajduje szukany produkt dla 92% zapytań. W teście całego wyszukiwania w dziewięciu językach jest on wśród pierwszych dziesięciu wyników dla 90% i na pierwszym miejscu dla 67%; pojedyncze produkty są znajdowane nieco częściej niż dania.
- Tłumaczenie na angielski to, co ma znaczenie. Przy poprawnych tłumaczeniach dodanie listy angielskiej podniosło udział zapytań ukraińskich, w których właściwy produkt jest w pierwszej piątce, o 61 punktów względem samego Open Food Facts po ukraińsku; kolejne języki zmieniały niewiele, a powyżej czterech obniżały pierwszą piątkę.
- Do zapytań o jedzenie mały słownik może wykonać pracę tłumacza. Dopasowanie słów na naszych własnych równoległych nazwach daje plik o rozmiarze kilkuset kilobajtów na język, działa offline i odtwarza nasze referencyjne tłumaczenia krótkich zapytań z F1 rdzeni wyrazów 0.94 do 0.96. To dokładność tłumaczenia prostych zapytań; dokładność wyszukiwania mierzymy osobno i jest ona niższa.
- Publiczne taksonomie pomagają najbardziej tam, gdzie nasze dane milczą. Trening słownika na nich poprawił tłumaczenie odłożonych rzadkich terminów o dwa do pięciu punktów w językach z dużą taksonomią, przy niewielkim koszcie dla częstych słów.
- Waga każdej listy może zależeć od wielkości języka w OFF. Dla niemieckiego ta zmiana podniosła MRR o .062 na naszych zapytaniach; dla ukraińskiego nic się nie zmieniło.
- Zapasowe dopasowanie na literówki się opłaca. Przy literówce pierwsze miejsce spada o 15 punktów, gdy tłumacz zna tylko dokładne formy, a zapasowe dopasowanie z zabezpieczeniami (ten sam rdzeń, potem mała odległość edycji) odzyskuje połowę tego; przy zapytaniach w zapisanej formie nie kosztuje nic, co dałoby się zmierzyć.
- Dopasowanie ważyło więcej niż języki. Ważenie słów rzadkością, rdzenie i jeden format liczb dały największy zysk całego badania.
Ograniczenia. Zapytania napisaliśmy my, a oceniał je model językowy, więc marginesy są szerokie (około punktów przy 200 zapytaniach). Liczby dotyczą niemieckiego i ukraińskiego; wagi pozostałych języków są ekstrapolowane. Nie porównywaliśmy się z neuronowym tłumaczem ani z innymi aplikacjami. Następnym krokiem jest sprawdzenie na prawdziwych zapytaniach użytkowników.
Dane i licencje
Dane o produktach i taksonomie pochodzą z Open Food Facts, udostępnionych na licencji Open Database Licence (ODbL); słowniki opisane tutaj częściowo pochodzą z taksonomii OFF i noszą to samo oznaczenie autorstwa. Nasza baza lokalna powstała z otwartych narodowych tabel składu żywności publikowanych przez władze publiczne; ich źródła i licencje są podane w aplikacji. Dziękujemy współtwórcom Open Food Facts i opiekunom narodowych tabel.
Źródła
- Brown PF, Della Pietra SA, Della Pietra VJ, Mercer RL. The mathematics of statistical machine translation: parameter estimation. Computational Linguistics 1993;19(2):263–311. ACL Anthology
- Moore RC. Improving IBM word-alignment Model 1. Proceedings of ACL 2004:518–525. ACL Anthology
- Cormack GV, Clarke CLA, Büttcher S. Reciprocal rank fusion outperforms Condorcet and individual rank learning methods. Proceedings of SIGIR 2009. doi:10.1145/1571941.1572114
- Darwish K, Oard DW. Probabilistic structured query methods. Proceedings of SIGIR 2003.
- Dyer C, Chahuneau V, Smith NA. A simple, fast, and effective reparameterization of IBM Model 2. Proceedings of NAACL-HLT 2013:644–648. ACL Anthology
- Open Food Facts: taxonomies of ingredients and categories and product data, world.openfoodfacts.org, under the Open Database Licence (ODbL).
- Riley D, Gildea D. Improving the IBM alignment models using variational Bayes. Proceedings of ACL (short papers) 2012:306–310. ACL Anthology
- Östling R, Tiedemann J. Efficient word alignment with Markov chain Monte Carlo. The Prague Bulletin of Mathematical Linguistics 2016;106:125–146.
- Mermer C, Saraçlar M. Bayesian word alignment for statistical machine translation. Proceedings of ACL (short papers) 2011:182–187. ACL Anthology
- Jalili Sabet M, Dufter P, Yvon F, Schütze H. SimAlign: high quality word alignments without parallel training data using static and contextualized embeddings. Findings of EMNLP 2020.